


Python模块导入时from module import *怎么受下划线影响

在 Python 中使用 from module import * 进行通配符导入时,下划线命名直接决定了模块内的哪些标识符会被导出到当前命名空间。默认情况下,所有以单下划线(_)或双下划线(__)开头的变量、函数和类都会被解释器自动忽略,只有不带前导下划线的公开标识符才会被导入。然而,如果模块中显式定义了 __all__ 列表,解释器就会完全以该列表为准,此时下划线的默认过滤规则将被覆盖。理解下划线在通配符导入时的行为机制与边界,是规范设计 Python 模块接口与管理命名空间的重要一环。
一、默认规则:下划线如何阻隔通配符导入
当一个模块没有显式声明 __all__ 属性时,Python 解释器在处理 from module import * 时会执行一项内置的过滤策略:遍历该模块全局字典中所有以字符串形式存在的名称,凡是第一个字符为下划线 _ 的项,一律排除在导入列表之外。
这里的过滤并不区分单下划线还是双下划线。无论是作为内部实现约定的 _helper_func,还是具备名称改写特性的类级私有名称、亦或是模块内置的魔术属性如 __name__、__doc__,只要名称以 _ 开头,通配符导入都不会将它们复制到调用方的命名空间中。
# 文件名: network_utils.py
# 未定义 __all__ 的基础模块

DEFAULT_TIMEOUT = 30           # 公开常量

def fetch_data(url):           # 公开函数
    return _build_connection(url)

def _build_connection(url):    # 单下划线前缀:内部辅助函数
    return f"Connecting to {url}..."

_INTERNAL_CACHE = {}          # 单下划线前缀:内部状态字典
__author__ = "Developer"       # 双下划线前缀:模块元数据
现在我们在另一个脚本中通过 from network_utils import * 进行导入:
# 文件名: main.py
from network_utils import *

# 正常调用:公开变量与函数成功导入
print(DEFAULT_TIMEOUT)         # 输出示例: 30
print(fetch_data("api.io"))   # 输出示例: Connecting to api.io...

# 尝试访问带下划线的名称将抛出 NameError 异常
try:
    print(_build_connection("api.io"))
except NameError as e:
    print(f"导入失败: {e}")      # 输出示例: 导入失败: name '_build_connection' is not defined

try:
    print(_INTERNAL_CACHE)
except NameError as e:
    print(f"导入失败: {e}")      # 输出示例: 导入失败: name '_INTERNAL_CACHE' is not defined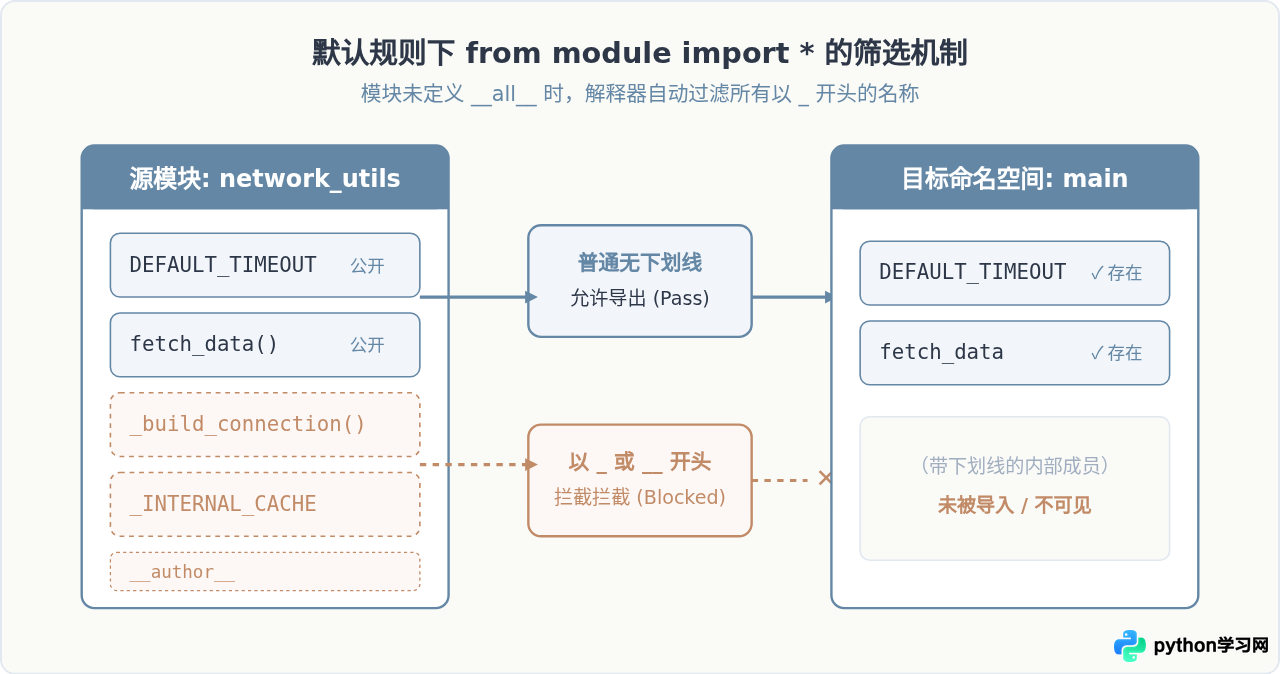
二、优先级反转:__all__ 如何覆盖下划线机制
虽然单下划线前缀是约定俗成的内部私有标识,但在 Python 语法设计中,模块的白名单机制 __all__ 拥有更高的执行优先级。一旦模块作者在模块顶层定义了包含字符串的列表或元组 __all__,通配符导入就会彻底停用默认的“过滤前导下划线”逻辑,转而严格按照 __all__ 中列出的名称进行导入。
这会带来两个显著的现象:
- 强制导出下划线名称:如果
__all__中显式写明了某个单下划线开头的函数或变量,通配符导入就会毫无保留地将其引入调用方命名空间。 - 未列出的普通名称被阻断:即使某个名称完全没有下划线前缀,只要它不在
__all__中,执行from module import *时同样不会被导入。
# 文件名: custom_api.py
# 显式定义 __all__ 覆盖默认规则

__all__ = ["_special_eval", "public_service"]

def public_service():
    return "Public service running"

def unlisted_service():
    return "This service is public in name, but not in __all__"

def _special_eval():
    return "Special internal evaluation function"
在另一个文件中进行通配符导入测试:
# 文件名: test_all.py
from custom_api import *

# 1. 成功调用:虽然带下划线,但因为存在于 __all__ 中,被强制导入
print(_special_eval())         # 输出示例: Special internal evaluation function

# 2. 成功调用:在 __all__ 中声明的公开函数
print(public_service())        # 输出示例: Public service running

# 3. 失败报错:没有下划线,但因未列入 __all__ 而无法通过 * 导入
try:
    print(unlisted_service())
except NameError as e:
    print(f"导入失败: {e}")      # 输出示例: 导入失败: name 'unlisted_service' is not defined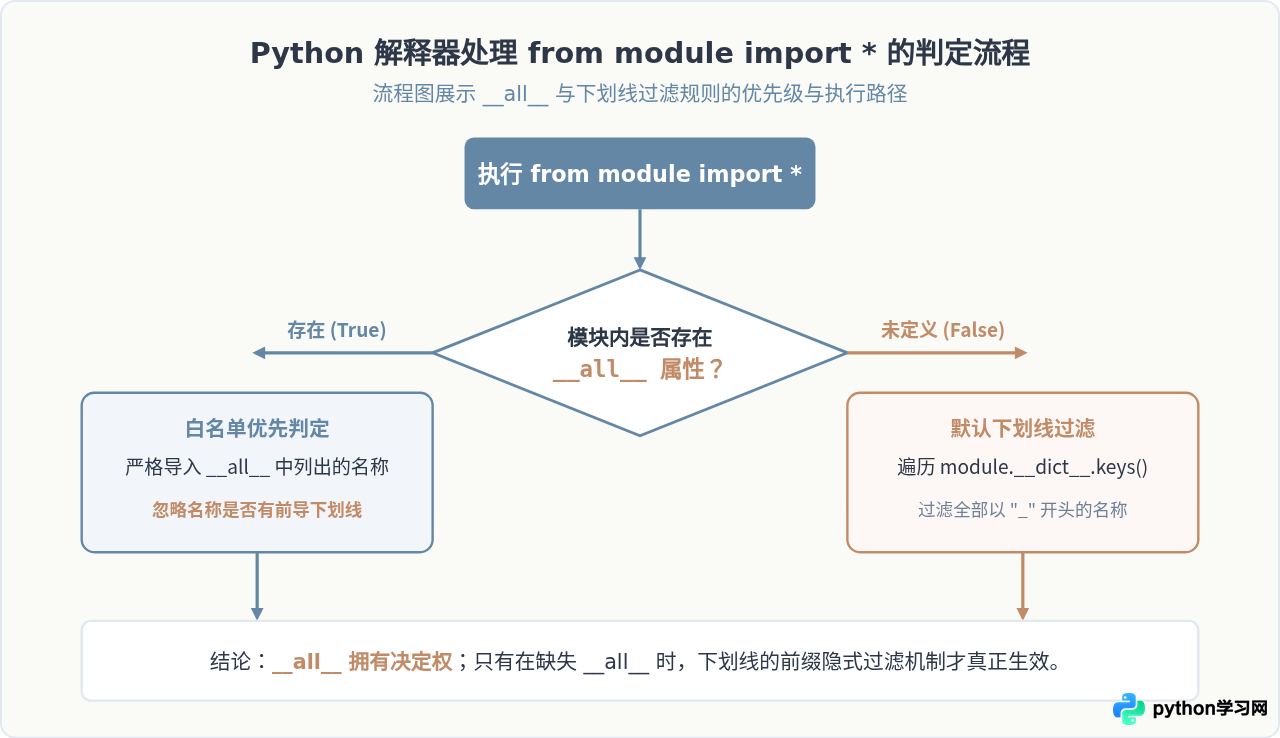
三、核心边界:下划线不是真正的私有权限限制
初学者容易产生一个误解,认为加了下划线的函数或属性如同 C++ 或 Java 中的 private 一样无法被外部访问。实际上,Python 的下划线只是一种代码层面的约定(Convention)与 import * 的过滤机制,并不提供语言级的强行访问阻断。
我们可以通过不同的导入语法来验证下划线变量的访问边界:
- 普通导入(
import module):完全不受下划线影响。模块作为一个命名空间对象被载入,通过module._name可以正常读取和调用带下划线的成员。 - 显式具名导入(
from module import _name):完全不受下划线阻拦。由于开发者明确指定了名称,解释器认为这是有意为之,直接将其引入当前作用域。 - 通配符导入(
from module import *):受下划线直接影响。只有在这个特定语法下,下划线才会作为过滤器拦截未授权的名称批量导出。
# 场景对比演示
import network_utils

# 方式一:直接通过模块属性访问(完全不受阻)
print(network_utils._build_connection("internal.db")) # 正常执行!

# 方式二:明确按名称导入(完全不受阻)
from network_utils import _build_connection
print(_build_connection("direct.call"))               # 正常执行!

# 方式三:通配符导入(唯一被下划线阻断的方式)
# from network_utils import *
# _build_connection(...) 会抛出 NameError 异常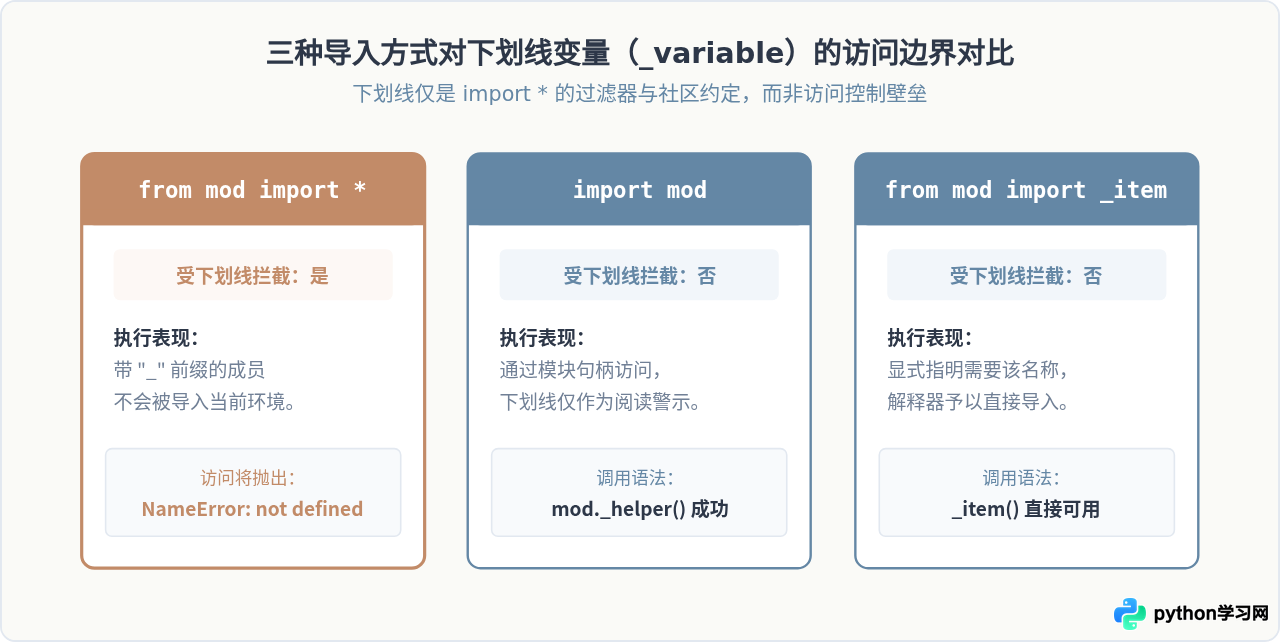
四、为什么通配符导入会有这种机制与最佳实践
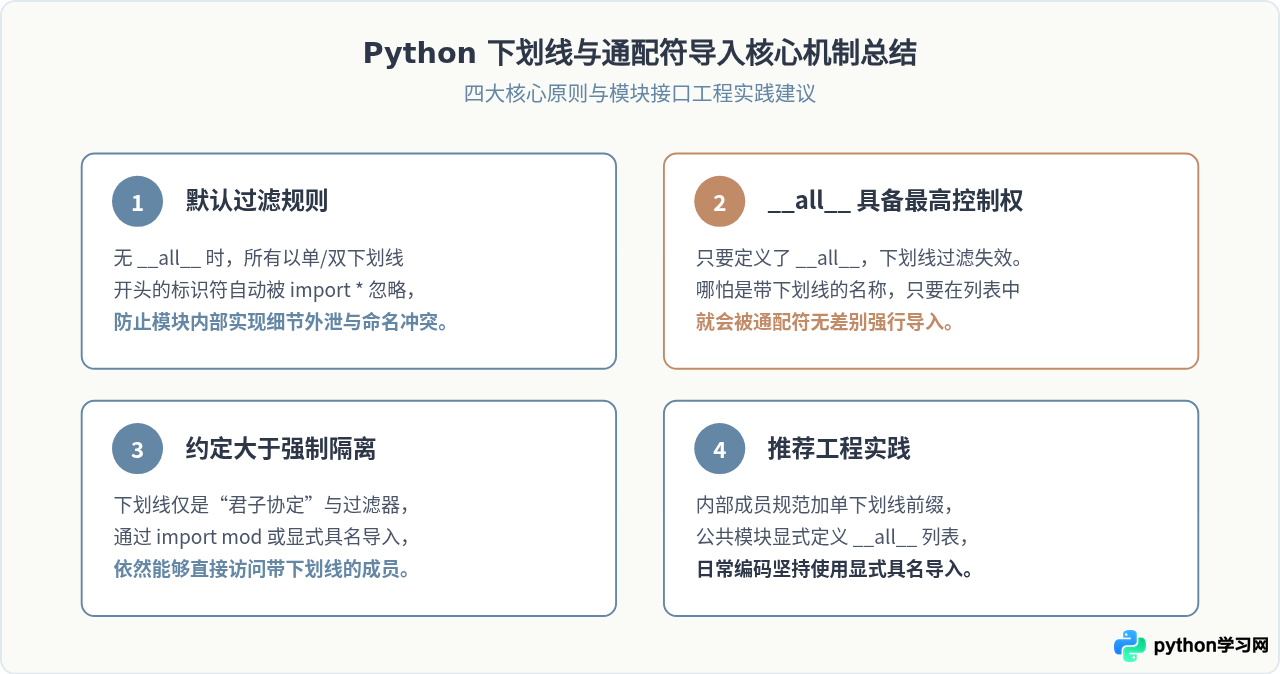
Python 之所以为 from module import * 设计下划线过滤机制,核心目的是为了减少命名空间污染与意外覆盖。在大型工程中,如果每次执行通配符导入都把模块内的各种临时计算变量、导入的第三方依赖和内部辅助函数悉数倾倒进当前脚本,不仅会导致变量覆盖灾难,还会使得代码排查变得极其困难。
from module import *。通配符导入不仅会模糊变量的真实来源,还会降低静态分析工具(如 flake8、mypy)的检测精度。
为了使模块的对外接口清晰易维护,建议遵循以下设计原则:
- 明确内部实现:对于不需要外部直接依赖的辅助函数、缓存容器或配置项,主动添加单下划线前缀(如
_parse_args、_CACHE),传达“这是实现细节,可能在后续版本随时重构”的信号。 - 公开 API 显式声明
__all__:在编写库或公共模块时,始终提供__all__清单。这样即便下游使用者不慎使用了import *,也只能导入你期望暴露给公众的稳定接口。 - 调用端坚持显式导入:使用
import module或者from module import func_a, func_b,保证每个被引用的标识符在文件中都有迹可循。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















