


精选Python学习资源:适合不同阶段的书籍、文档与实战项目推荐

学好Python的关键不是囤积几百G的网盘视频或买齐各大畅销书,而是在不同认知阶段选择信息密度匹配的学习媒介。初学重在建立执行反馈与语法直觉,进阶重在理解底层数据模型与语言特性,工程化阶段则聚焦架构范式与可靠性保障。本文将学习周期拆解为新手起步、深入进阶与工程架构三个梯度,按书籍、官方核心文档与实战项目三条主线给出具体选型与使用建议。
一、Python系统学习的三阶段演进路径
很多学习者容易陷入“教程地狱”:基础语法的循环与列表推导式反反复复看了三四遍,一旦面对一个空文本编辑器依然不知如何下手。这往往是因为资源选择脱离了当下真实的思维瓶颈。
为了让学习动作具备明确的预期结果,我们将整个Python掌握历程划分为具有清晰输入输出标准的三个发展阶段。每个阶段对应不同的思维跨越与关键产出物:
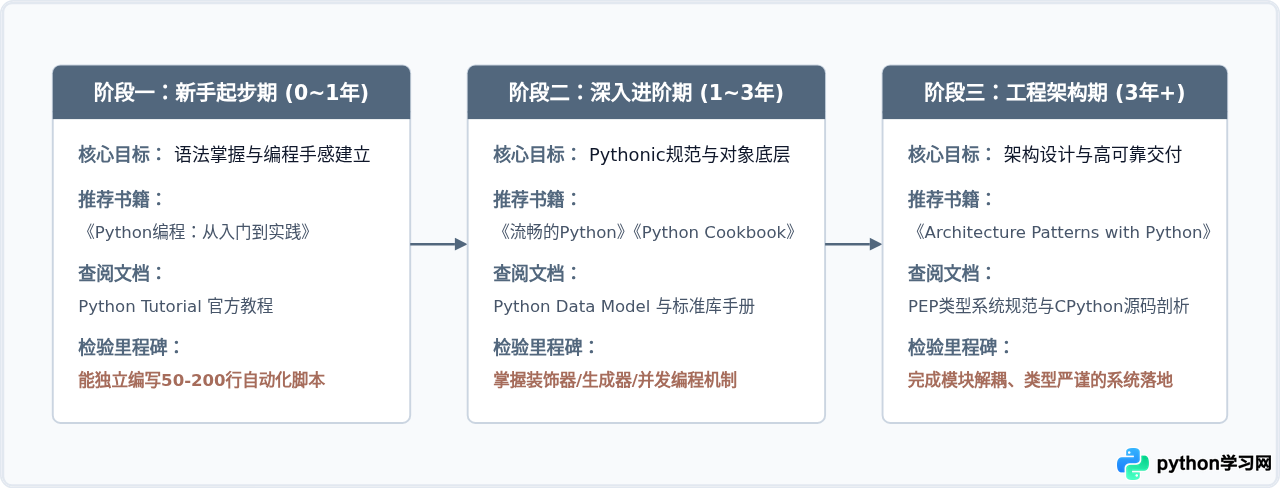
二、阶段一:新手起步期(0到1年)——建立直觉与即时反馈
初学阶段最忌讳的是直接啃800页的百科全书式大部头。新手最稀缺的资源不是知识,而是持续写代码的正向反馈。
1. 核心推荐书籍
-
《Python编程:从入门到实践》(第3版)—— Eric Matthes
定位与价值:适合完全没有计算机背景或跨行自学的读者。全书分为两部分,前半部分以精炼平实的语言讲解变量、列表、字典、用户输入、while循环、函数、类与异常;后半部分提供三个完整的实践小项目(外星人入侵2D小游戏、数据可视化、简易Web应用)。
学习方法:读前半部分时,坚持每一小段代码都在本地Python环境中手动键入,遇到报错尝试阅读Traceback回溯信息,切勿复制粘贴。 -
《“笨办法”学Python 3》—— Zed Shaw
定位与价值:全书以52个刻意练习题组成,核心主张是通过反复输入、排错和修改,建立敲代码的肌肉记忆。适合自控力较弱、容易被繁复理论劝退的初学者。
2. 官方文档查阅重点
新手不要尝试通读全套官方文档,应有针对性地掌握两个核心模块:
- 《The Python Tutorial》(官方教程):由Python核心设计者编写,语言准确度极高,重点通读第3节(非正式介绍)、第4节(深入控制流)与第5节(数据结构)。
- 内置函数清单(Built-in Functions):把官方文档中的
len(),range(),enumerate(),zip(),isinstance(),sorted()等常用内置函数的参数说明逐一阅读并写出两行测试代码。
3. 对应起步实战项目
新手阶段建议落地的项目清单
- 本地文件批量整理器:使用标准库
pathlib和shutil,扫描下载目录,自动根据文件后缀(.pdf, .jpg, .zip)分类移动到不同归档文件夹中。 - 控制台记账小工具:支持输入每笔消费的时间、类别与金额,使用
csv或json模块持久化存储到本地,并能输出当月总支出与分类汇总。 - 轻量级静态网页抓取:利用第三方库
requests和BeautifulSoup4,抓取公开图书榜单或天气预报网页,提取标题并存为格式化文本。
三、阶段二:深入进阶期(1到3年)——掌握Pythonic表达与底层机制
当已经能写出几百行代码解决日常脚本问题时,通常会遇到第二个瓶颈:代码虽然能跑,但结构散乱,习惯把Java或C++的思维生搬硬套到Python中,充斥着大量的显式下标遍历和冗余类定义。这个阶段的核心目标是掌握“Pythonic”的惯用表达,并理解背后的数据模型。
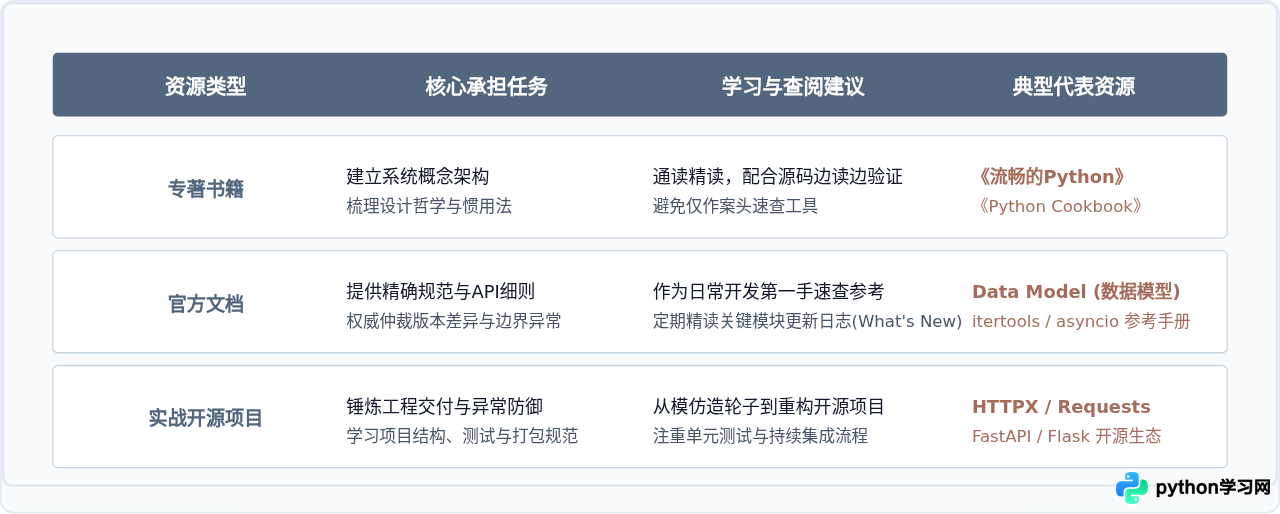
1. 核心推荐书籍
-
《流畅的Python》(Fluent Python,第2版)—— Luciano Ramalho
定位与价值:公认的Python进阶圣经。全书深度剖析Python的数据模型(Data Model)、特殊方法(魔术方法__getitem__,__repr__等)、序列与字典的底层哈希表原理、闭包与装饰器、协程与异步编程。第2版全面更新了类型提示(Type Hints)与asyncio现代模式。
使用建议:不要追求两周速读,建议每次精读一章,重点搞懂“为什么Python会这样设计”。 -
《Python Cookbook》(第3版)—— David Beazley, Brian K. Jones
定位与价值:全书汇集了数百个高质量代码食谱,覆盖数据结构、字符串算法、迭代器、文件I/O、元编程、并发网络等领域。每一小节都遵循“问题—解决方案—讨论”的模式,代码范例堪称工业级范本。
使用建议:在日常遇到特定开发需求(如需要编写带参数的装饰器、自定义元类或实现高效文件解包)时,先翻阅本书对应章节,对比自己的实现与作者的优化范式。
2. 官方文档查阅重点
进入进阶期后,官方文档应当成为日常写代码时的第一常驻窗口,重点攻坚以下三个模块:
- Python Data Model(数据模型参考手册):这是《流畅的Python》一书的思想源泉。通读该文档能够彻底明白Python的一切对象协议(序列协议、迭代器协议、上下文管理器协议
__enter__/__exit__、描述符协议__get__/__set__)。 collections与itertools标准库文档:深入了解defaultdict,Counter,deque, 以及itertools.chain(),groupby(),islice()的底层表现,避免自己在业务中写出低效的二重嵌套循环。asyncio与并发编程文档:搞清事件循环(Event Loop)、协程任务(Task)与Future对象的协作流程,准确区分 CPU 密集型任务(使用multiprocessing/concurrent.futures.ProcessPoolExecutor)与 I/O 密集型任务(使用asyncio)。
3. 进阶实战项目推荐
进阶实战:从简单脚本向高质量模块迈进
- 生产级CLI命令行工具:使用现代库
Typer或Click编写一个支持子命令、参数验证、进度条展示与高亮着色输出的本地开发者工具(例如自动化项目脚手架生成器)。 - 基于
asyncio的高并发异步下载引擎:利用aiohttp或httpx,实现支持并发度限制(asyncio.Semaphore)、断点续传、失败指数退避重试与实时吞吐量统计的文件下载器。 - 自己实现一个简易依赖注入容器或ORM原型:利用Python的描述符机制(Descriptor)和反射机制(
getattr,setattr),实现一个能够将Python类字段与SQLite数据表映射的微型ORM框架,这能彻底加深对元类与属性访问协议的理解。
四、阶段三:工程化与架构期(3年以上)——构建稳健可维护的工业级系统
在大型生产系统或团队协作中,代码的可维护性、类型安全、架构分层以及自动化测试能力,远远比单纯写出精巧代码更为关键。
1. 核心推荐书籍
-
《Architecture Patterns with Python》(Cosmic Python)—— Harry Percival, Bob Gregory
定位与价值:解决“当Python项目变大之后如何保持不崩塌”的核心痛点。全书将领域驱动设计(DDD)、仓储模式(Repository Pattern)、工作单元(Unit of Work)以及事件驱动架构与依赖倒置(Dependency Inversion)在Python现代生态中落地,配有大量真实、干净的代码实现。
适用对象:负责中大型后台服务、微服务或复杂数据流架构的资深开发者。 -
《Effective Python》(第2版,90个编写高质量Python的实践建议)—— Brett Slatkin
定位与价值:由Google主任软件工程师撰写,90个小节独立成篇,直击工程实践中的隐藏暗坑(例如生成器共享状态陷阱、类型注解边界、元类与类装饰器权衡、性能分析调优等)。
2. 官方文档与PEP规范精读
在工程化阶段,应当跳出基础库API手册,直接精读推动Python语言进化的PEP(Python Enhancement Proposals,Python增强提案):
- PEP 8:代码风格指南(结合现代工具
Ruff执行自动化检查)。 - PEP 484 & PEP 585:类型注解系统(Type Hints)与泛型规范。精读
typing标准库文档,熟练使用Protocol(结构子类型化/鸭子类型形式化)、TypeVar、ParamSpec与Generic。 - PEP 557:数据类(Data Classes)与标准不可变对象定义。
- CPython内部实现与扩展机制:理解引用计数(Reference Counting)、分代垃圾回收(Generational GC)以及 Python 3.12+ 逐渐优化的解释器性能特性(如 Per-Interpreter GIL)。
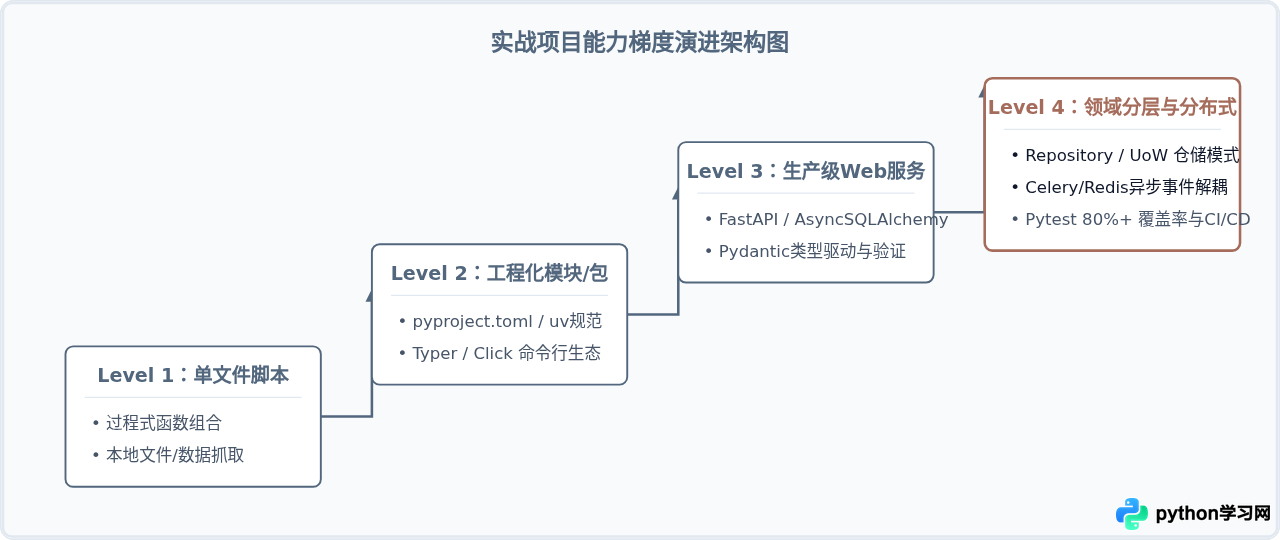
3. 高阶实战项目推荐
工程化实战:建立规范的工程交付链
全功能现代化后台服务:
- 框架:FastAPI + Pydantic v2 + SQLAlchemy 2.0 (Async) + Alembic 数据库迁移。
- 任务调度:Celery + Redis 异步解耦高耗时任务。
- 质量保证:使用
pytest编写端到端单元测试与集成测试,覆盖率达到80%以上;使用mypy或pyright执行严格模式下的静态类型检查;使用ruff实现毫秒级代码格式化与规范检查;集成 GitHub Actions 完成自动化 CI 构建。
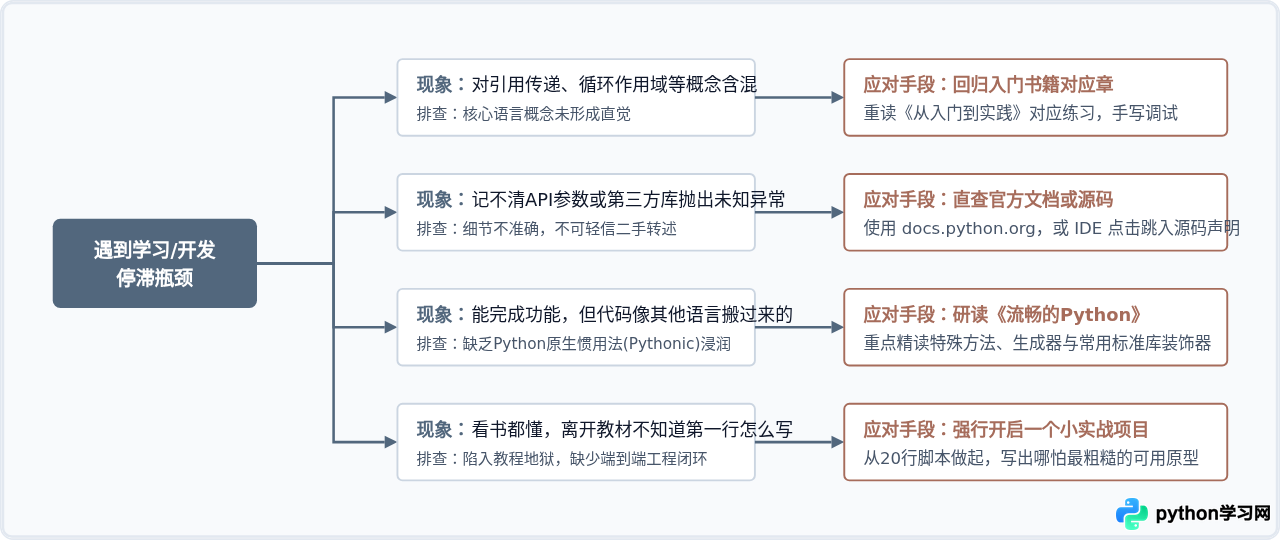
五、遇到学习瓶颈时的资源选择决策指南
在实际学习和编码过程中,许多开发者都会遭遇卡壳。遇到问题时,如果选错解决手段,会浪费大量时间却收效甚微。
六、避开常见选型误区与高效实践准则
在整合运用这些资源时,保持正确的实践纪律与警惕常见误区同样关键:
避坑准则 1:杜绝“只看不敲”与“教程地狱”
技术书不是小说,如果连续阅读两章而没有在本地交互式终端(IPython 或 REPL)中输入验证哪怕一段示例,这种阅读效率极低。理想的时间分配应当是:30%时间阅读与吸收概念,70%时间用于写测试用例、排错与实现原型。
避坑准则 2:警惕过时第三手博文的误导
Python 3.10 引入了结构化模式匹配(match/case),Python 3.11 大幅提升了运行期性能,Python 3.12 引入了更清爽的泛型语法(PEP 695)与新的 f-string 语法解析。网络上很多未标明日期的旧博文依旧充斥着过时的 pip 依赖解决方式或废弃的模块用法。在涉及语法规范与标准库时,务必以 docs.python.org 官方文档所标注的当前版本为准。
避坑准则 3:开源项目的选型原则
想要通过阅读开源项目学习代码结构时,不要直接去翻 Django 或 CPython 这种数百万行的超巨型项目,这极易产生挫败感。优先寻找满足以下条件的开源库:
- 核心代码在 1000~5000 行之间(例如
requests,bottle,click,itsdangerous)。 - 具备完善的
tests/目录,可以通过阅读测试用例直接理解每个模块的预期行为。 - 项目根目录下拥有清晰的现代工程配置文件(如
pyproject.toml)。
结语
学习Python并不是一场比拼谁掌握函数最多的记忆力竞赛,而是逐步建立起用计算机思维分解并解决实际问题的过程。在新手期用《从入门到实践》与动手脚本建立正向反馈,在进阶期借《流畅的Python》与官方数据模型手册吃透语言哲学,在工程期依循领域模式与高质量开源生态构建健壮交付标准。对照当下的认知边界精准选择资源,循序渐进,便能走出反复重学语法的循环,真正掌握这门兼具灵活性与工程强度的编程语言。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















