


怎么判断Python是否入门:脱离教程依赖的3个自测标准

一、为什么“能看懂教程”不等于“已经入门”
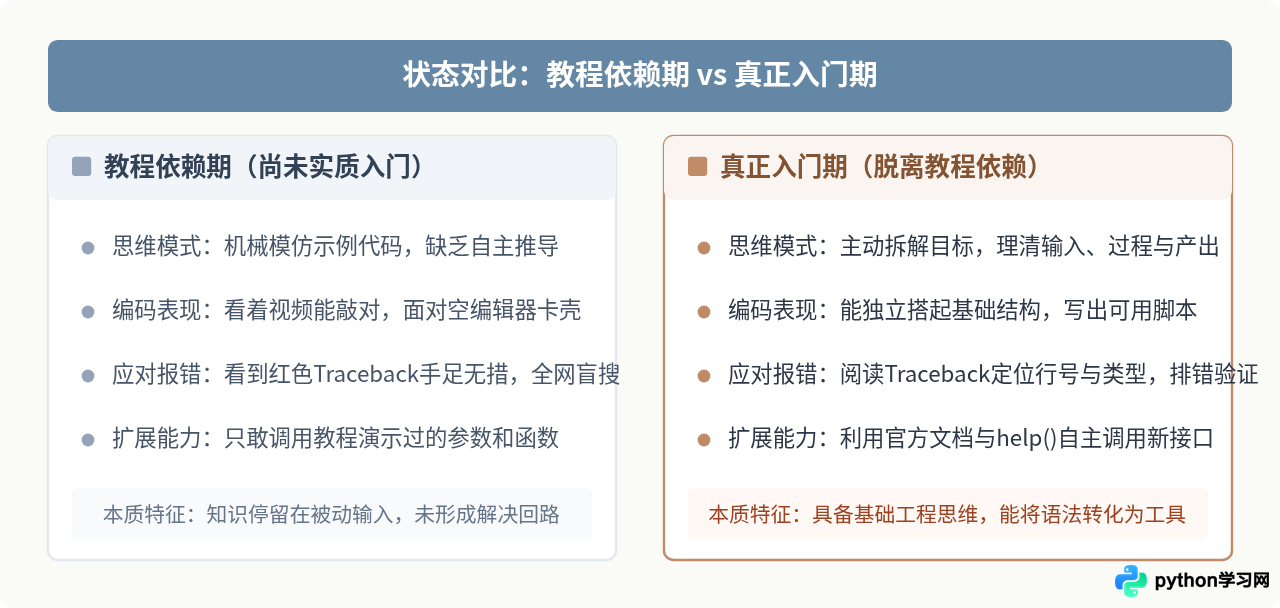
很多初学者在学习 Python 时都会经历一个共同的困惑:跟着视频敲代码时一切顺利,案例运行完美;可一旦视频播放结束,想自己写一个简单的小脚本,屏幕前却只剩下一片空白,完全不知从何下手。这种现象在编程学习中被称为“教程依赖”(Tutorial Hell)。
教程依赖的本质,是被动接受与主动建构之间的鸿沟。观看教学视频或阅读手把手教程时,作者已经完成了最核心的工作:将模糊的需求拆解成清晰的逻辑步骤,并规避了所有潜在的语法陷阱与环境报错。读者在跟着敲代码的过程中,调动的主要是打字和语法识记能力,并未真正锻炼到编程中最关键的工程决策力。要判断自己是否跨过了入门门槛,就需要检验自己是否具备独立闭环的能力。
二、自测标准一:能否独立将实际需求拆解为程序逻辑
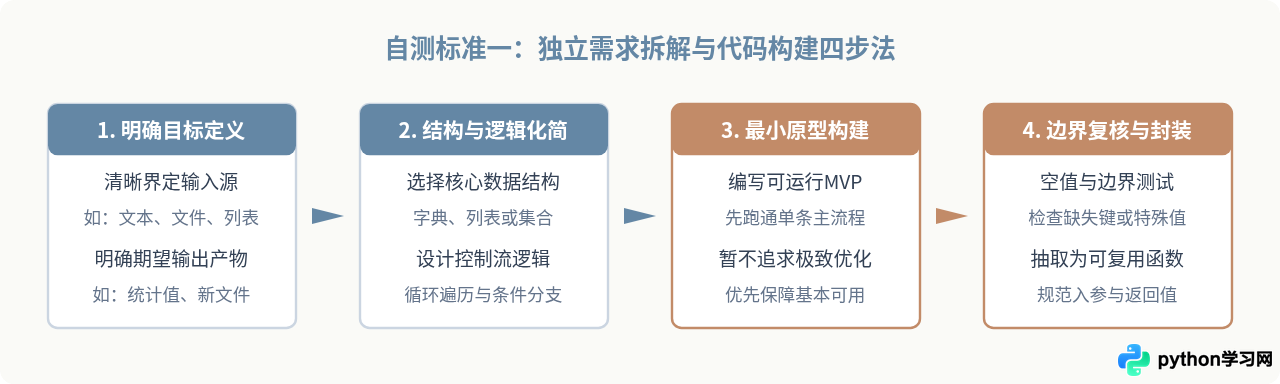
第一个核心标准,是考验你面对一个没有现成代码的真实小需求时,能否在脑海中完成“需求翻译”。编程不是背诵语法,而是将自然语言描述的现实问题,逐步拆解为输入、数据结构、控制流与输出。
例如,面对这样一个需求:“统计一个文本文件里每个单词出现的频率,并按出现次数由高到低打印出前5名”。尚未入门的学习者往往会第一时间去搜索引擎搜索整句“Python怎么统计词频排序”,并试图直接复制一段现成代码;而已经入门的学习者则会迅速在脑海中完成分解:
- 输入环节:使用内置的
open()函数读取文件内容为字符串; - 清洗环节:统一转为小写,处理标点符号,通过
split()拆分成单词列表; - 统计环节:选用字典(
dict)作为容器,遍历列表进行计数累加; - 排序与输出:将字典的项按值排序,截取前5项打印输出。
自测实操示例:词频统计的小型实现
检验标准很简单:在没有任何参考的情况下,你是否能用几十行基础代码自主写出如下功能的脚本?代码不需要用高深技巧,能清晰表达逻辑即为及格:
# 运行环境:Python 3.8+ 纯原生环境
def count_top_words(text: str, top_k: int = 5):
    # 1. 基础清洗与分割
    cleaned_text = ""
    for char in text:
        if char.isalnum() or char.isspace():
            cleaned_text += char.lower()
        else:
            cleaned_text += " "

    words = cleaned_text.split()

    # 2. 核心逻辑:利用基础字典统计频次
    freq_map = {}
    for word in words:
        freq_map[word] = freq_map.get(word, 0) + 1

    # 3. 结果排序与截取
    sorted_words = sorted(freq_map.items(), key=lambda item: item[1], reverse=True)
    return sorted_words[:top_k]

# 测试数据示例
sample_text = "Python is great. Python is dynamic, and python is easy to learn."
print(count_top_words(sample_text, top_k=3))
# 示例输出:[('python', 3), ('is', 3), ('great', 1)]三、自测标准二:能否读懂Traceback并自主排查修复错误
编程中有一半以上的时间是在与错误和异常打交道。初学者与入门者最显眼的分别,就是对待终端里那几行红色报错(Traceback,回溯跟踪信息)的态度。
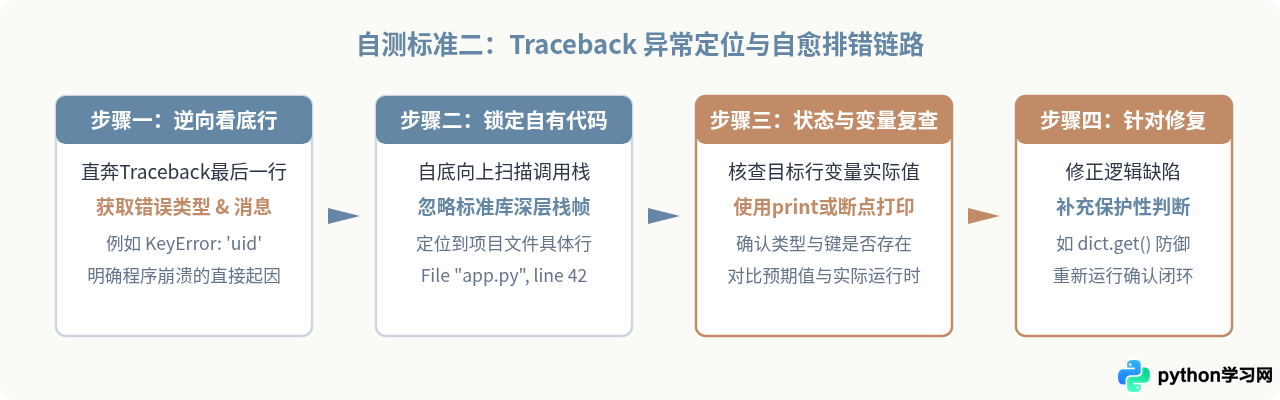
未入门的学习者看到报错常常会产生心理防御,下意识觉得“代码崩溃了、我学不会”,然后一股脑把整段报错复制粘贴到搜索框里碰运气。而真正入门的学习者明白:Traceback 是 Python 解释器在告诉你事故发生的精确坐标和直接死因。
自测诊断:常见四类异常的自主解读
能否在3秒内辨识出以下常见异常的原因与排查方向?
TypeError: unsupported operand type(s) for +: 'int' and 'str'—— 两个类型不匹配的数据试图相加,很可能是从文件或input()读出的数字尚未用int()转换;KeyError: 'score'—— 试图通过字典键访问值,但该键在当前字典中不存在,应检查拼写或使用.get('score', 0)做安全读取;IndexError: list index out of range—— 访问列表的索引超出了现有元素范围,往往发生在空列表访问或循环边界条件设置有误;AttributeError: 'NoneType' object has no attribute 'group'—— 正则匹配或查询操作未找到结果返回了None,随后直接调用方法导致崩溃。
# 演示排查过程的典型场景
def get_user_age(user_info: dict) -> int:
    # 模拟潜在故障点:外部传入数据结构不可靠
    raw_age = user_info["profile"]["age"]
    return int(raw_age)

# 若执行: get_user_age({"name": "Alex"})
# 终端输出:
# Traceback (most recent call last):
#   File "script.py", line 3, in get_user_age
#     raw_age = user_info["profile"]["age"]
# KeyError: 'profile'

# 入门者的自愈重构:使用保护性获取
def safe_get_user_age(user_info: dict) -> int:
    profile = user_info.get("profile")
    if not isinstance(profile, dict):
        return 0
return int(profile.get("age", 0))print() 或断点查看变量当前的状态,独立把代码修复。
四、自测标准三:能否通过查阅官方文档或内置帮助使用陌生模块
没有任何教程能够讲解完 Python 浩如烟海的标准库与第三方库。教程的作用仅仅是带你建立对语言特性的宏观认知。因此,脱离教程依赖的第三个自测标准,就是具备“自我扩充知识”的能力。
很多初学者在需要处理 CSV 文件、JSON 序列化或操作文件路径时,必须重新打开教程寻找“CSV教程第一课”;而入门学习者则会直接在终端或交互式环境中,利用 Python 的自省机制与官方文档快速上手。
自检武器:Python 内置的内省利器
在不打开任何网页浏览器的情况下,你是否习惯在 Python 交互式环境中探索模块?
dir(module_or_object):列出该对象支持的所有属性与方法名;help(func_or_class):直接打印出该函数或类的官方 docstring 说明、参数签名与默认值;type(obj):实时确认运行时对象的数据类型。
# 在 Python REPL 交互式终端中快速探索内置模块
import json

# 查看 json 模块提供的所有公开函数
print([name for name in dir(json) if not name.startswith('_')])
# 输出: ['JSONDecodeError', 'JSONDecoder', 'JSONEncoder', 'dump', 'dumps', 'load', 'loads']

# 想要了解 dumps 函数的具体参数与用法,直接调用 help
# help(json.dumps)
# 会清晰显示: dumps(obj, *, skipkeys=False, ensure_ascii=True, indent=None, ...)
当你学会在 dumps() 中使用 indent=4 来美化输出,或者设置 ensure_ascii=False 来正常显示中文,并且这个知识点不是来自视频的灌输,而是你自己在阅读 help() 文档或官方文档参数列表时主动发现的,就标志着你已经拥有了无限扩展技能边界的独立学习力。
五、自测总结与跨越进阶的实用建议
回顾上述三个自测标准,它们分别对应了现代软件工程中最核心的三项基础素质:
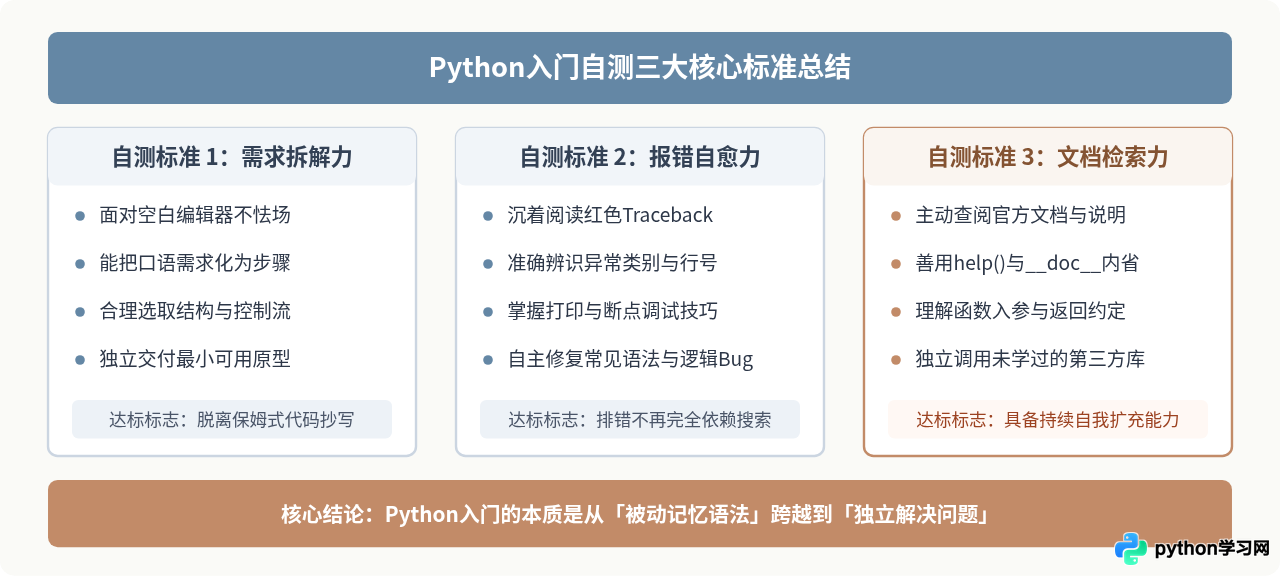
如果你在自测中发现自己在某一个或几个维度依然感到吃力,不必感到沮丧,这说明你找到了接下来最值得投入精力突破的关键节点。建议在日常学习中采取以下三种行动方式:
- 强制实施“微型项目驱动”:停止无休止地刷基础语法课,转而寻找自己日常生活中的小需求(例如批量重命名文件夹里的照片、整理下载目录里的杂乱文件、自动抓取天气预报),逼迫自己在空白编辑器中完成构思与编写;
- 刻意练习排错阅读:下次再遇到报错提示时,强迫自己先仔细通读最后两行信息,猜测可能的原因并在纸上记录下来,再去代码中打断点验证,而不是第一时间切换到搜索软件;
- 关闭二手教程,优先查阅官方文档:遇到不熟悉的模块时,先逼自己阅读官方 Docs 的 Quickstart 章节或直接在终端使用
help()探索,逐渐建立对第一手技术资料的阅读亲近感。
当你能够在没有他人指导的情况下,把一个从未做过的小想法变成能够稳定运行的几行脚本时,你就已经真正迈过了 Python 的入门门槛。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















