


Python列表与字典操作基础:零基础数据存储与查询技巧

一、列表(List):顺序存储与位置查询
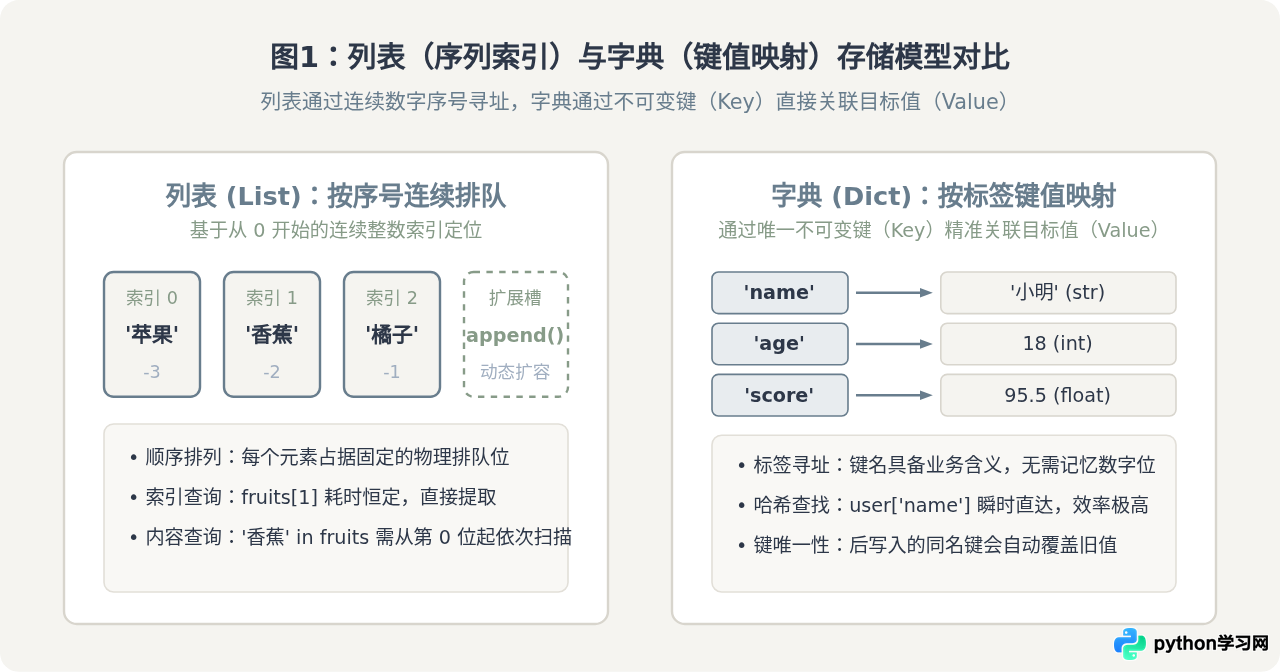
列表是 Python 中最常用的有序集合,使用中括号 [] 包裹,元素之间用英文逗号隔开。列表不仅可以存储同一种类型的数据,还可以混存数字、字符串乃至其他列表。其核心特征在于有序与基于整数下标的直接访问。
1.1 列表的创建与索引规则
在 Python 中,列表的索引严格从 0 开始递增。第一个元素的下标是 0,第二个是 1,以此类推。同时,Python 还支持负数索引,-1 表示最后一个元素,-2 表示倒数第二个,这在不预先计算列表长度时读取尾部数据非常方便。
# 1. 创建任务列表
task_list = ["需求分析", "编写代码", "单元测试"]

# 2. 正向与负向索引查询
first_task = task_list[0]    # 获取第 1 项:"需求分析"
last_task = task_list[-1]    # 获取最后 1 项:"单元测试"

print(f"第一个任务: {first_task}")
print(f"最后一个任务: {last_task}")最后一个任务: 单元测试
1.2 列表切片:提取子范围
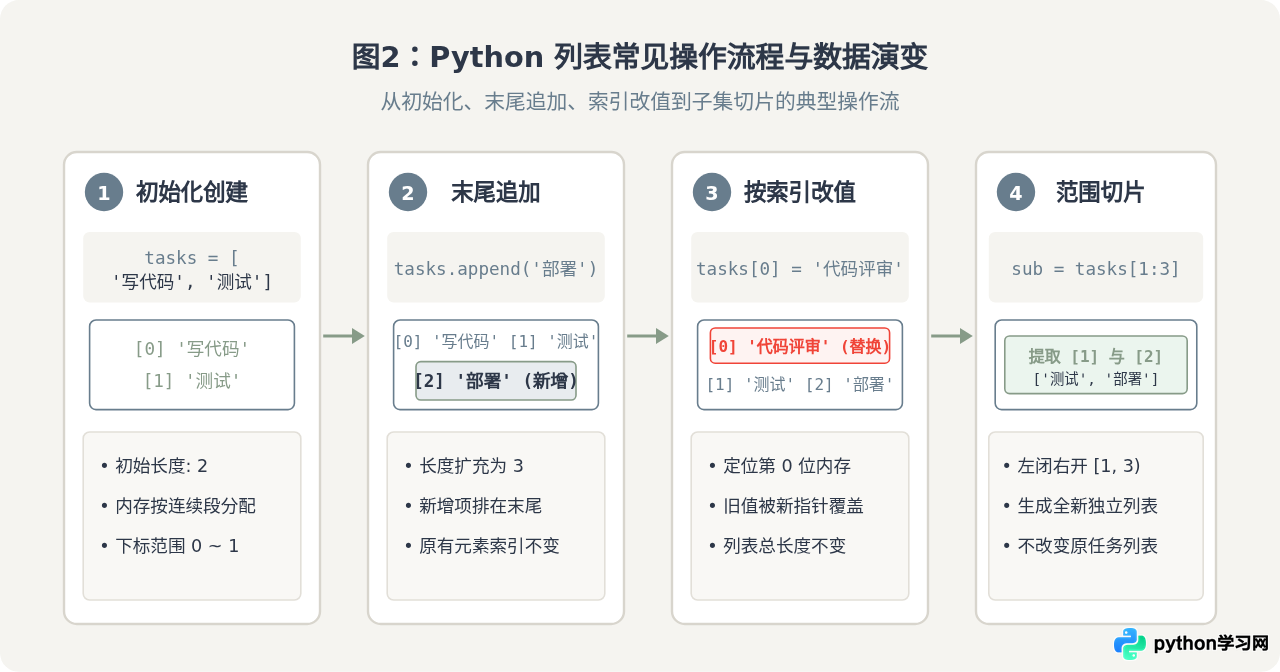
切片(Slice)语法是列表查询的进阶技巧,语法规则为 list[start:stop:step]。切片严格遵守左闭右开原则:包含起始位置 start,但不包含结束位置 stop。
scores = [88, 92, 79, 95, 60, 85]

# 提取前 3 个成绩 (下标 0, 1, 2)
top_three = scores[0:3]

# 从下标 2 开始一直取到末尾
from_second = scores[2:]

print(f"前三名成绩: {top_three}")
print(f"从第3项起: {from_second}")从第3项起: [79, 95, 60, 85]
1.3 列表常见增改操作与元素变动
列表是可变对象,可以在原有内存空间中动态追加、修改或删除元素:
- 追加元素:使用
list.append(x)将元素直接追加至列表末尾。 - 修改元素:直接使用赋值语句
list[i] = new_value替换指定下标处的内容。 - 元素存在判断:使用
value in list检查某个值是否存在于列表中,返回布尔值True或False。
二、字典(Dictionary):键值映射与安全查询
如果说列表是一列按编号编排的柜子,那么字典(Dictionary)就像一本电话簿或带标签的储物盒。字典使用大括号 {} 定义,每个元素由键(Key)与值(Value)组成,形式为 key: value,键值对之间用逗号分隔。
2.1 键的严格要求:不可变性与唯一性
字典的键(Key)有两个刚性约束:
- 必须不可变(Hashable):常用的字符串、整数、浮点数以及元组都可以作为键;但列表、字典等可变容器绝不能作为键。
- 键名必须唯一:同一个字典内不能存在重复的键。如果多次为同一个键赋值,后写入的值会无条件覆盖先写入的值。
2.2 数据查询对比:直接访问 vs .get() 安全取值
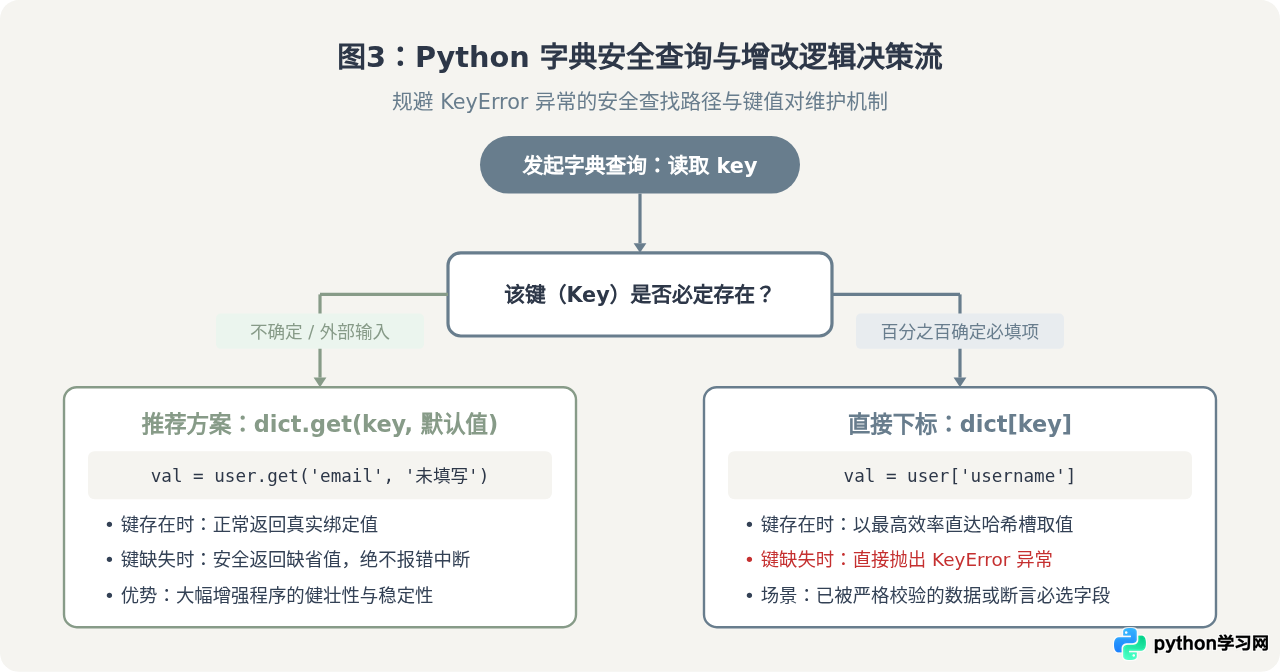
初学者最常犯的错误,是在键不确定是否存在时直接用中括号下标 dict[key] 访问。一旦键不存在,Python 会立即触发 KeyError 并导致程序异常中断。而推荐的标准做法是使用 dict.get(key, default) 方法。
# 1. 定义用户档案字典
user_info = {
    "username": "coder_alex",
    "role": "developer",
    "level": 3
}

# 2. 已知必存在的键:使用 [] 直接取值
user_name = user_info["username"]

# 3. 不确定是否存在:使用 .get() 设定兜底默认值
email = user_info.get("email", "未绑定邮箱")
phone = user_info.get("phone", "暂无联系电话")

print(f"用户昵称: {user_name}")
print(f"电子邮箱: {email}")
print(f"手机号码: {phone}")电子邮箱: 未绑定邮箱
手机号码: 暂无联系电话
2.3 字典的新增、修改与多维遍历
字典的增改语法非常统一:dict[key] = value。如果该 key 原本不存在,则直接新增该键值对;如果该 key 已经存在,则将其旧值覆盖更新为新值。
config = {"theme": "light", "fontSize": 14}

# 1. 修改已存在的键
config["fontSize"] = 16

# 2. 新增原本不存在的键
config["autoSave"] = True

# 3. 遍历字典的键值对 (.items())
print("当前配置清单:")
for key, value in config.items():
print(f" {key} -> {value}")theme -> light
fontSize -> 16
autoSave -> True
三、核心差异对比与数据结构选型逻辑
掌握列表和字典不仅要会敲语法,更要理解它们在性能、结构与使用情境上的关键差异。列表是有序线性表,查找具体数值需要从第 0 项向后逐一比对(时间复杂度为 O(n));而字典基于哈希表(Hash Table)实现,根据键名能通过数学映射直接定位内存位置,查找时间几乎恒定(时间复杂度为 O(1))。
| 对比维度 | 列表 (List) | 字典 (Dictionary) |
|---|---|---|
| 语法标识 | 中括号 [] |
大括号 {key: value} |
| 数据寻址 | 依赖从 0 开始的整数序列 | 依赖具有业务语义的唯一键(Key) |
| 元素重复性 | 允许存放完全相同的重复项 | 键名绝对唯一,值允许重复 |
| 按内容查找效率 | 线性扫描 O(n),数据量越大越慢 | 哈希映射 O(1),近乎瞬时直达 |
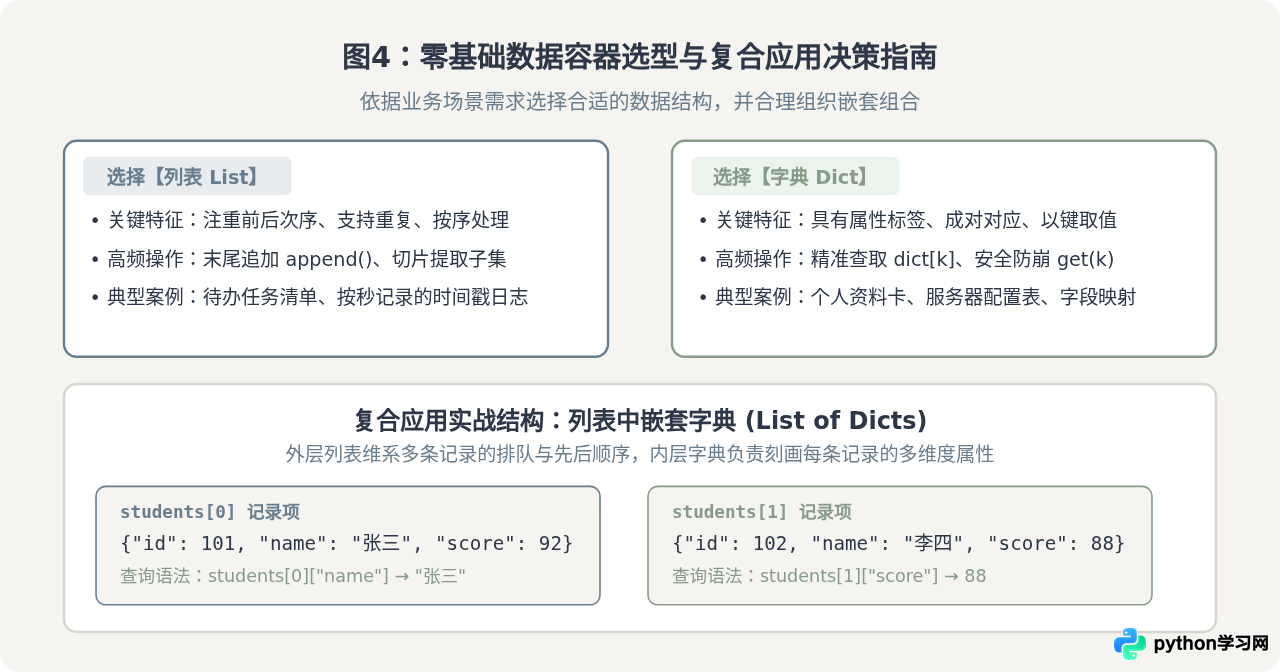
| 核心适用场景 | 排队等待队列、时间序列、排行榜 | 用户信息实体、配置表、字段名映射 |
实战中的复合嵌套:列表中嵌套字典
在现实项目开发中,极少有业务场景只单纯使用列表或字典。最通用、最优雅的数据组织模式往往是两者复合嵌套:使用外层列表维护有序的记录清单,使用内层字典精确表达单条记录的多维属性。
# 经典设计:学生信息花名册 (List of Dicts)
student_records = [
    {"id": 101, "name": "张三", "score": 92},
    {"id": 102, "name": "李四", "score": 88},
    {"id": 103, "name": "王五", "score": 95}
]

# 遍历列表,再通过字典键精确读取每个学生的属性
for stu in student_records:
    # 提取字典内部具体字段
    stu_name = stu["name"]
    stu_score = stu["score"]
    status = "优秀" if stu_score >= 90 else "良好"
print(f"学号 {stu['id']} | 姓名: {stu_name} | 成绩: {stu_score} ({status})")学号 102 | 姓名: 李四 | 成绩: 88 (良好)
学号 103 | 姓名: 王五 | 成绩: 95 (优秀)
四、零基础常见报错与避坑指南
在初次编写列表与字典代码时,以下四个报错和逻辑误区出现频率极高,需要格外注意:
如果列表一共有 3 个元素,合法下标只能是
0, 1, 2。如果尝试访问 list[3],Python 会立即报错。在编写根据下标取值的代码前,务必先用 len(list) 确认其有效长度。
直接使用
dict['xxx'] 取值时,只要该键不存在就会引发崩溃。面对不确定的外部数据、网络接口返回参数时,牢记将直接下标改为 dict.get('xxx', 默认值)。
很多初学者常写出
new_list = old_list.append("item")。实际上 append() 方法是直接就地修改原列表,其返回值是 None,这样赋值会导致 new_list 变为 None。正确写法是直接执行 old_list.append("item")。
字典依靠键的哈希值做快速映射,因此键必须具备不可变性。尝试使用
{[1, 2]: "data"} 会引发 TypeError: unhashable type: 'list'。如需将序列作为键,可使用不可变的元组(Tuple),如 {(1, 2): "data"}。
五、总结
回顾列表与字典的核心思想:
- 列表(List):靠次序组织世界。只要数据有先后排队、需要按位置抓取、可能随时在末尾加塞,优先选择列表。
- 字典(Dictionary):靠标签理解世界。只要数据具备字段属性、需要凭借唯一的名称标签秒级定位,优先选择字典。
- 组合嵌套:掌握“外层列表管批次,内层字典管字段”的复合思维,是迈向真实业务数据处理的关键一步。
在实际练习中,多观察数据之间的逻辑关系,遵循“防越界用长度判断、防报错用 get 兜底”的良好规范,即可轻松写出高效、稳定的 Python 数据存取逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















