


Python列表排序:list.sort()与sorted()的核心区别

list.sort() 方法与 sorted() 内置函数是最核心的两个选择。它们最本质的区别在于:修改机制与适用对象。list.sort() 是仅针对列表(list)的原地修改方法,它直接调整原列表内部元素的存储顺序,执行后返回值为 None;而 sorted() 是 Python 提供的通用全局内置函数,可以接受任何可迭代对象(列表、元组、字典、集合、字符串等),执行时不改变原数据,而是分配新内存并返回一个排好序的全新列表。
一、核心机制差异:原地修改与新列表创建
理解两者机制差异的关键,在于观察排序操作后“原对象是否发生变化”以及“函数的返回值是什么”。
1. list.sort() 的原地排序(In-place)机制
list.sort() 属于 list 对象的成员方法。调用该方法时,Python 底层的排序算法会直接在原列表所在的连续内存空间内重新调整指针引用。由于它直接作用于原对象,因此设计上规定其返回值为 None,以此提醒开发者“原数据已在原地被修改”。
# list.sort() 原地修改示例
raw_list = [5, 2, 8, 1, 9]
print("排序前原列表:", raw_list, "内存地址:", hex(id(raw_list)))

# 调用 sort() 方法
return_val = raw_list.sort()

print("调用后原列表:", raw_list, "内存地址:", hex(id(raw_list)))
print("sort() 的返回值:", return_val)

# 输出结果:
# 排序前原列表: [5, 2, 8, 1, 9] 内存地址: 0x10a48a240
# 调用后原列表: [1, 2, 5, 8, 9] 内存地址: 0x10a48a240
# sort() 的返回值: None高频避坑提醒:切勿写出 numbers = numbers.sort() 这样的赋值语句。由于 sort() 的返回值是 None,这种写法会把原本保存列表的变量直接覆盖为 None,从而导致后续所有的列表操作抛出 AttributeError: 'NoneType' object has no attribute ...。
2. sorted() 的非破坏性机制
sorted() 是 Python 的全局内置函数。无论传入的是什么序列或迭代器,sorted() 都会在内存中新建一个列表对象,将迭代出来的元素依序排序后填入新列表中并返回。原对象的所有内容与内存地址完全不受影响。
# sorted() 返回新列表示例
original_data = [5, 2, 8, 1, 9]
print("排序前原列表:", original_data, "内存地址:", hex(id(original_data)))

# 调用全局 sorted() 函数
sorted_data = sorted(original_data)

print("排序后原列表:", original_data, "内存地址:", hex(id(original_data)))
print("排序后新列表:", sorted_data, "内存地址:", hex(id(sorted_data)))

# 输出结果:
# 排序前原列表: [5, 2, 8, 1, 9] 内存地址: 0x10a48ae00
# 排序后原列表: [5, 2, 8, 1, 9] 内存地址: 0x10a48ae00 (内容与地址完全未变)
# 排序后新列表: [1, 2, 5, 8, 9] 内存地址: 0x10a48af80 (全新分配的列表对象)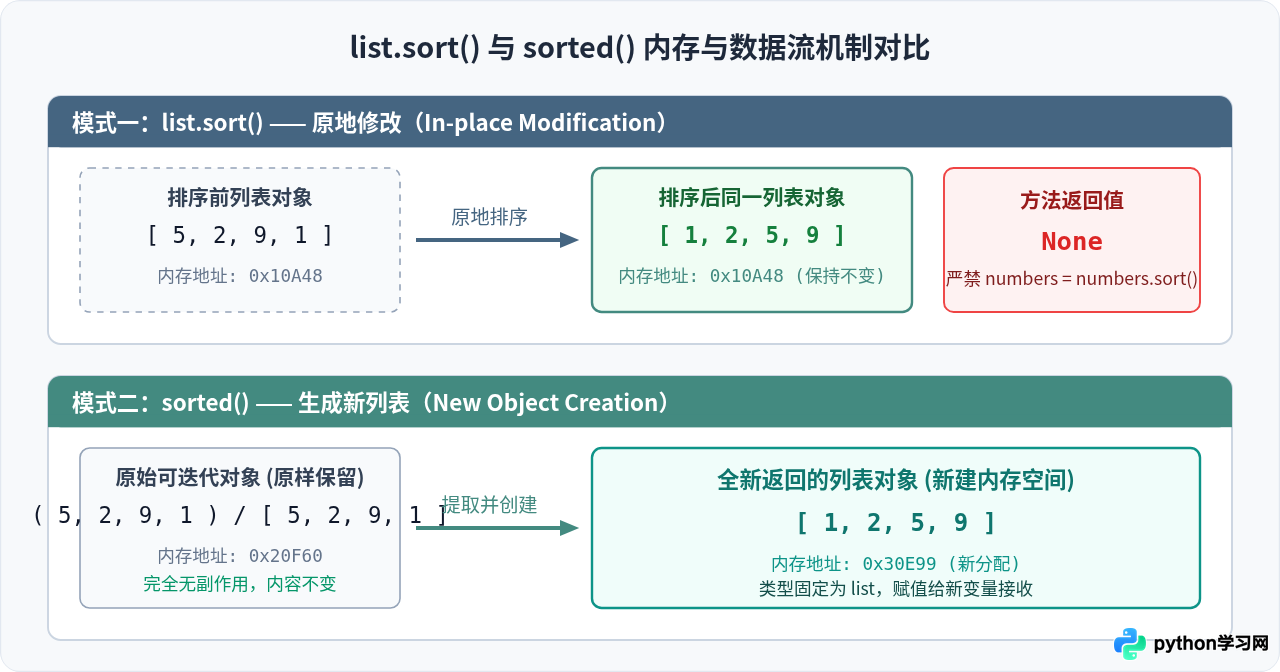
二、适用数据类型差异:方法与内置函数的边界
第二个核心区别体现在两者的调用方式与适用数据类型上。
1. list.sort() 仅限列表调用
由于 sort() 是定义在 list 类中的实例方法,它必须通过列表实例来调用(如 my_list.sort())。如果尝试在元组(tuple)、字典(dict)、字符串(str)或生成器上调用该方法,Python 解释器会直接抛出属性错误:
tpl = (3, 1, 4)
# 错误调用方式:
# tpl.sort()
# 报错信息:AttributeError: 'tuple' object has no attribute 'sort'
2. sorted() 支持所有可迭代对象
sorted() 属于 Python 顶层内置函数(Built-in Function),凡是实现了 __iter__() 协议的对象,均可作为参数传入 sorted() 中。特别需要注意的是:无论输入数据的原始类型为何,sorted() 输出的容器类型一律是列表(list)。
# 1. 对元组排序:返回排序后的新列表
tup = (10, 5, 8)
print("元组排序结果:", sorted(tup))  # 输出: [5, 8, 10]

# 2. 对字符串排序:返回排序后的单个字符列表
text = "python"
print("字符串排序结果:", sorted(text))  # 输出: ['h', 'n', 'o', 'p', 't', 'y']

# 3. 对字典排序:默认对键(Keys)进行排序
score_dict = {"Bob": 85, "Alice": 92, "Charlie": 78}
print("字典按键排序结果:", sorted(score_dict))  # 输出: ['Alice', 'Bob', 'Charlie']

# 4. 对集合(Set)排序:输出有序列表
unique_nums = {7, 1, 3, 9}
print("集合排序结果:", sorted(unique_nums))  # 输出: [1, 3, 7, 9]

# 5. 对生成器表达式排序
gen = (x * 2 for x in [3, 1, 2])
print("生成器排序结果:", sorted(gen))  # 输出: [2, 4, 6]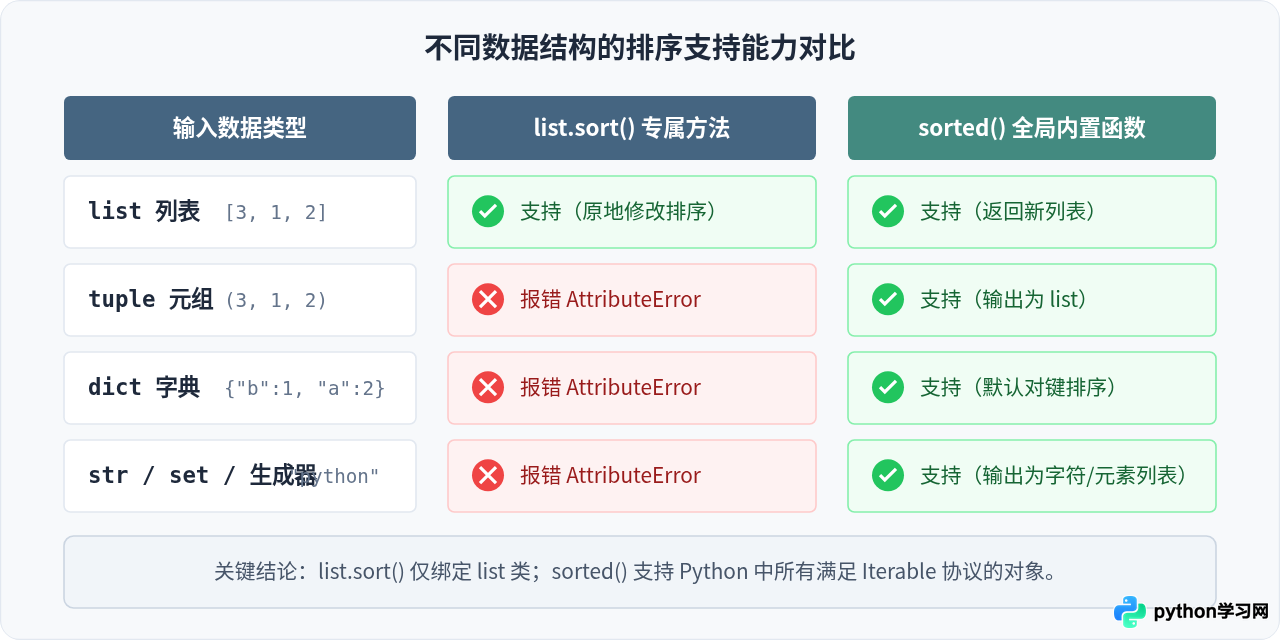
三、内存占用与底层算法性能
在算法实现与效率上,两者有相同的底座,但在内存资源分配上差异显著。
1. 内存消耗差异(Space Complexity)
- list.sort():空间复杂度 O(1)。由于在原数据指针数组上进行就地重排,仅需要微小的辅助变量用于分段合并(Runs),几乎不需要额外分配大块内存。对于包含数百万条记录的大列表,原地排序能极大缓解内存压力。
- sorted():空间复杂度 O(N)。无论待排序序列原本有多大,
sorted()都必须在堆内存中重新开辟一段足以容纳全部元素引用的全新连续空间。当内存极其紧张或列表非常庞大时,使用sorted()可能会引起明显的内存峰值。
2. 底层算法与时间复杂度(Time Complexity)
两者在底层均采用业界著名的 Timsort 混合排序算法(在 Python 3.11 及后续版本中进一步采用了基于 Powersort 合并策略的优化版 Timsort)。该算法兼具插入排序(Insertion Sort)与归并排序(Merge Sort)的优势:
- 最坏与平均时间复杂度:O(n log n)
- 最优时间复杂度(列表已部分或完全有序):O(n)
- 稳定性(Stable Sort):两者都是完全稳定的排序算法。如果两个元素根据比较规则大小相等,它们在排序后的相对顺序与原始列表中的相对顺序保持一致。
在执行时间上,虽然两者算法复杂度一致,但 list.sort() 省去了创建新列表对象与反复追加元素指针的开销,因此在纯速度测试中通常比 sorted() 略快 10% 到 20%。
四、常用参数与完整操作步骤
无论是 list.sort() 还是 sorted(),它们都接受相同的关键字参数:key 和 reverse。这两个参数必须作为关键字传参(Keyword-only arguments)。
1. 常用参数解析
key:接受一个单参数的函数。该函数会在每个元素上被调用一次,以返回的值作为比较的依据。原元素本身不会被修改。reverse:布尔值。默认False表示升序排列(从小到大);设置为True表示降序排列(从大到小)。
2. 规范操作与代码示例
# 场景:学生信息多维排序
students = [
    {"name": "Alice", "score": 92, "grade": 2},
    {"name": "Bob", "score": 85, "grade": 3},
    {"name": "Charlie", "score": 92, "grade": 1},
    {"name": "David", "score": 78, "grade": 2}
]

# 示例一:使用 sorted() 按单字段降序排列(不破坏原数据)
ranked_by_score = sorted(students, key=lambda s: s["score"], reverse=True)
print("分数降序排列:")
for s in ranked_by_score:
    print(f"  {s['name']}: {s['score']}分")

# 示例二:使用 list.sort() 进行多字段复合排序
# 规则:先按分数降序,分数相同时按年级(grade)升序
students.sort(key=lambda s: (-s["score"], s["grade"]))
print("\n多字段综合排序结果(原列表已变更):")
for s in students:
    print(f"  {s['name']} (年级:{s['grade']}, 分数:{s['score']})")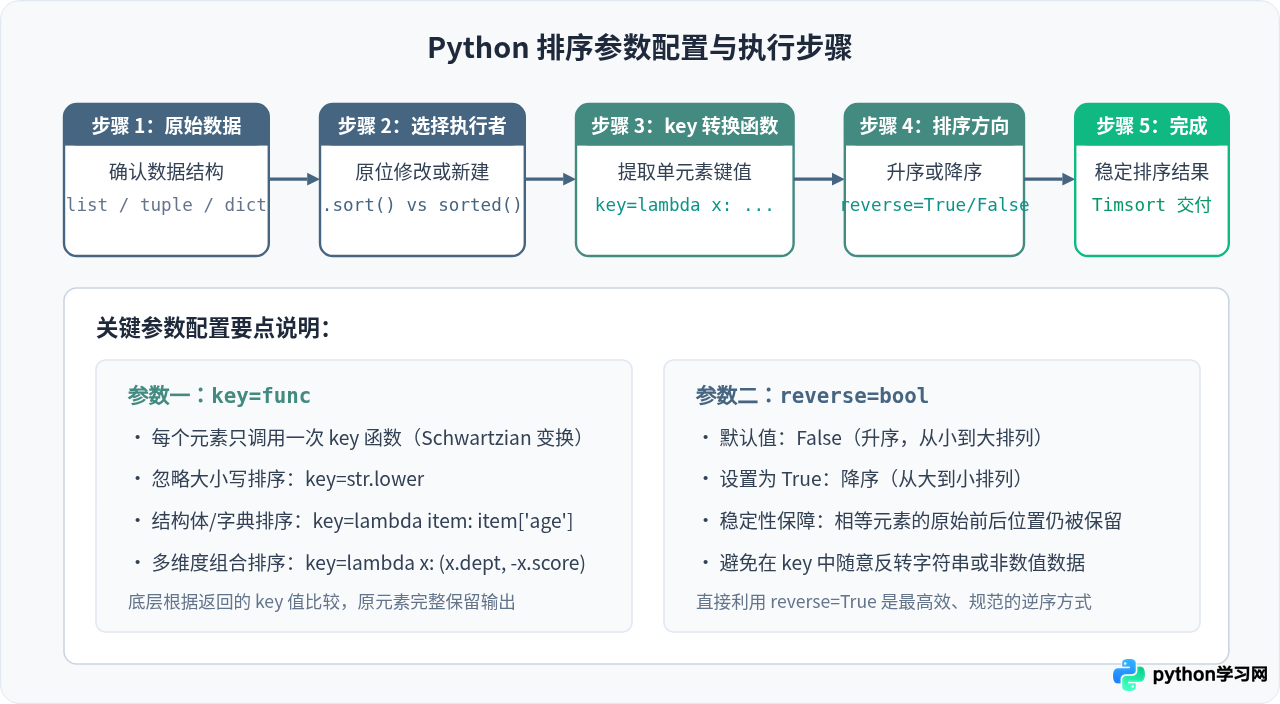
五、实际开发选型决策指南
在日常业务开发与数据处理中,应当根据以下三个核心条件进行判断与选型:
| 考虑维度 | 选用 list.sort() 的场景 | 选用 sorted() 的场景 |
|---|---|---|
| 数据不可变性 | 原始顺序不再需要,允许直接就地覆盖。 | 必须完整保留原始数据的顺序,防止产生代码副作用。 |
| 输入数据类型 | 数据源本身已经是标准的 list。 |
数据源是 tuple、set、dict 或生成器。 |
| 内存敏感度 | 数据量极大(如百万级列表),追求极低内存占用。 | 数据量处于常规规模,内存充裕。 |
| 代码风格与链式调用 | 过程式编程,单步执行修改。 | 函数式编程,需将排序结果直接传递给下一层函数。 |
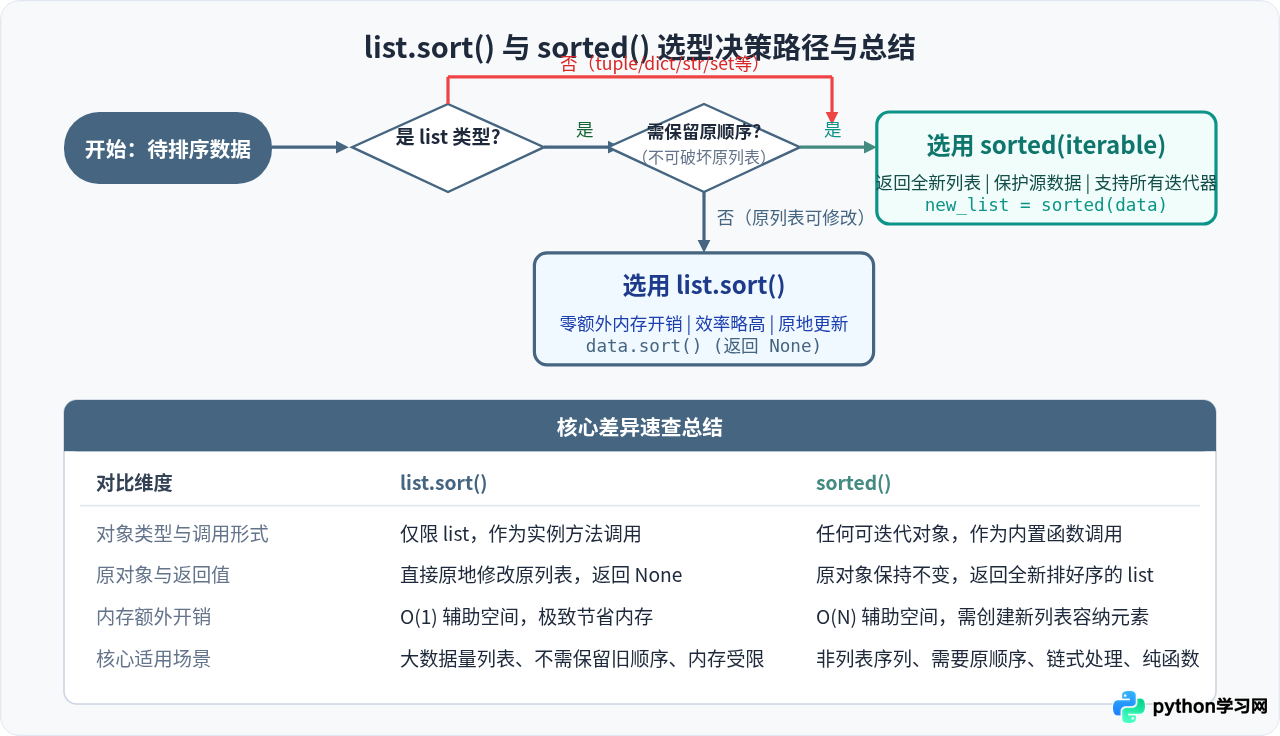
总结:当你只需要对一个既有列表做内部更新且不在意其原始顺序时,直接使用 list.sort() 最为高效、省内存;而在面对不可变数据(如元组)、需要保留输入原貌的公共函数,或者需要链式调用结果时,请始终选择 sorted()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















