


Python字符串切片步长为负数时怎么确定起始和结束位置?

step 为负数时,扫描方向会由常规的“自左向右”反转为“自右向左”。因此,确定起始位置 start 与结束位置 stop 的核心法则是:起始位置必须位于结束位置的右侧(即物理下标更大),切片区间依然遵守“含头不含尾”的规则从右向左递减收集字符;若需要截取到字符串的最开头(包含索引 0),必须完全省略 stop 参数而不能传入 0 或 -1。
一、核心机制:负步长如何改变切片的扫描方向
Python 字符串切片的完整语法是 s[start:stop:step]。这个表达式本质上定义了一个等差数列索引生成器:从 start 开始,每次累加 step,只要下一个索引还落在 stop 之前(沿扫描方向),就取出对应的字符。
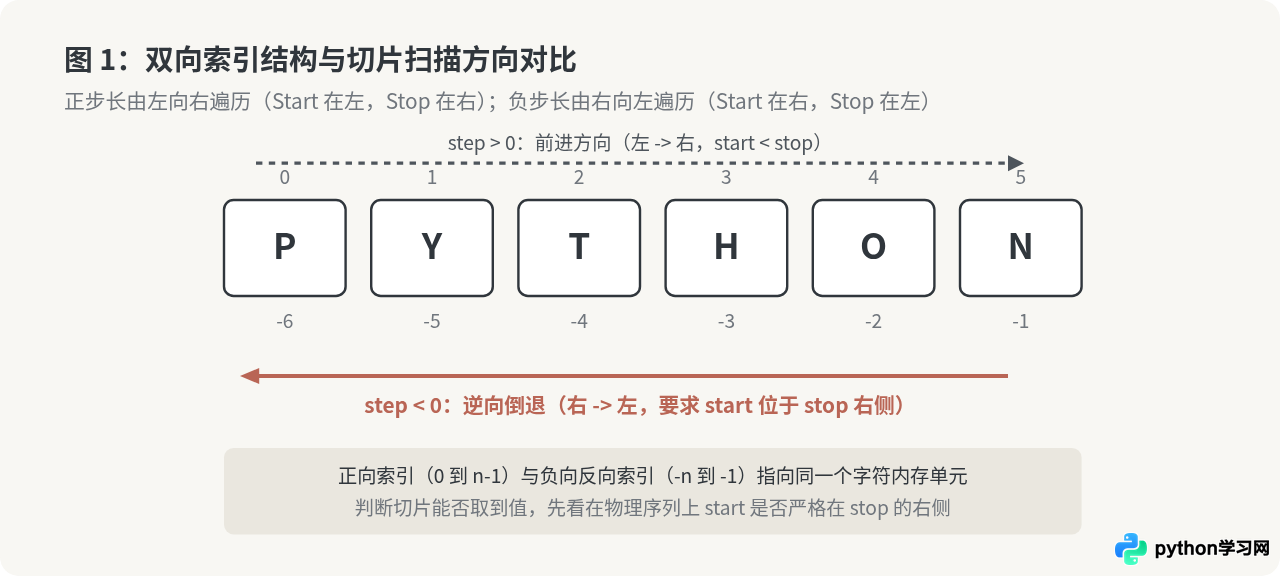
当 step > 0 时,索引每次递增,切片沿着序列从左向右移动。此时要求 start < stop,否则序列生成器无法向前到达目标,直接返回空字符串 ""。
而当 step < 0 时,索引每次加上一个负数,也就是每次递减 |step|。为了能够遍历到元素,切片的移动方向变为从右向左。这就带来了一个决定性的变化:起始位置 start 必须在结束位置 stop 的右边。如果 start <= stop(按实际在序列中的物理顺序来看),切片指针向左移动只会离 stop 越来越远,Python 在判定无法在逆向迭代中触达 stop 时,会立即返回空字符串。
二、确定起始位置与结束位置的三步推导法
由于 Python 支持正负两种下标,同时步长又有正负,两者叠加时极易造成思维混乱。要准确确定 start 和 stop,可以遵循以下三个具体步骤:
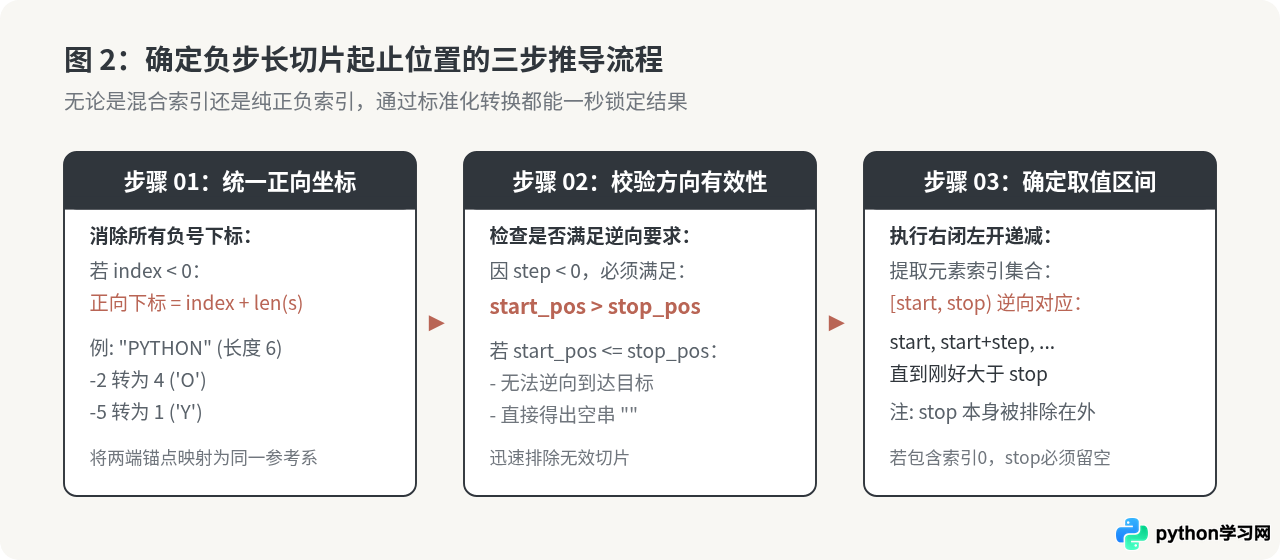
第 1 步:将所有负数下标换算为等价的正向下标
Python 允许使用形如 -1、-2 的负索引,其换算公式非常简单:实际下标 = 负索引 + len(s)。例如对于字符串 s = "PYTHON"(长度为 6):
-1对应-1 + 6 = 5(字符'N')-2对应-2 + 6 = 4(字符'O')-5对应-5 + 6 = 1(字符'Y')
无论切片表达式里写的是正数还是负数,先在脑海中将其统一转换为 0 到 len(s)-1 的绝对位置,这样能立刻摆脱“负负得正”或“符号混淆”的错觉。
第 2 步:校验起点与终点的相对位置(方向判定)
换算成统一的绝对位置后,观察 start 与 stop 的大小:
- 如果
start > stop:移动方向与负步长吻合(从右向左递减),切片有效,可以提取到字符。 - 如果
start <= stop:移动方向发生冲突,切片无效,结果必然是""(空字符串)。
例如表达式 s[1:4:-1]:在正向下标体系中,1 < 4。正向切片 s[1:4:1] 能够拿到 "YTH",但加上 -1 步长后,系统尝试从索引 1 向左递减遍历去寻找索引 4,这显然无法到达,因而直接返回 ""。
第 3 步:应用“包含起点、排除终点”提取字符
切片原则始终是左闭右开。在逆向遍历中,这个原则应当被准确理解为包含起点、排除终点:
- 首个提取的字符就是
s[start]。 - 接下来依次提取
s[start + step]、s[start + 2*step]…… - 当下一个索引等于或者越过了
stop时,遍历立刻终止,s[stop]绝对不会被包含在结果中。
三、参数缺省时的默认值规则与“首字符陷阱”
初学者在使用负步长切片时,最常遇到的障碍是:如何倒序截取并包含索引为 0 的第一个字符?
直觉上,很多人会尝试写 s[4:0:-1],或者为了防范右开区间写出 s[4:-1:-1]。然而这两种写法都无法实现目标:
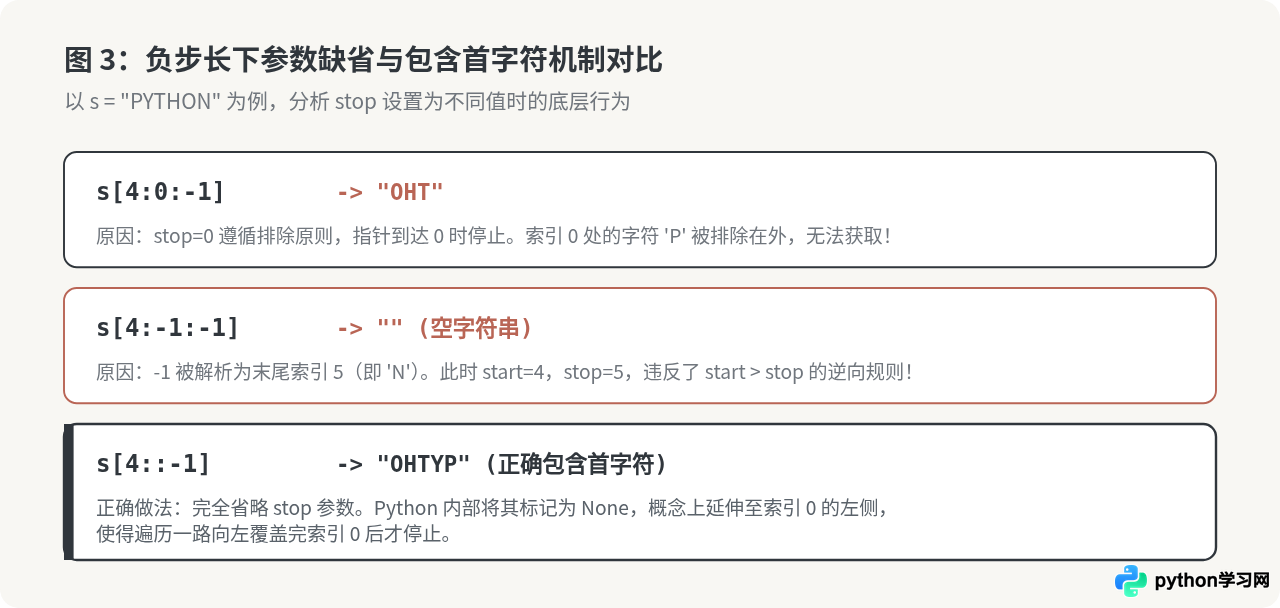
1. 为什么 s[4:0:-1] 拿不到第一个字符?
因为切片始终是“排除终点”的。当设定 stop=0 时,索引递减序列为 4, 3, 2, 1。一旦下一个索引为 0,循环立刻终止。因此索引 0 上的字符永远不会被取出。
2. 为什么 s[4:-1:-1] 会返回空字符串?
有人以为 -1 表示“比 0 还靠左的一位”。这是完全错误的。在 Python 中,-1 永远指向字符串的最后一个元素(在长度为 6 的字符串中,-1 等价于正向索引 5)。
代入换算后,s[4:-1:-1] 实际上等价于 s[4:5:-1]。由于 start (4) < stop (5),起点在终点的左侧,逆向步长无法推进,因而直接判定为空串。
3. 正确解法:利用参数缺省机制
在 Python 中,当某个切片位置留空时,Python 会根据步长的符号填入不同的默认哨兵值:
| 参数 | 当 step > 0(正步长)时的默认值 | 当 step < 0(负步长)时的默认值 | 作用说明 |
|---|---|---|---|
start 缺省 |
0(首个字符) |
-1 或 len(s)-1(最后一个字符) |
负步长默认从最右侧开始逆序扫描 |
stop 缺省 |
len(s)(最后一个字符之后) |
None(概念上在索引 0 之前的一位) |
负步长下留空 stop 才能包含首字符 |
因此,如果要从下标 4 一路倒序截取到字符串最开头,唯一标准的语法就是省略 stop:s[4::-1]。
四、典型切片场景与代码实操对照
下面结合具体代码示例,展示四种最常见的负步长切片场景及其推导逻辑。
场景 1:完全翻转字符串
直接省略 start 和 stop,仅指定 step=-1:
s = "PYTHON"
# 默认 start 为末尾 (5),默认 stop 越过开头,步长为 -1
reversed_s = s[::-1]
print(reversed_s)  # 输出: "NOHTYP"
场景 2:从特定位置倒序截取到开头
指定明确的起始位置,stop 留空以确保包含第一个字符:
s = "PYTHON"
# 从索引 3 ('H') 开始,一直倒序截取到最开头的字符 'P'
sub_s = s[3::-1]
print(sub_s)  # 输出: "HTYP" (依次提取索引 3, 2, 1, 0)
场景 3:截取中间某个区间并逆序
从右侧的某字符截取到左侧的某字符(不包含左侧端点):
s = "PYTHON"
# 目标:提取 'O', 'H', 'T' (正向下标 4, 3, 2)
# 起点为 4 ('O'),终点为 1 ('Y',将被排除),步长为 -1
sub_s = s[4:1:-1]
print(sub_s)  # 输出: "OHT"
场景 4:混合使用负数索引与负步长
使用负数索引指定相对末尾的位置:
s = "PYTHON"
# -2 对应正向下标 4 ('O')
# -5 对应正向下标 1 ('Y')
# 因为 4 > 1,满足逆向条件,提取下标 4, 3, 2
sub_s = s[-2:-5:-1]
print(sub_s)  # 输出: "OHT"
五、常见混淆点与高频错误排查
在编写负步长切片时,若输出结果与预期不符,可按以下三项逐一排查:
- 得到的结果是空字符串
"":检查start在物理序列中是否小于或等于stop。如果是,调换两者的位置。 - 漏掉了第一个字符:检查是否将
stop写成了0。如果需要第一个字符,必须将冒号后留空(如s[3::-1])。 - 写了
stop=-1导致无输出:记住-1是序列尾部元素,不是哨兵越界值。在负步长中除非从负数且小于 -1 的位置倒退,否则stop=-1会使切片因起点不大于终点而返回空。
六、总结与速查决策
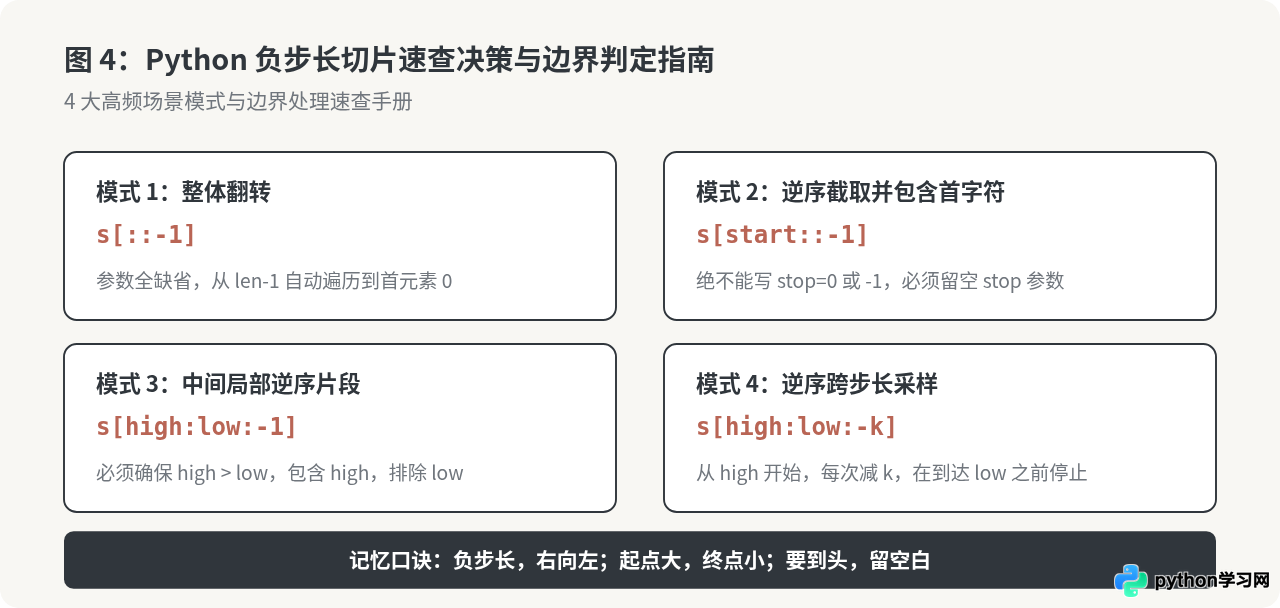
负步长切片的判定核心归结起来就是六个字:“起点大,终点小”。利用下图可以在编码时迅速作出正确选择:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















