


大模型API选型排名:价格、响应速度与稳定性的商业模型对比

在企业的数字化转型深水区,引入大语言模型(LLM)已不再是“要不要做”的战略问题,而是“如何做得划算且稳定”的战术难题。许多技术负责人在面对琳琅满目的API服务商时,往往陷入一种两难:头部模型的性能令人惊艳,但高昂的Token账单让财务部门皱眉;开源或二线模型价格亲民,却在高并发下频频超时或返回不稳定结果。
这种取舍并非简单的“贵就是好”或“便宜没好货”,而是不同商业模型对资源分配的不同侧重。选型的本质,是在特定的业务场景下,寻找成本、速度与稳定性三者之间的最优解,而非追求单项指标的极致。
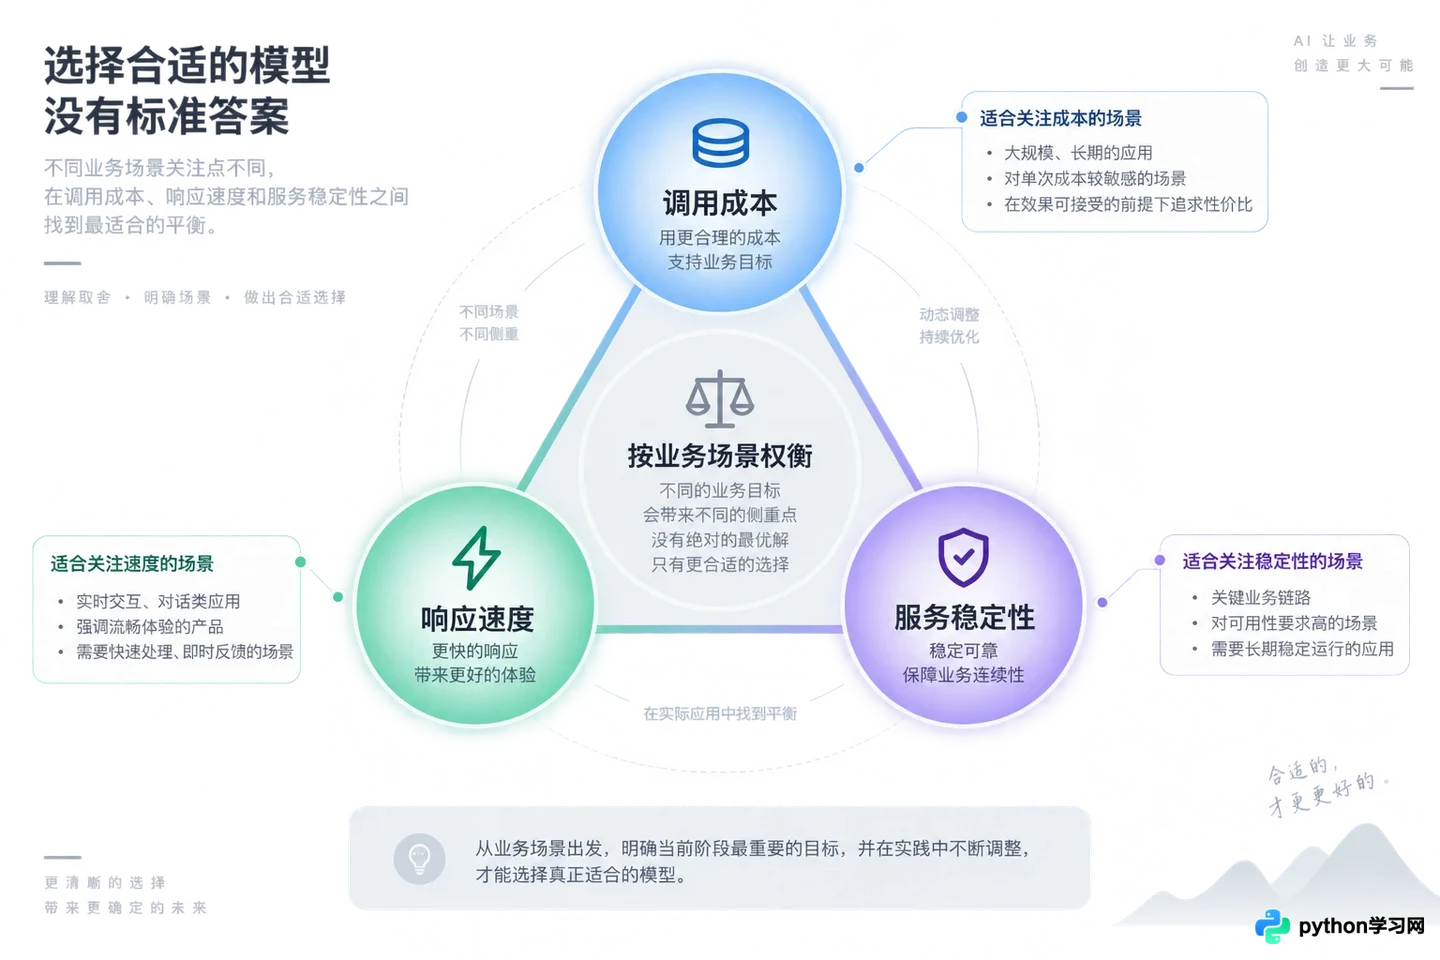
价格、速度与稳定性的不可能三角
成本敏感型场景:当每一分钱都要算在刀刃上
对于文档摘要、批量数据清洗或非实时客服问答等场景,业务对毫秒级延迟不敏感,但对吞吐量极其敏感。此时,模型的“智商”只要达到及格线,价格就成了决定性因素。
在这一象限中,部分主打高性价比的模型通过量化技术和蒸馏手段,大幅降低了推理成本。它们的商业策略通常是“薄利多销”,通过极低的输入/输出Token单价吸引海量长文本处理需求。例如,某些模型将长上下文窗口的价格压低至行业平均水平的十分之一,这使得处理百万字级的法律合同或财报成为可能,而无需担心预算爆炸。
然而,低价往往伴随着隐形的边界。这类模型在复杂逻辑推理或多轮指令遵循上可能出现波动,且在高峰期的排队时间可能较长。企业在使用时,必须建立完善的重试机制和结果校验流程。如果业务容错率低,单纯追求低价可能导致后期人工复核成本远超节省的API费用。
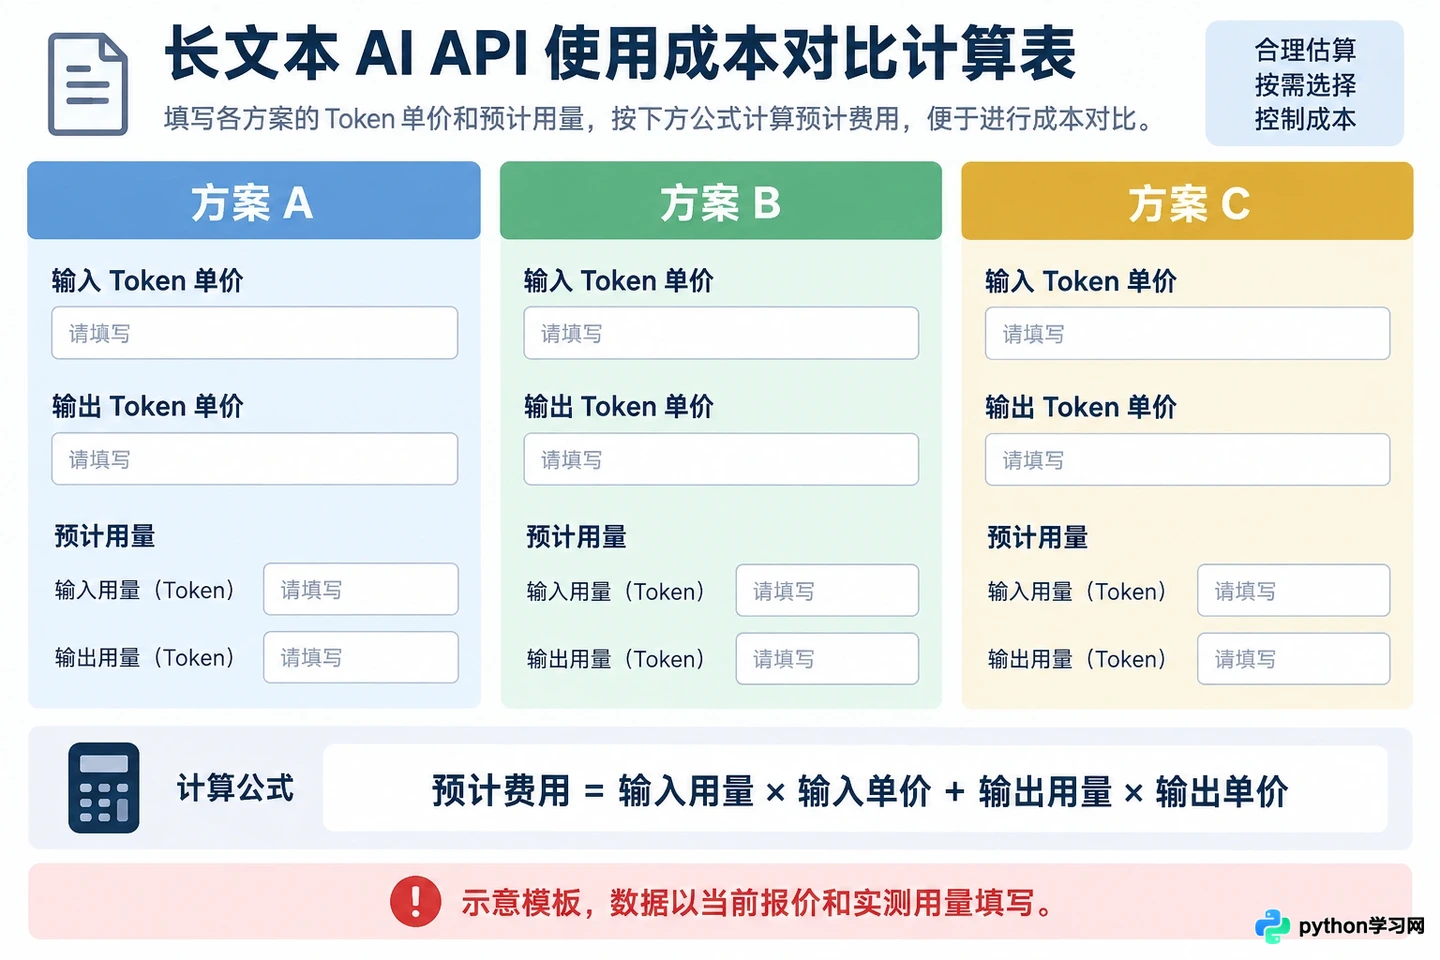
不同模型在处理长文本时的成本差异示意
实时交互型场景:速度即体验,延迟即流失
在智能助手、代码补全或实时翻译等场景中,用户对“等待”的容忍度极低。心理学研究表明,超过200毫秒的延迟就会让用户感知到卡顿,进而影响对产品专业度的判断。此时,首字生成时间(TTFT)和每秒生成令牌数(TPS)比单纯的Token单价更重要。
针对这一需求,部分服务商推出了专为低延迟优化的推理引擎。它们通过KV缓存优化、 speculative decoding(投机采样)等技术,在保证输出质量的前提下,将响应速度提升数倍。这类服务的商业模型通常采用分级定价:标准模式价格适中,而开启“高速模式”或专属实例则需支付溢价。
值得注意的是,速度优势具有明显的边际效应。当延迟降低到人类感知阈值以下后,继续投入资源提升速度的商业回报递减。此外,极速模式往往对并发连接数有限制,在高并发峰值下,若未购买足够的预留吞吐量,可能会遭遇限流,反而导致体验断崖式下跌。
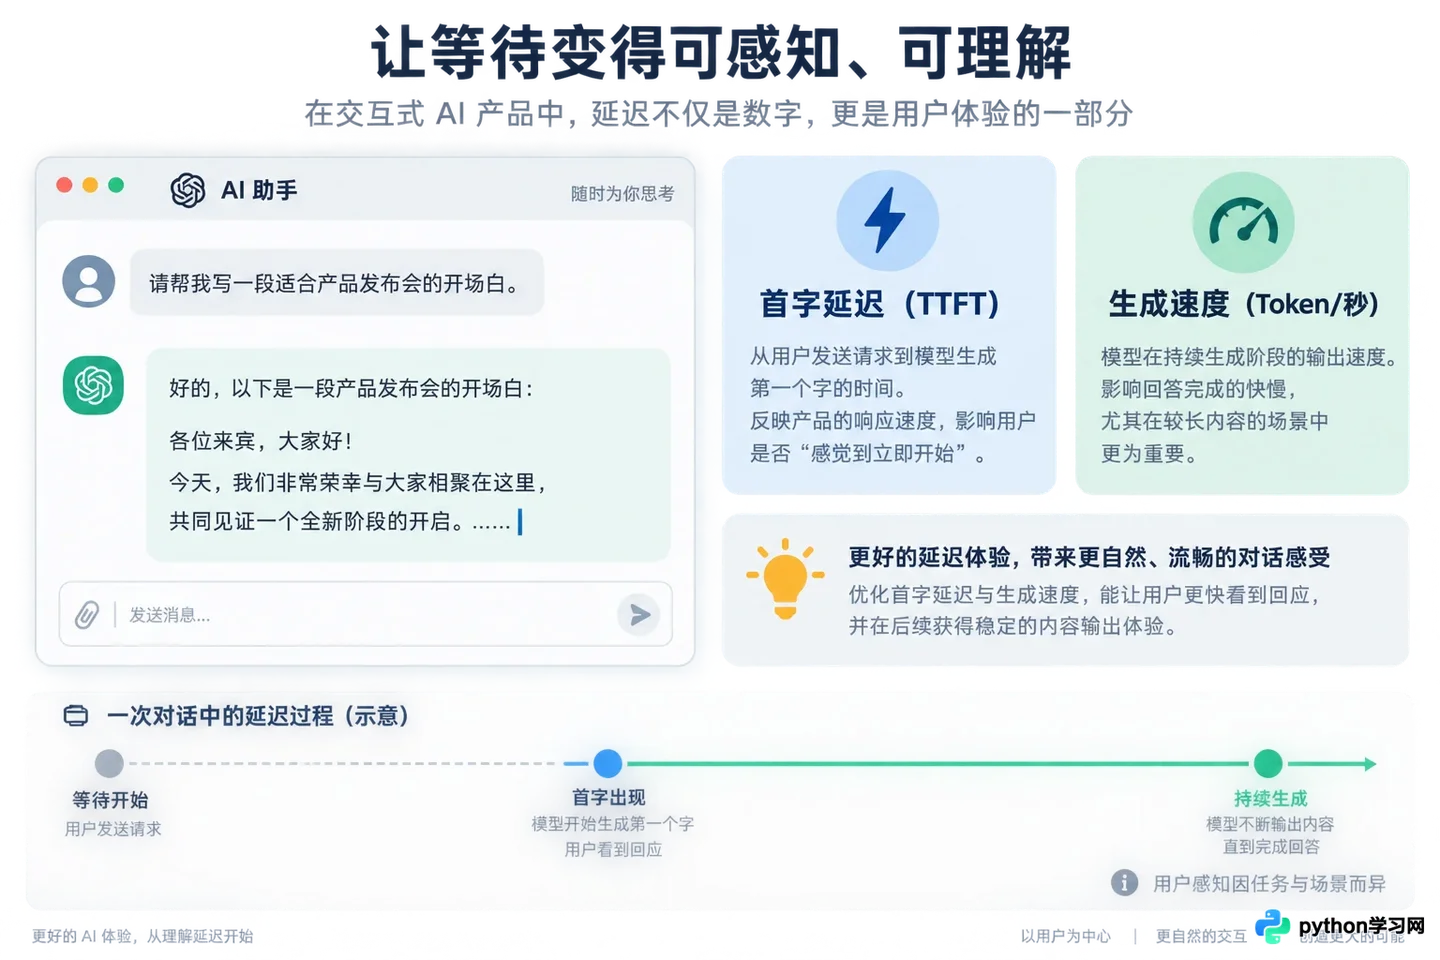
用户感知延迟与体验的关系
高可用业务型场景:稳定性是隐形的护城河
对于金融风控、医疗辅助或核心业务流程自动化等关键任务,服务的中断是不可接受的。这里的“稳定性”不仅指SLA(服务等级协议)中的可用性承诺,更包括输出格式的一致性、抗干扰能力以及在负载波动下的表现。
头部云厂商的大模型服务通常依托于其庞大的全球基础设施,提供多区域部署和自动故障转移能力。它们的商业模型包含较高的基础服务费或更高的Token单价,但换取的是99.9%甚至更高的可用性保证,以及企业级的技术支持通道。在这种模式下,企业购买的不仅是算力,更是“确定性”。
相比之下,一些新兴的API提供商可能在非高峰期表现优异,但在突发流量面前缺乏弹性扩容能力,导致错误率飙升。对于核心业务,选择拥有成熟运维体系和透明状态页面的服务商,远比节省几分钱的Token成本更为重要。
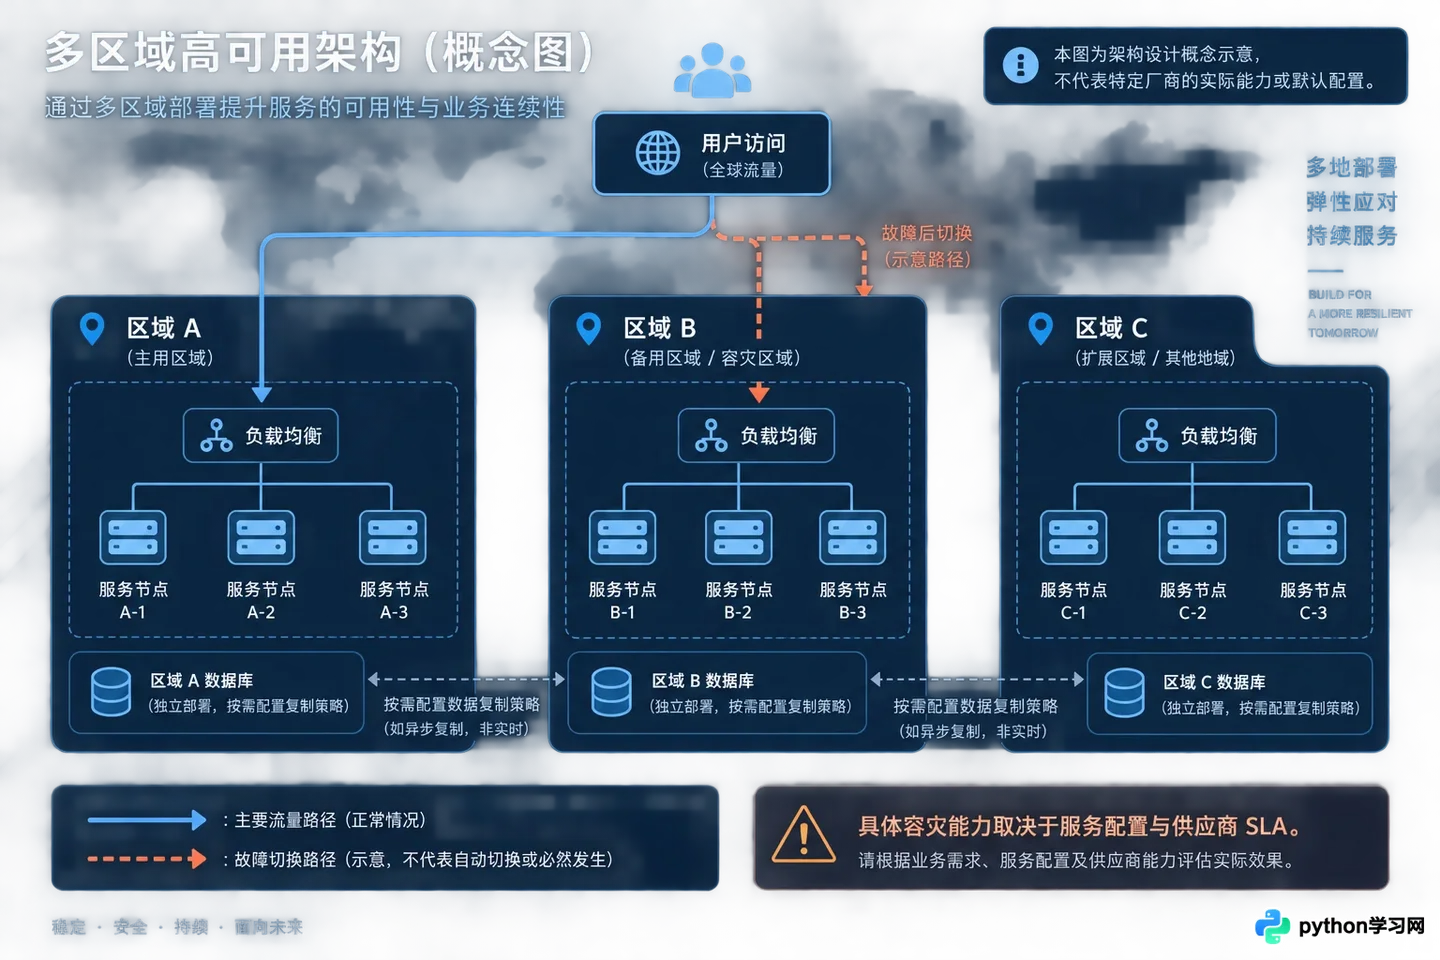
多区域故障转移保障业务连续性
综合权衡:没有完美的模型,只有合适的组合
回到开头的取舍,企业不应试图用单一模型解决所有问题。成熟的架构往往采用“路由”策略:将简单、大批量的任务分流至低成本模型,将复杂、实时的交互交给高性能模型,并将关键业务锁定在高可用服务上。
这种混合架构要求技术团队具备精细化的监控能力,能够实时追踪各模型的调用成本、延迟分布和错误率。只有这样,才能在动态变化的业务需求中,灵活调整流量分配,实现整体效益的最大化。
最终,大模型API的选型不是一次性的采购行为,而是一个持续优化的过程。真正的竞争力,不在于使用了最贵的模型,而在于是否构建了最能适配自身业务节奏的模型供应链。
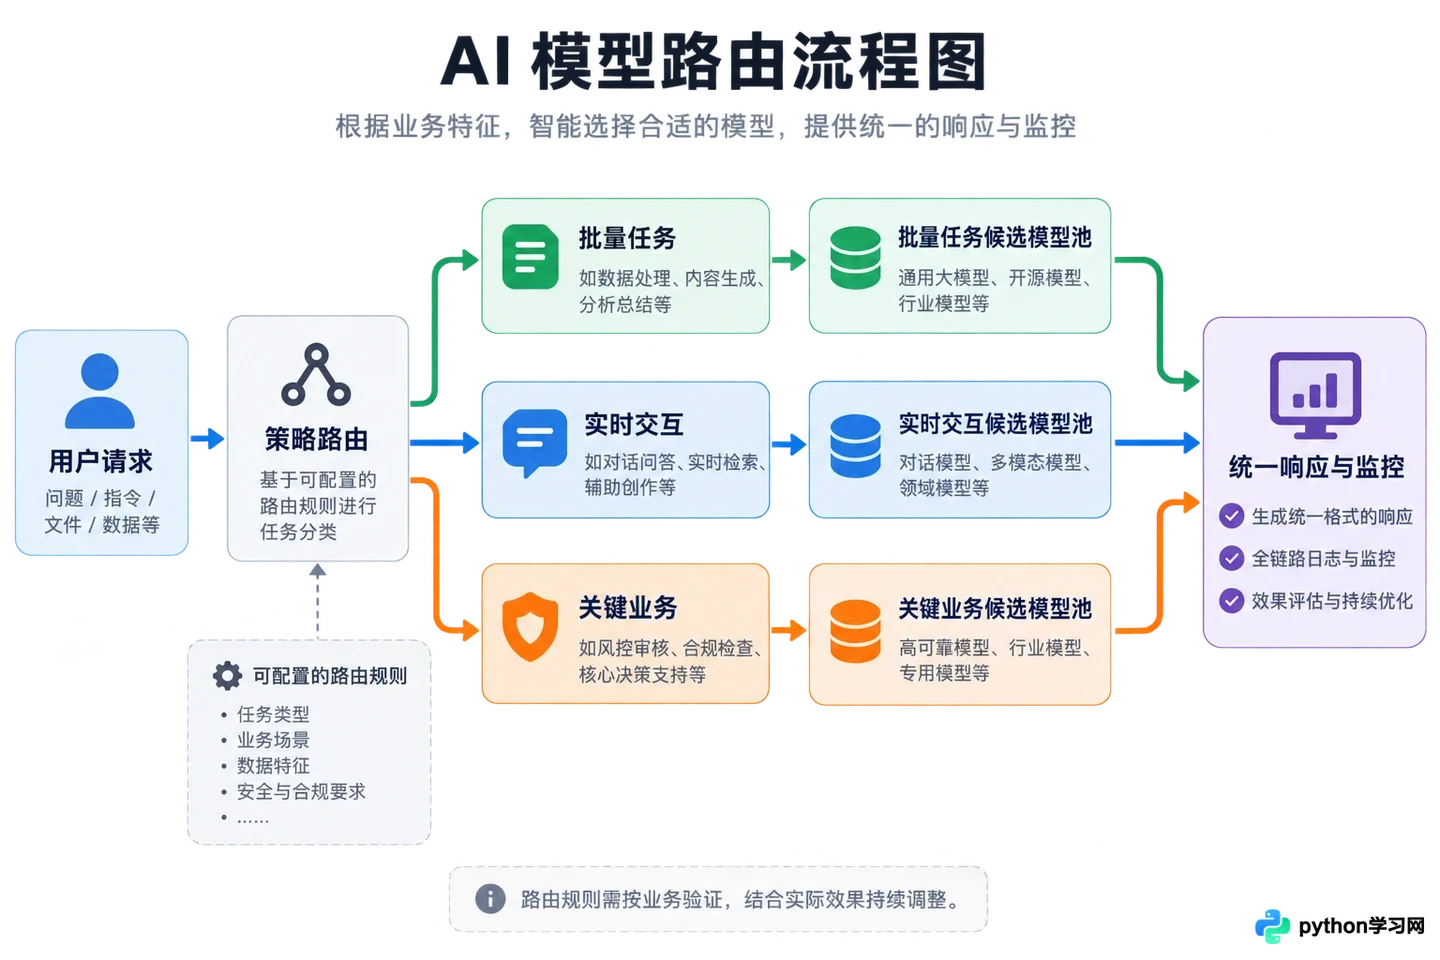
基于业务类型的智能路由分发
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















