


Python list()与split()转换字符串的区别及适用场景

在 Python 中将字符串转换为列表,最常用的两种原生途径是内置类型构造器 list() 与字符串专属方法 str.split()。两者看似都能输出列表,但底层机制与转换粒度完全不同:list() 基于可迭代协议进行逐字符解构,将字符串拆分为最小的单字符列表;而 str.split() 则基于定界符切分机制,根据指定或默认的分隔符将字符串分割为具有独立语义的词串或字段。明确两者的切分粒度、参数规则与边界行为,是编写严谨数据处理代码的前提。
一、核心原理与转换机制对比
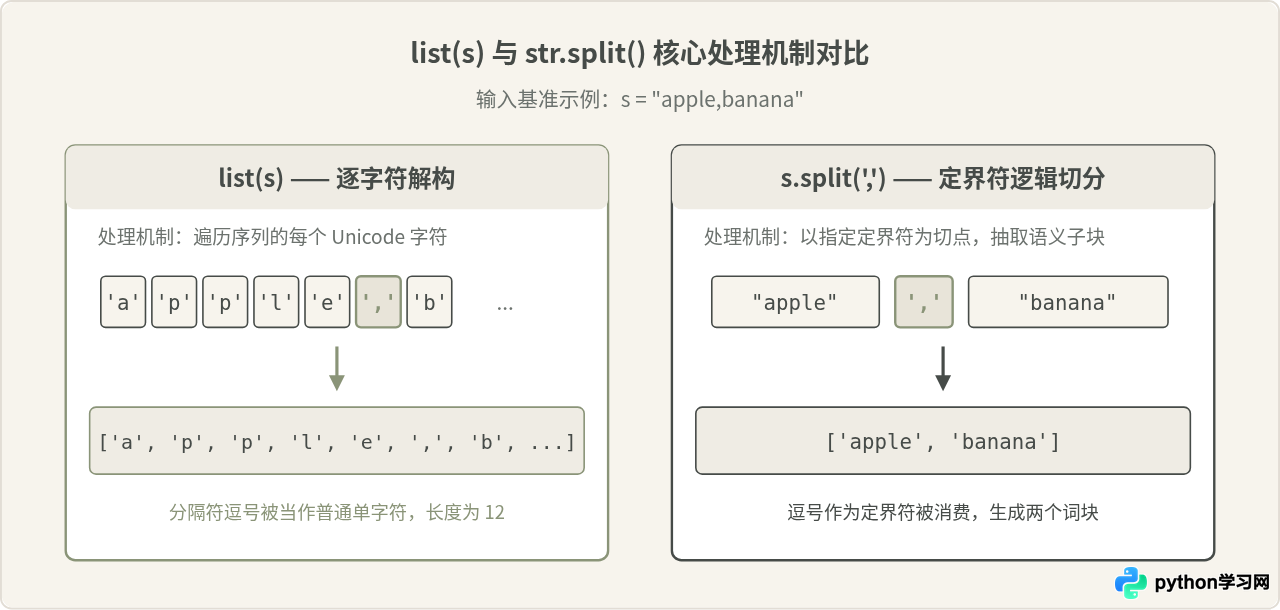
字符串在 Python 内部属于不可变序列对象(Sequence)。理解 list() 与 split() 的本质差异,需要从它们如何看待输入字符串的结构入手。
1. list() 的字符级迭代解构
list() 是 Python 的内置类构造函数,它接受任意可迭代对象(Iterable)作为参数,并在内部依序调用迭代器协议(调用 __iter__() 与 __next__())。因为字符串本身是由一个个 Unicode 字符构成的序列,list("hello") 会按顺序取出每一个单字符,直接装入新创建的列表中。该过程完全不考虑标点符号、空格或单词边界,任何符号都会被视作同等地位的独立单字符。
2. str.split() 的定界符逻辑切分
str.split(sep=None, maxsplit=-1) 是字符串对象专有的方法。它的核心逻辑是扫描与截取:根据指定的定界符 sep 扫描整个字符串,将定界符两侧的有效内容切片为子串并放入列表,而定界符本身会被消费并丢弃。因此,split() 保留了子串的块状结构,适合提取具有业务含义的数据单元(如句子中的单词、CSV 文件中的字段、URL 的路径层级)。
二、str.split() 的核心参数与切分流程
str.split() 支持两个关键参数:sep(分隔符)与 maxsplit(最大切分次数)。在实际开发中,是否传递 sep 会引发截然不同的算法分支:
- 默认参数
split()(即sep=None):执行连续空白折叠算法。会自动去除字符串首尾的所有空白字符,并将中间任意连续的空格、制表符(\t)和换行符(\n)统一视为单一的分隔界标。 - 显式参数
split(sep):执行严格字面量匹配算法。不会折叠空白,也不剔除首尾字符。如果定界符在首尾或连续出现,会切分出长度为 0 的空字符串""。 - 限制切分
maxsplit=N:切分操作在完成 N 次匹配后立即停止,字符串剩余部分将作为列表的最后一项原样输出。这在解析形如"key=value1=value2"的配置文本时极为高效。
# 示例代码:split() 的三种主要调用方式
raw_text = "   Python   Rust    Go   "
print(raw_text.split())
# 示例输出: ['Python', 'Rust', 'Go'] (首尾空白清除,中间连续空白合并)

csv_row = "item1,,item3,"
print(csv_row.split(','))
# 示例输出: ['item1', '', 'item3', ''] (严格按逗号切分,保留空字段)

kv_pair = "domain=api.example.com=production"
print(kv_pair.split('=', maxsplit=1))
# 示例输出: ['domain', 'api.example.com=production'] (仅切分一次,保护后续值)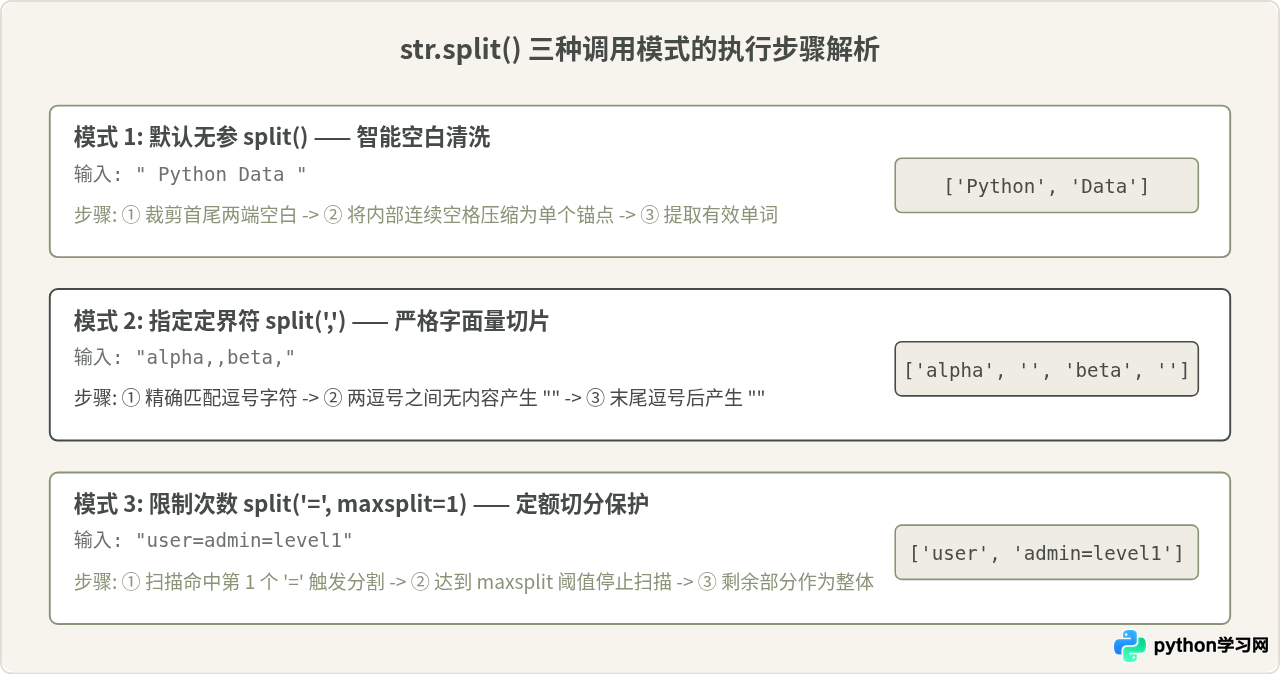
三、常见误区与边界情况辨析
在日常开发中,由于对参数原理认识不清,容易产生以下三类典型误区:
1. 误区:认为 split() 与 split(' ') 等价
这是初学者最容易混淆的细节。有人认为“无参 split() 就是以空格分割”。实际上:
split()(无参):按“任意连续空白(空格、制表符、回车换行)”切分,首尾空格会被直接消除,绝不产生空字符串元素。split(' ')(传单空格):严格按“单个 ASCII 空格(0x20)”切分。首尾若有空格,或者出现连续双空格,会在列表中产生空字符串""。
test_str = " a  b "
print(test_str.split())     # 示例输出: ['a', 'b']
print(test_str.split(' ')) # 示例输出: ['', 'a', '', 'b', '']
2. 误区:试图使用 list() 解析带标点的字符串
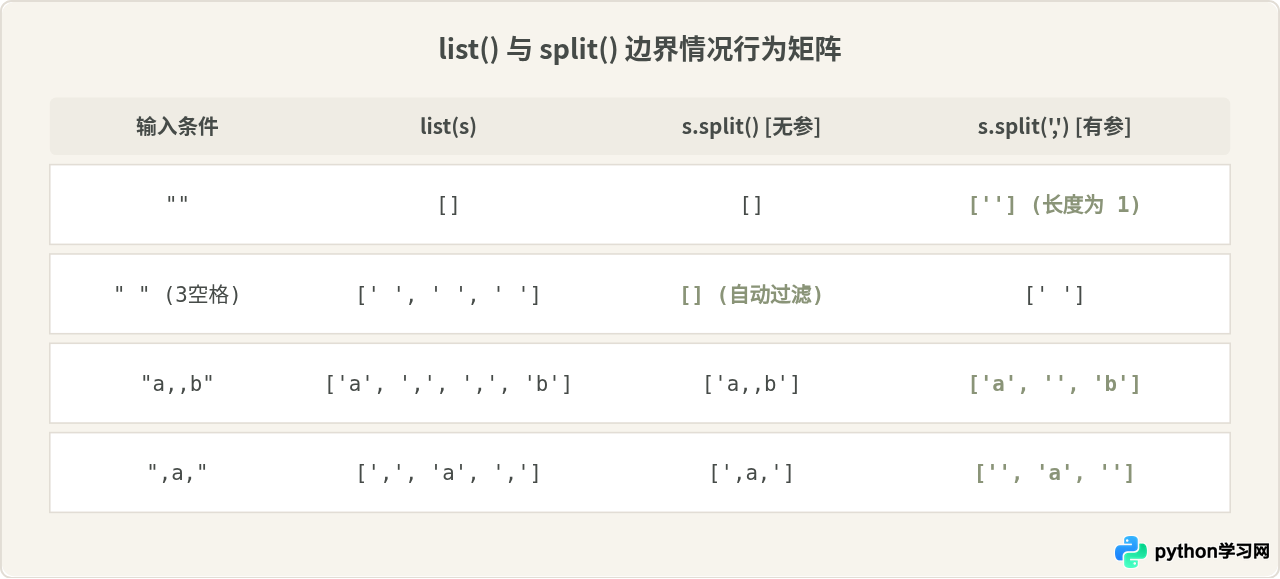
当面对形如 "1,2,3,4" 的数字串时,如果错误使用 list("1,2,3,4"),得到的结果是 ['1', ',', '2', ',', '3', ',', '4']。逗号作为数据载体中的分隔标记,被误当作与业务数据同权的元素存入了列表中,后续转换 int() 会直接引发 ValueError。正确的做法始终是使用 s.split(',')。
3. 空字符串输入下的边界差异
处理未初始化的变量或空文本输入时,三个操作的行为各不相同:
list("")返回空列表[]。"".split()返回空列表[]。"".split(",")返回包含一个空字符串的列表['']。因为在指定分隔符模式下,即使找不到定界符,整个原字符串也会作为切片后的唯一元素保留。
四、典型应用场景与选型决策指南
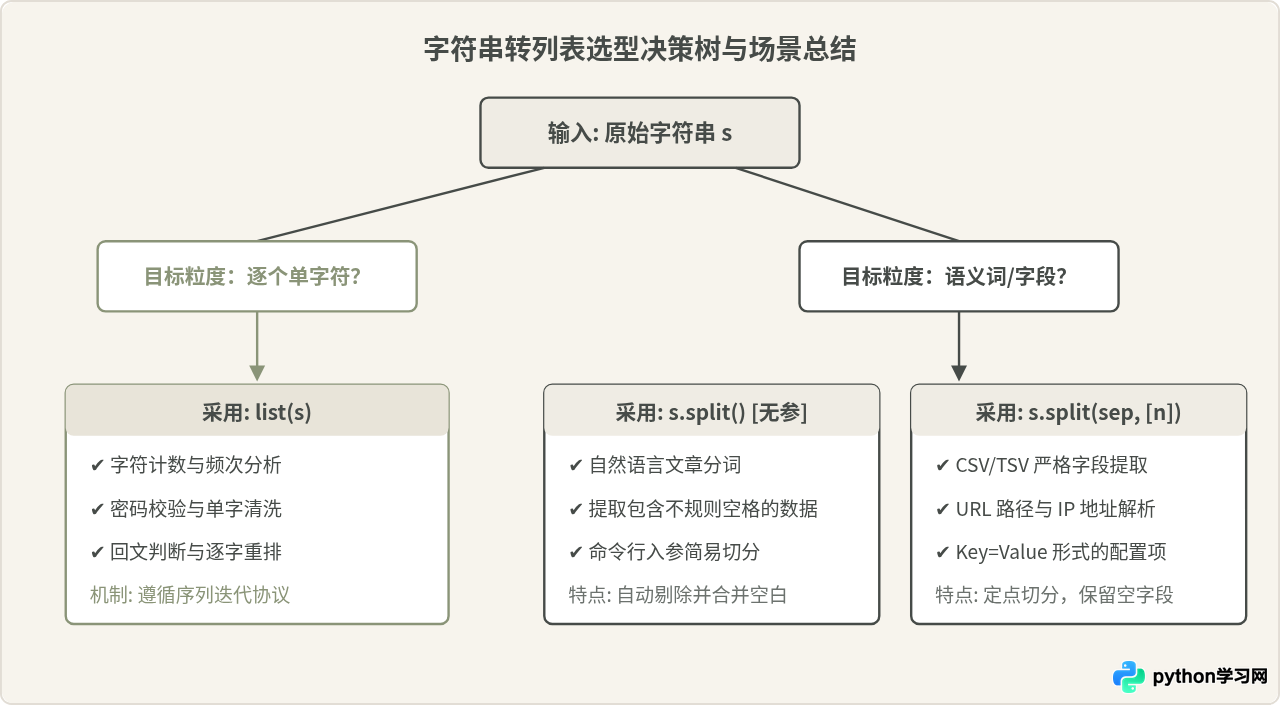
为了在工程开发中做出最优选择,可以根据业务需求中期望的转换目标粒度进行决策。
1. 必须使用 list() 的场景
- 字符级算法操作:例如回文字符串检验、字符原地反转、打乱字符串(配合
random.shuffle)。 - 字符频次与集合运算:快速统计字符分布(如
collections.Counter(list(s)))或去重(set(list(s)))。 - 逐字符加密/转换:例如凯撒密码加密、摩斯电码逐字符转换。
2. 推荐使用 str.split() 的场景
- 结构化文本与数据表解析:处理 CSV、TSV 文本,或者以竖线
|、分号;隔开的表格行。 - 自然语言单词抽取:利用
s.split()自动过滤多余空格与换行,获取标准的词汇列表。 - 键值对或定长配置解析:利用
s.split('=', 1)快速分离配置项的 Key 与 Value,避免配置值中自带等号引发的解析崩坏。 - URL、文件路径与网络协议分段:如通过
url.split('/')或ip.split('.')提取特定层级的节点。
注意:如果面临由多种复杂符号混合分隔的文本(例如同时以逗号、分号和空格分割),split() 需多次嵌套调用。此时应优先考虑使用标准库的 re.split(r'[,; ]+', text) 正则分割。
五、方法特性对照与总结
为了便于速查,下表整理了 list() 与 split() 在关键维度的完整行为差异:
| 对比维度 | list(str) | str.split() [无参数] | str.split(sep) [指定参数] |
|---|---|---|---|
| 转换粒度 | 单个 Unicode 字符 | 单词/词块(按空白聚集) | 字段/子串(按定界符切断) |
| 切分依据 | 可迭代对象逐项迭代 | 任意连续空白字符(空格/制表/换行) | 指定的精确字符串字面量 |
| 连续定界符表现 | 所有定界符原样成为独立单字符 | 自动合并,视作单个分隔界标 | 保留相邻之间的空字符串 "" |
| 首尾多余分隔符 | 首尾符号均原样保留为列表元素 | 自动清除首尾空白,不产生空元素 | 在列表头或尾产生空字符串 "" |
空字符串 "" 输入 |
返回空列表 [] |
返回空列表 [] |
返回包含单项的列表 [''] |
| 定界符自身去向 | 保留在列表中(作为单字符元素) | 完全丢弃 | 完全丢弃 |
掌握两者的差异,本质在于理解数据源的逻辑结构。如果是面向字符级运算(如算法、加密、校验),选择 list();如果是面向语义文本或结构化数据解析(如日志提取、参数分割、表格清洗),则应选用 str.split(),并依据实际业务是否允许空字段正确设置 sep 与 maxsplit 参数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















