


LLaMA-Factory与HuggingFace Transformers:大模型微调框架怎么选

在大模型应用落地的浪潮中,微调(Fine-tuning)已成为连接通用基座模型与垂直领域需求的桥梁。然而,当开发者站在起跑线上时,往往面临一个经典的工程取舍:是追求极致的开发速度,使用封装良好的“全家桶”工具一键启动?还是深入底层,利用基础库构建完全可控的训练流水线?
LLaMA-Factory 和 HuggingFace Transformers 代表了这两种截然不同的哲学。前者像是一间装修精良、设备齐全的中央厨房,厨师只需关注食材搭配;后者则是一个拥有无限可能性的原材料仓库,你需要自己搭建灶台、控制火候。没有绝对的优劣,只有与当前团队能力、项目周期和技术债务的匹配度。
快速原型验证:LLaMA-Factory 的“开箱即用”红利
对于初创团队或需要在一周内拿出Demo的项目经理来说,时间是最昂贵的成本。LLaMA-Factory 的核心价值在于它将数据预处理、模型加载、训练策略配置和结果评估整合在一个统一的Web界面和命令行工具中。
在这种场景下,你不需要关心 Trainer 类的初始化参数,也不需要手动编写数据_collate_ 函数。只需准备一份符合格式的JSONL数据集,在Web UI中选择基座模型(如Llama-3或Qwen),勾选LoRA或QLoRA策略,点击“开始训练”,系统便会自动处理背后的分布式逻辑和显存优化。
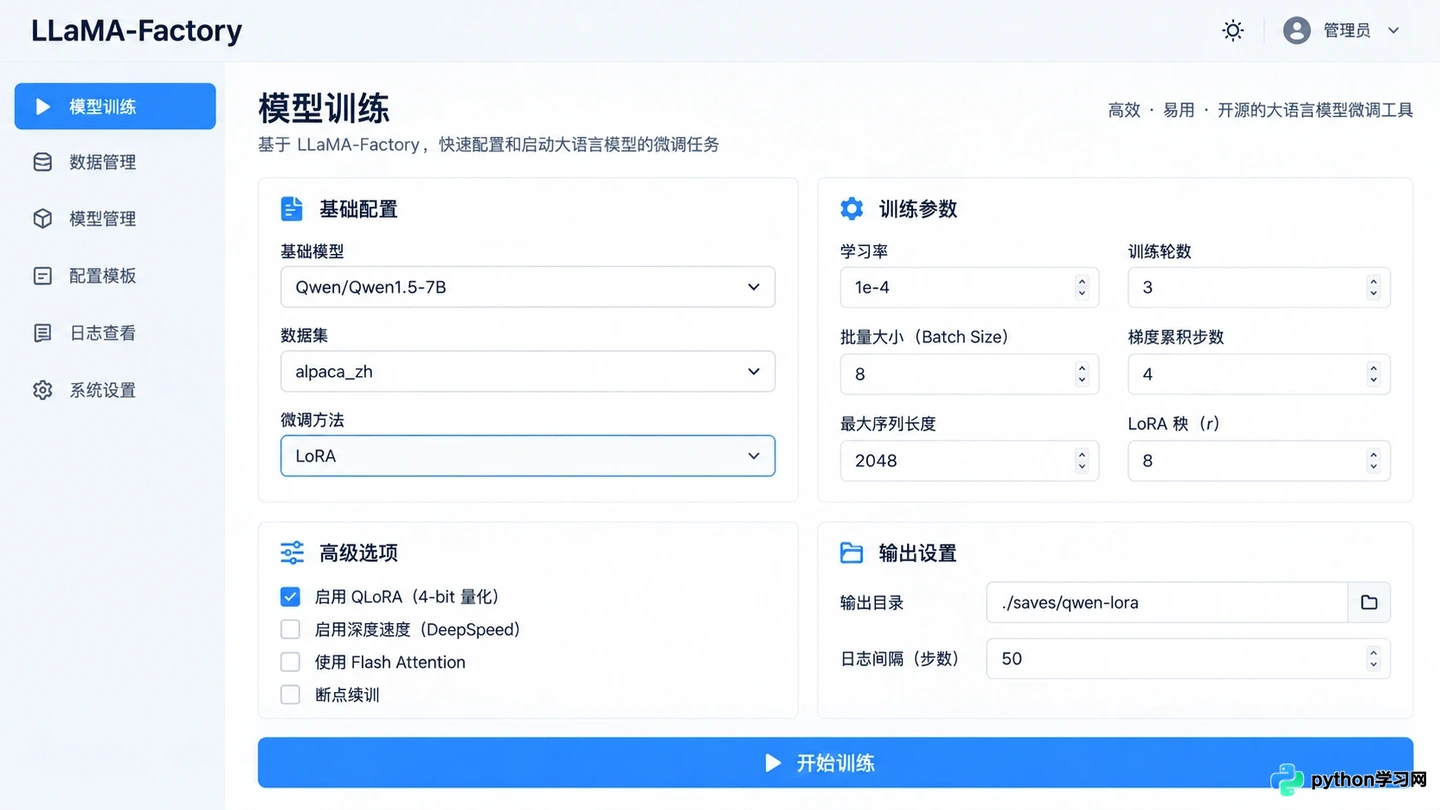
LLaMA-Factory 提供直观的 Web 界面,用户可通过下拉菜单选择模型、数据集及 LoRA 参数,无需编写代码即可启动训练任务。
这种“所见即所得”的体验极大地降低了门槛。它内置了对主流高效微调技术(如LoRA、DoRA)的支持,并自动处理了混合精度训练和梯度累积等复杂设置。对于大多数标准指令微调任务,LLaMA-Factory 提供的默认超参数已经经过社区广泛验证,能够产出可用的基准模型。
但这并不意味着它是万能的。 当你的数据格式极其特殊,或者需要引入复杂的动态采样策略时,LLaMA-Factory 的配置项可能会显得捉襟见肘。此时,你实际上是在试图用图形界面的有限选项去解决一个需要代码级干预的问题,这往往会导致更多的挫败感。
深度定制与科研探索:Transformers 的代码自由度
如果你是一名算法研究员,或者正在解决一个前所未有的NLP难题,HuggingFace Transformers 才是你的主战场。它不是一个“框架”,而是一个构建块集合。在这里,没有预设的训练循环,一切皆由代码定义。
使用 Transformers 进行微调,意味着你需要亲自编写或继承 Trainer 类,手动管理数据加载器(DataLoader),并精确控制每一个训练步骤。这种繁琐带来了极高的回报:你可以轻松地在损失函数中加入自定义的正则化项,可以在特定层注入特殊的注意力机制,或者实现复杂的课程学习(Curriculum Learning)策略。
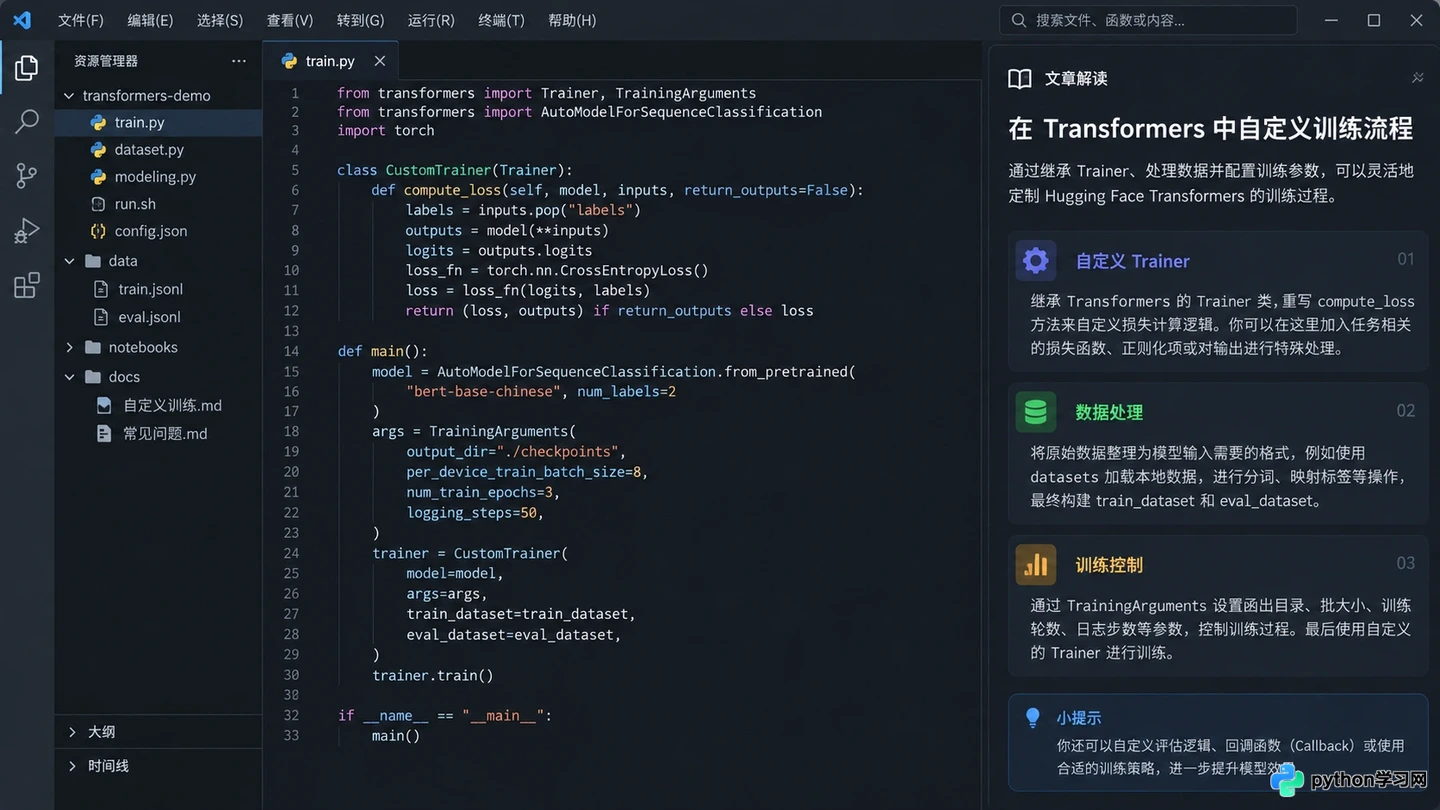
在 Transformers 中,开发者通过编写 Python 代码自定义 Trainer 类和数据处理逻辑,实现对训练过程的精细控制。
例如,在处理长文本上下文时,你可能希望动态调整注意力掩码的计算方式,或者在多任务学习中为不同任务分配动态权重。在 LLaMA-Factory 中,这可能需要修改源码甚至等待官方更新;而在 Transformers 中,这只是几行 PyTorch 代码的差异。
灵活性的代价是高昂的工程维护成本。 你需要自己处理分布式训练的环境变量配置,自己监控显存泄漏,自己编写评估脚本。对于缺乏深厚深度学习工程经验的团队,这可能导致项目长期停滞在“环境配置”和“Bug调试”阶段,而非模型优化本身。
工程化落地与生态兼容:从训练到部署的链路考量
选择微调工具不仅关乎训练过程,更关乎模型如何融入现有的生产环境。HuggingFace 生态系统最大的优势在于其无缝的互操作性。使用 Transformers 训练的模型,天然兼容 HuggingFace Hub、PEFT 库以及各类推理引擎(如 vLLM、TGI)。
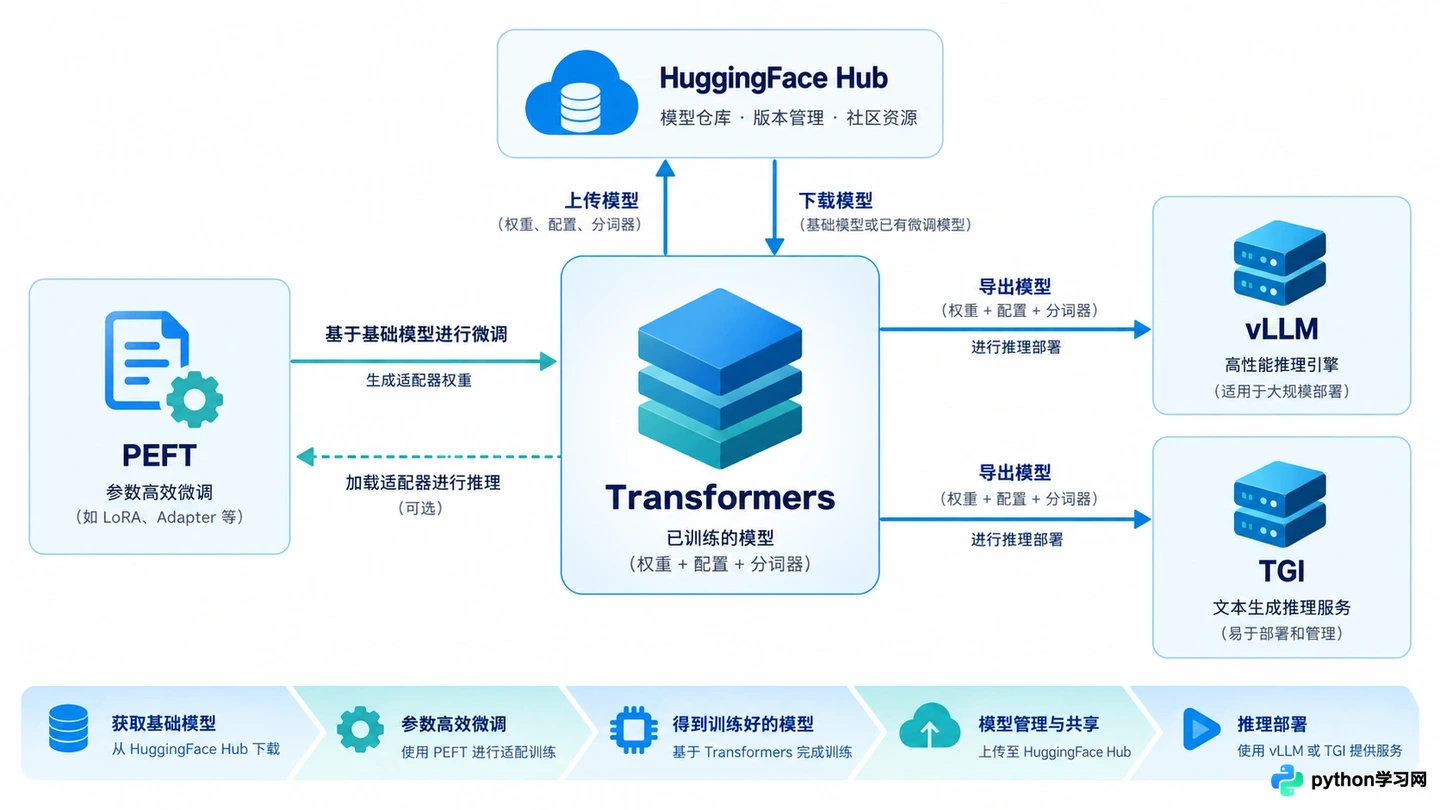
Transformers 训练的模型可无缝对接 HuggingFace Hub、PEFT 库及多种推理引擎,形成完整的工程化链路。
LLaMA-Factory 虽然也基于 Transformers 构建,但其输出格式和配置文件结构具有一定的私有性。虽然它支持导出为标准格式,但在某些极端情况下,特别是涉及复杂的适配器合并或量化后处理时,可能需要额外的转换步骤才能被生产环境的推理服务完美识别。
此外,团队的技术栈惯性也是一个关键因素。如果团队已经熟练掌握了 PyTorch 和 Transformers 的工作流,强行引入 LLaMA-Factory 可能会造成知识断层。反之,如果团队主要由应用层开发者组成,缺乏底层调优经验,LLaMA-Factory 提供的标准化流程能有效减少人为错误,保证模型产出的稳定性。
决策建议:根据项目阶段动态选择
回到最初的取舍,我们不应将二者视为非此即彼的对立面,而应视为工具链中的不同环节。
对于从0到1的探索期,或者资源有限、追求快速迭代的中小型项目,LLaMA-Factory 是更优的选择。它能让你在最短时间内验证数据质量和模型能力的边界,将精力集中在业务逻辑和数据清洗上,而不是基础设施的搭建上。
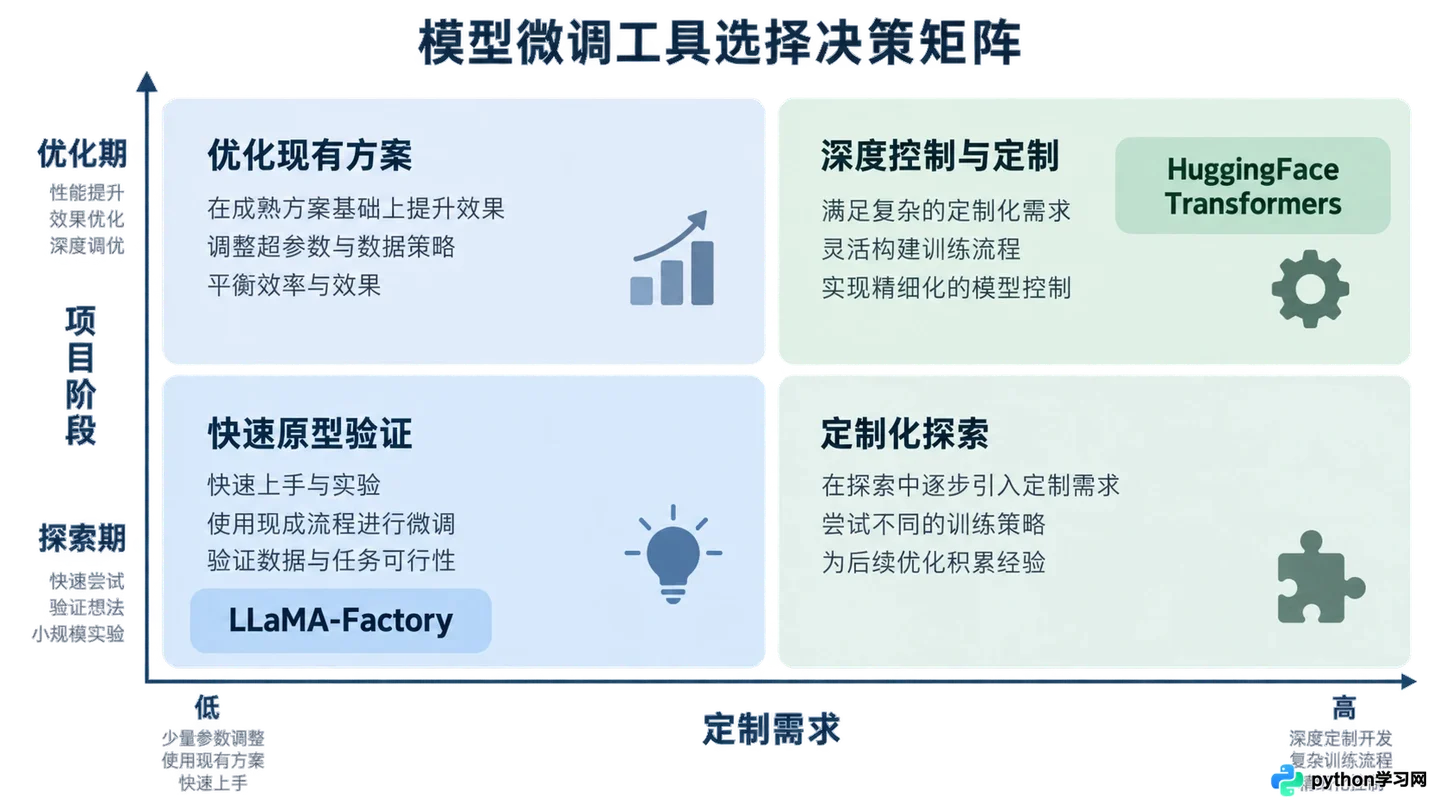
根据项目所处的探索期或优化期,以及团队对底层控制的需求程度,选择合适的微调框架。
对于从1到N的优化期,或者对模型性能有极致要求、需要发表学术成果的大型项目,HuggingFace Transformers 提供了必要的掌控力。当默认策略无法满足需求,当每一分算力的提升都至关重要时,底层的代码控制权就是核心竞争力。
最终的判断标准很简单: 你是否清楚自己需要修改训练过程中的哪一个具体环节?如果答案是“不知道,我想先看看效果”,请选择 LLaMA-Factory;如果答案是“我需要修改第12层的梯度更新规则”,请打开你的 IDE,导入 Transformers。
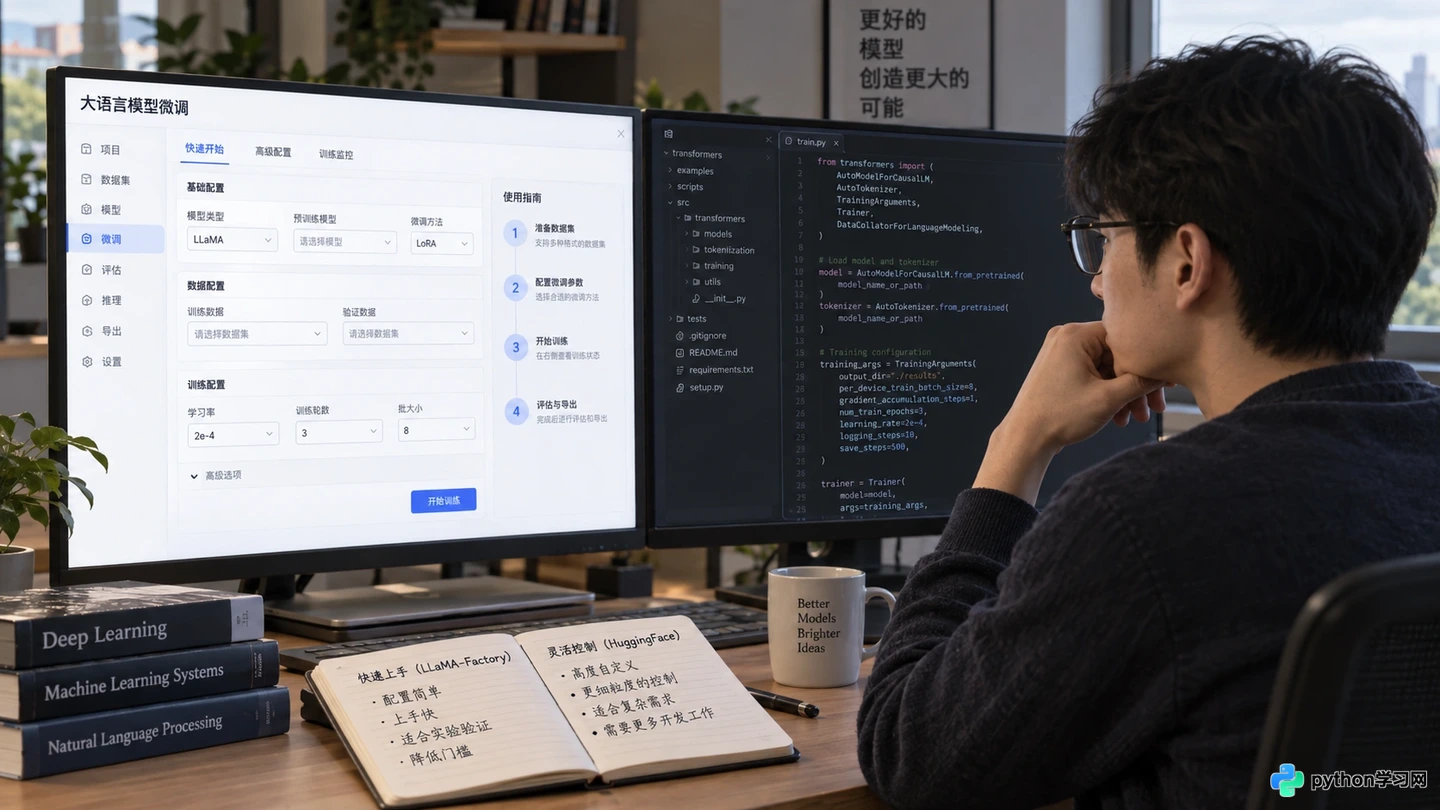
技术选型应服务于消除当前瓶颈,开发者需根据实际需求在效率与控制力之间找到平衡点。
技术选型的本质不是寻找最好的工具,而是寻找最能消除当前瓶颈的工具。在大模型微调的道路上,有时候“快”就是好,有时候“准”才是硬道理。认清自己的位置,才能让工具真正服务于价值创造。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















