


国产大模型排名现状:通义千问、文心一言与智谱GLM的中文能力对比

在当前的国产大模型格局中,单纯依据榜单分数已难以全面反映模型的实际可用性。对于中文用户而言,真正的“排名”取决于模型能否精准理解含蓄的语境、高效处理超长文档以及无缝对接本土业务流。通义千问、文心一言与智谱GLM作为第一梯队的代表,各自在中文能力的不同侧面建立了护城河。本文将剥离营销术语,直接通过典型任务场景,还原这三款模型在中文理解与本土化服务上的真实排位与差异。
1. 核心定位与中文语料根基
要理解排名的底层逻辑,首先需看清各模型的“出身”与训练侧重。这决定了它们在处理特定中文任务时的先天优势。
通义千问(Qwen)由阿里云研发,其核心优势在于庞大的工程化数据与代码语料。它在中文互联网公开数据的基础上,深度融合了阿里生态内的电商、物流及企业级文档数据。这使得它在处理结构化信息、商业逻辑推理以及多语言混合的中文场景时,表现出极强的稳定性。
文心一言(Ernie Bot)依托百度多年的搜索积累与知识图谱。它的强项在于对中文事实性知识的覆盖广度,以及对网民实时热点的快速响应。由于百度索引覆盖了绝大多数中文网页,文心一言在回答涉及最新新闻、百科常识及本土文化梗的问题时,往往能提供更符合中文用户直觉的答案。
智谱GLM(ChatGLM)源自清华大学技术成果,主打学术严谨性与逻辑推理。其训练数据中包含了大量高质量的中文教材、论文及专业书籍。因此,在需要深度思考、复杂逻辑推导或专业领域问答的场景下,智谱GLM常展现出比通用聊天模型更严密的思维链条。
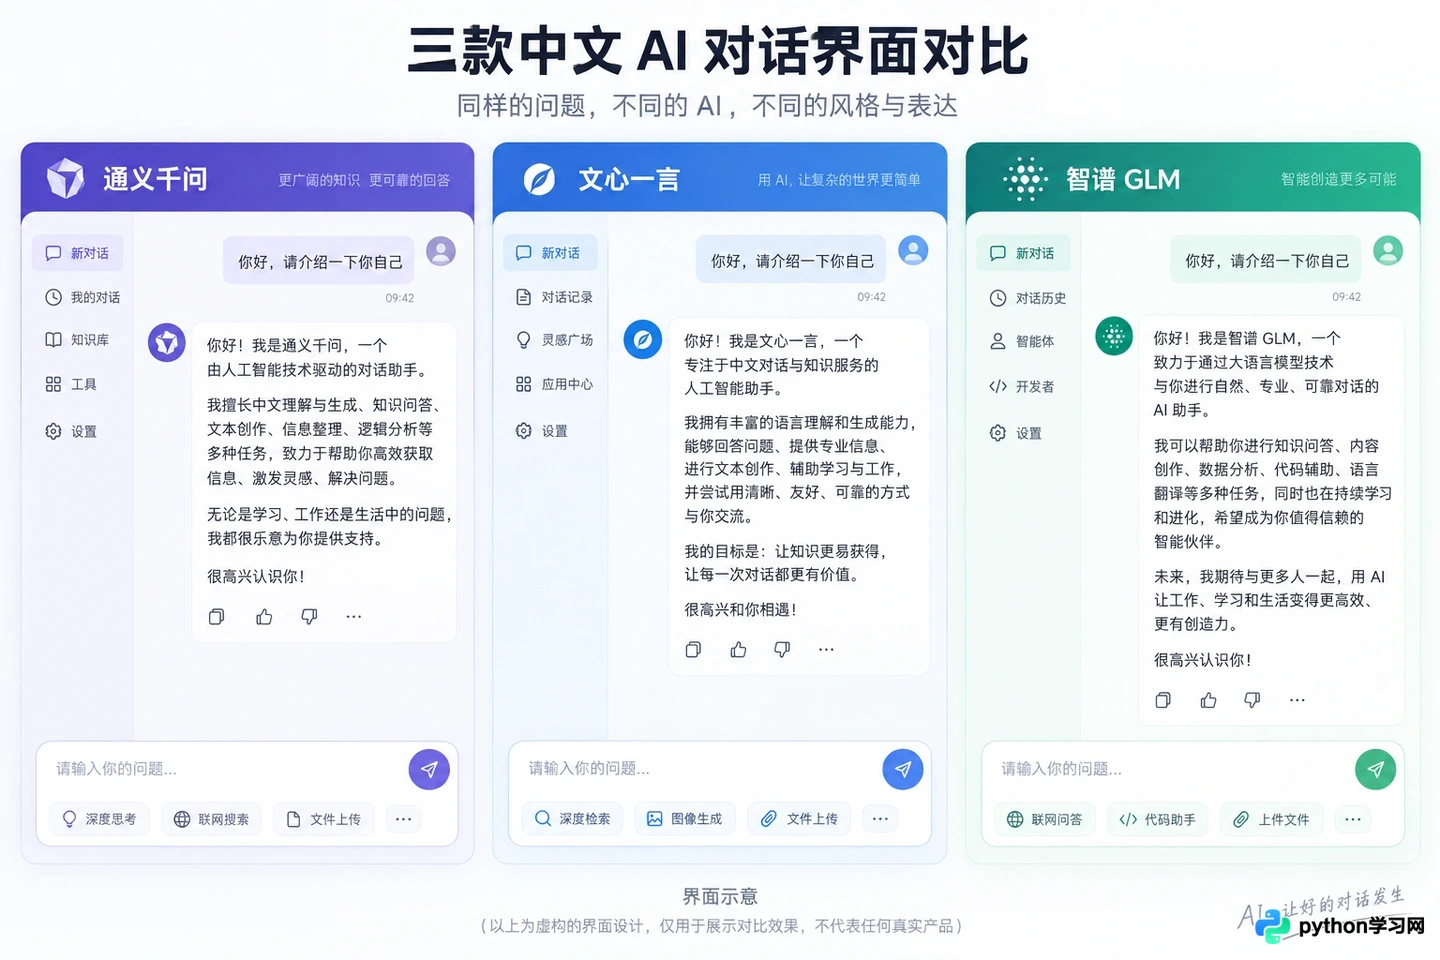
通义千问、文心一言与智谱GLM的交互界面对比
2. 长文本理解与信息提取能力对比
随着中文办公场景数字化,处理万字以上的报告、合同或会议纪要成为刚需。这一维度的表现直接影响了模型在生产力工具中的排名。
在实际测试中,让三款模型同时阅读一份5万字的中文行业研报并提取关键数据。通义千问凭借其对长上下文窗口的优化,能够准确锁定分散在文档不同章节的财务数据,且极少出现“幻觉”混淆。它对表格数据的解析能力尤为突出,能直接将非结构化的文本描述转化为清晰的Markdown表格。
文心一言在处理此类任务时,更擅长总结文档的核心观点与情感倾向。如果任务是“提炼这份报告的市场情绪”,文心一言的回答通常更具概括性和可读性,适合快速浏览。但在精确数值提取上,偶尔需要二次确认。
智谱GLM则表现出对逻辑关联的敏感度。当文档中存在前后矛盾的数据时,智谱GLM更有可能指出这种不一致,而不仅仅是提取数据。对于需要批判性阅读的学术或法律文档,智谱GLM的严谨性使其在这一细分赛道名列前茅。
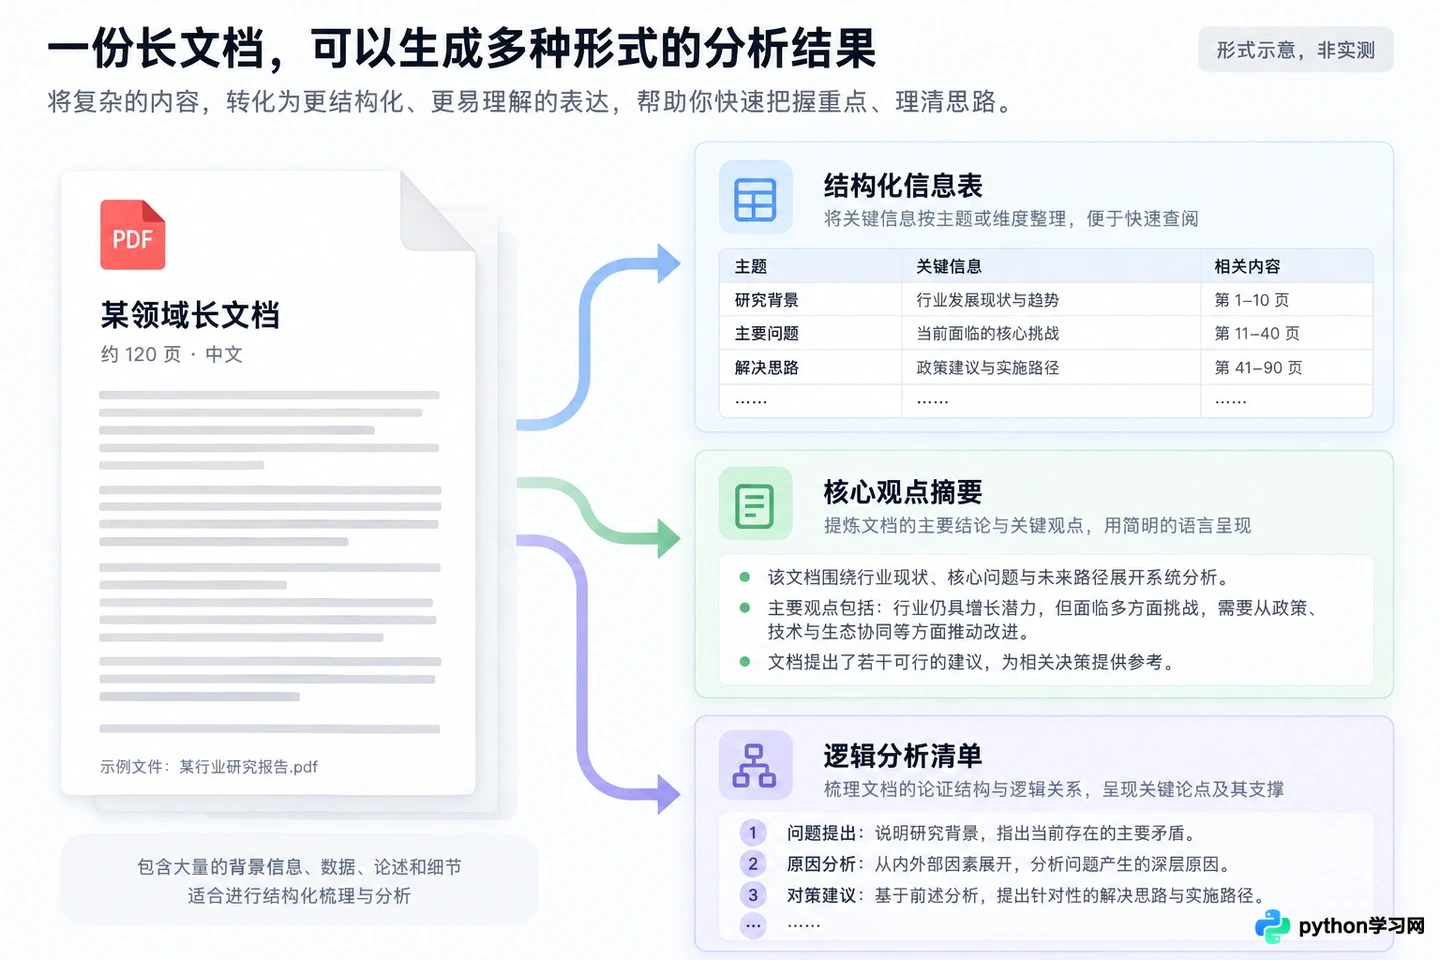
长文档关键信息提取效果示意
3. 复杂逻辑推理与代码生成表现
中文语境下的逻辑推理不仅涉及数学,还包含对中文特有句式、隐喻及行业黑话的理解。这是检验模型“智商”的关键试金石。
在编写Python脚本处理中文Excel数据时,通义千问展现了极高的准确率。它能准确理解“将‘销售额’列中带有‘万’字的字符串转换为数值”这类具有中国特色的数据处理需求,生成的代码可直接运行,注释也符合中文开发者的习惯。
智谱GLM在算法题和复杂逻辑谜题上表现优异。面对需要多步推导的逻辑题,它倾向于输出详细的思维链(Chain of Thought),逐步拆解问题。这种透明化的推理过程,让用户更容易信任其结论,尤其在教育辅助和科研场景中备受青睐。
文心一言在创意逻辑和日常问题解决上更为灵活。例如,当要求“用鲁迅的风格写一段关于加班的吐槽”时,文心一言能更精准地捕捉到中文文学风格的细微差别,生成的文本更具韵味和感染力。它在创意写作和本土化文案生成方面,目前仍占据领先地位。
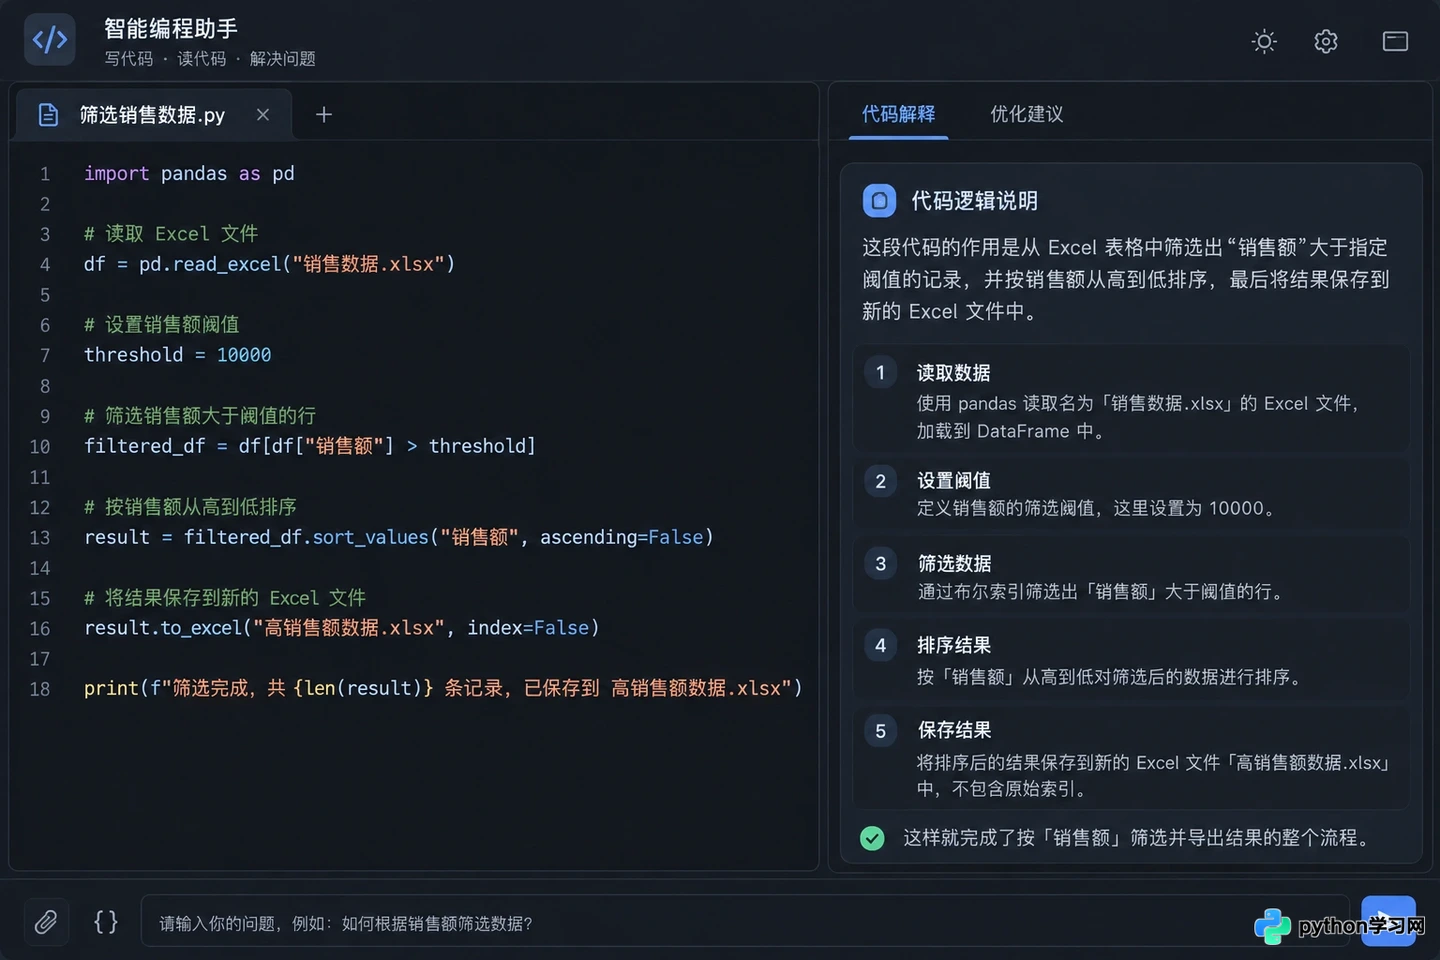
代码生成与逻辑推导过程展示
4. 本土化服务与生态集成优势
模型的最终价值体现在能否融入工作流。这一维度的排名,取决于模型背后的生态系统支持。
通义千问深度集成于钉钉、阿里云等平台。对于企业用户,这意味着可以直接在钉钉群聊中调用千问分析群文件,或在阿里云控制台中自然语言查询资源状态。这种“模型即服务”的无缝体验,使其在企业级应用中排名靠前。
文心一言与百度搜索、百度网盘及百度文库打通。用户可以在搜索过程中直接获得由文心一言生成的总结,或在网盘中直接对话文档内容。对于依赖百度生态的个人用户和内容创作者,文心一言提供了最便捷的知识获取路径。
智谱GLM则通过开放API和开源策略,吸引了大量开发者构建垂直应用。许多中文领域的专业工具,如法律助手、医疗咨询插件,底层均接入了智谱GLM。虽然它没有庞大的C端入口,但在B端定制化开发和私有化部署领域,其灵活性和专业性使其成为众多技术团队的首选。
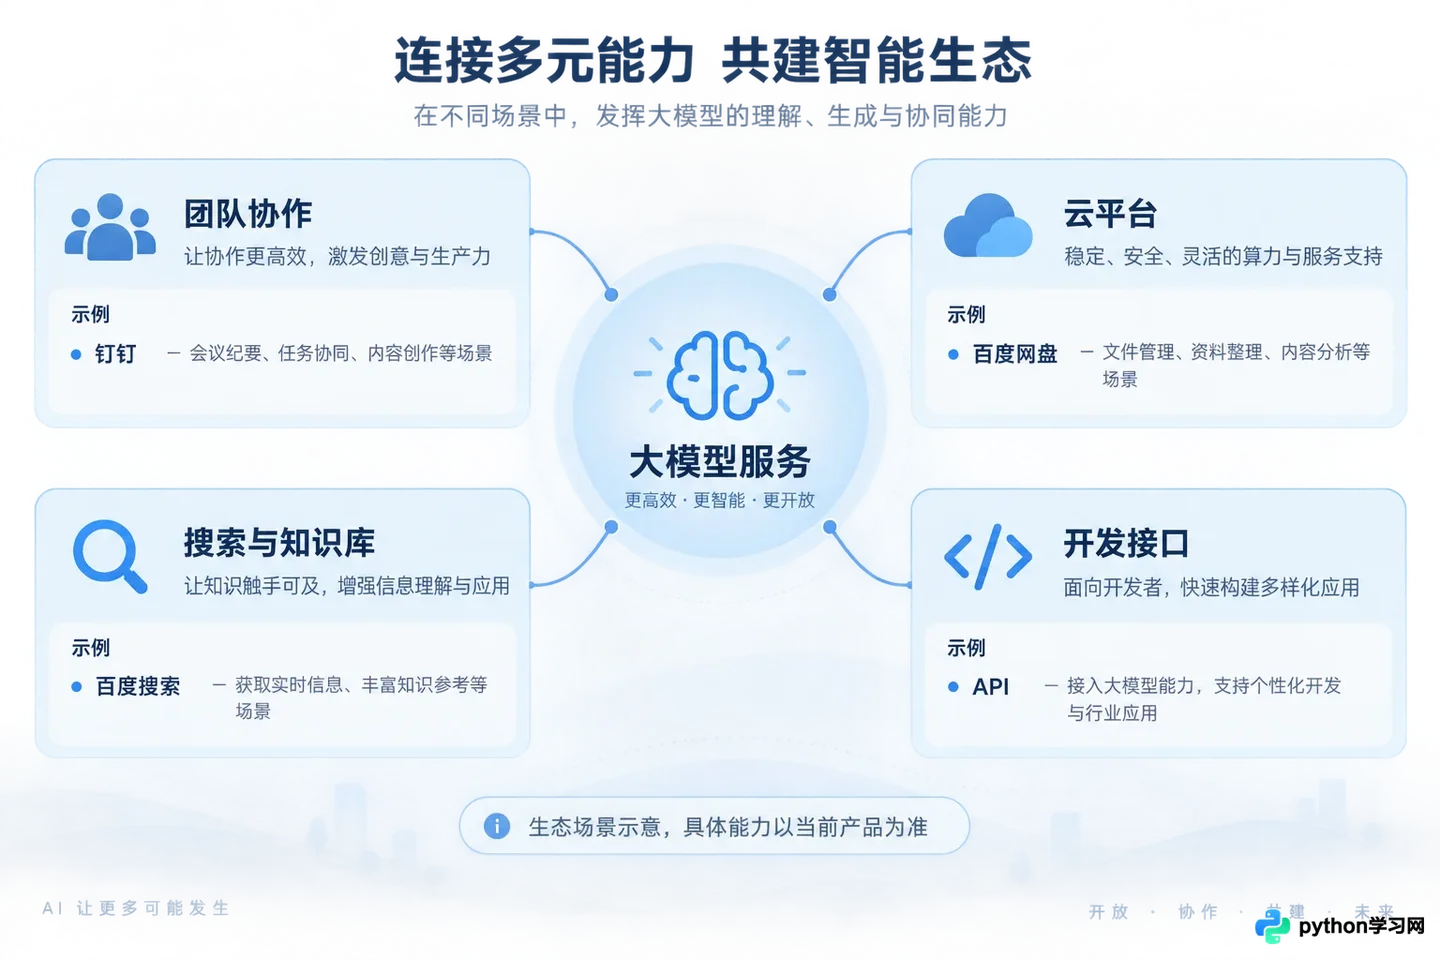
模型与本土办公软件的集成场景
5. 最终选型建议与验证
不存在绝对的“第一”,只有最适合场景的模型。验证你的选择是否正确,只需关注以下三个信号:
- 准确性验证:在处理关键数据时,观察模型是否主动提供来源引用或指出不确定性。通义千问和智谱GLM在此方面表现较好。
- 风格适配度:检查生成的中文文本是否符合目标受众的阅读习惯。文心一言在通俗化和创意化表达上更具优势。
- 工作流顺畅度:评估模型是否能直接读取你常用的文件格式,并输出可编辑的结果。根据你的主要办公平台(阿里系、百度系或独立开发环境)进行选择。
保留好你的测试提示词(Prompt)和典型文档样本。随着模型版本的快速迭代,定期用这些固定样本重新测试,是确保你始终使用最优工具的唯一方法。国产大模型的竞争仍在加速,今天的排名可能在下一个版本更新后就会发生微调,但核心的差异化优势将在较长时间内保持稳定。
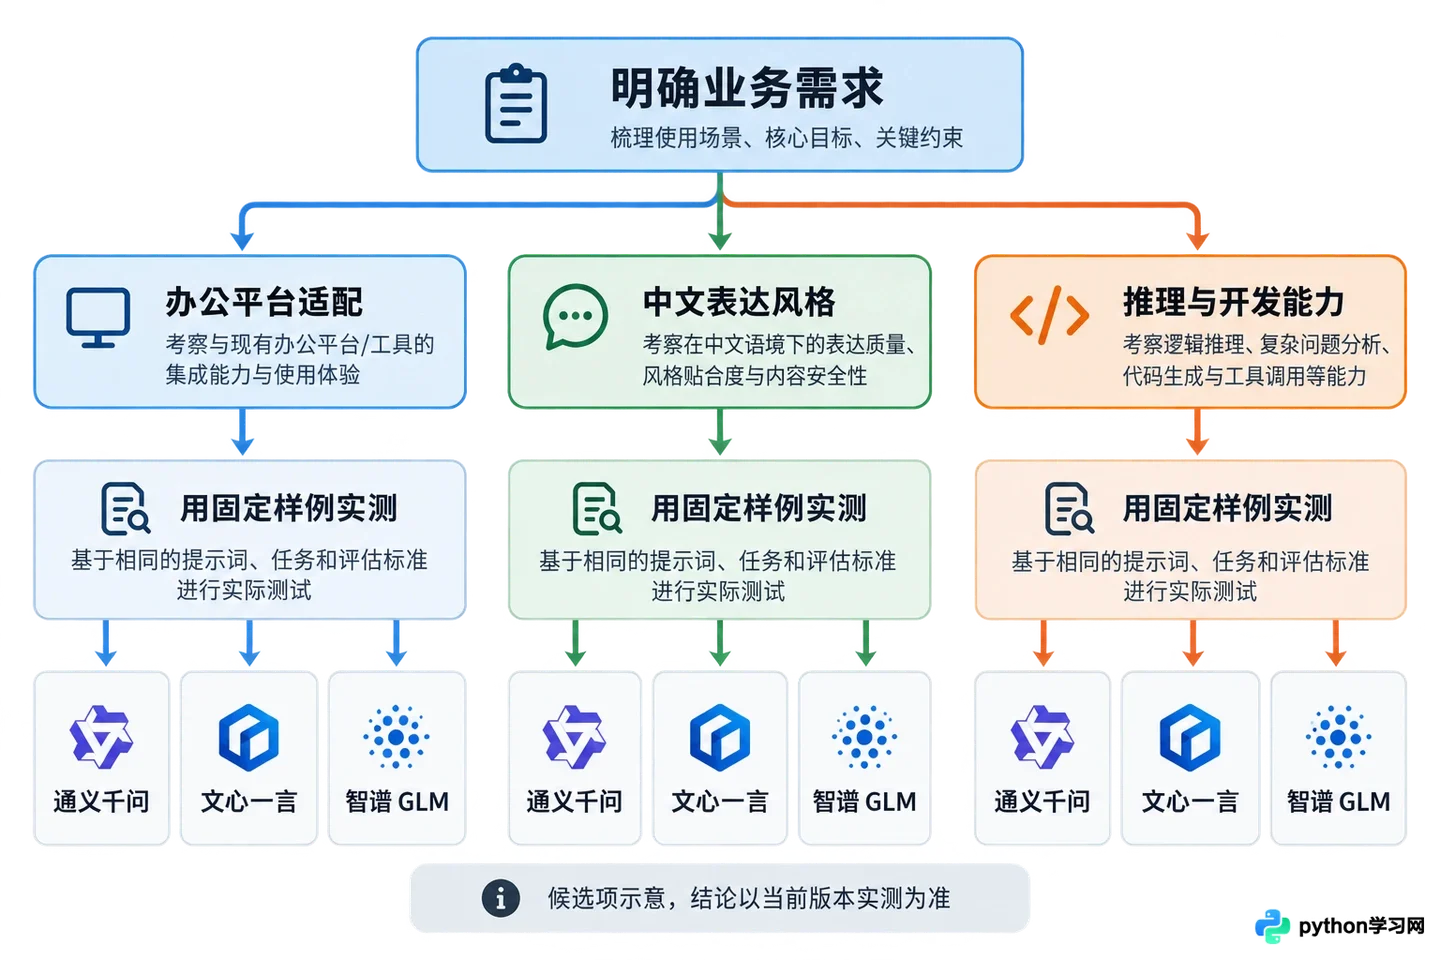
基于场景的大模型选型决策路径
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















