


Python读取Excel转字典时怎么处理空值和日期

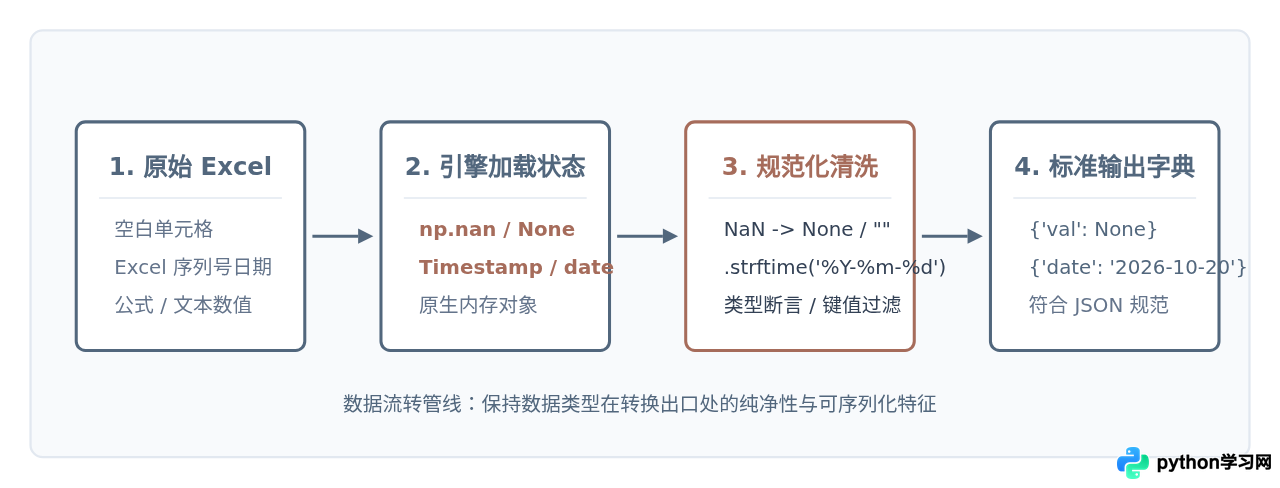
在 Python 数据处理中,将 Excel 表格数据读取并转换为字典结构是一种常见需求,通常用于后续的接口对接、数据校验或入库操作。然而直接调用库函数转换时,最常遇到的两个破坏性问题就是空值与日期:Excel 中的空单元格在 Pandas 中会被默认加载为浮点型 numpy.nan,在 openpyxl 中则是 None;而日期字段在不同引擎下会被表示为 Timestamp 或 datetime.datetime 对象。如果不加以规整,转换出的字典在进行 JSON 序列化(如 json.dumps())时会直接抛出 TypeError 或生成不规范的 NaN 字符。核心解决思路在于:在字典组装前或生成过程中,建立类型断言与清洗规则,将空值统一收敛为合法的 None、空字符串或剔除键,同时将时间对象显式格式化为标准 ISO 日期字符串。
一、为什么空值和日期是转换字典的主要障碍
Excel 的底层存储逻辑与 Python 内存数据模型存在本质差异。在 Excel 中,日期实质上是从 1900 年(或 1904 年)算起的连续浮点序列数,仅通过单元格数字格式样式(Number Format)渲染为人眼可读的时间样式。而空白单元格既没有明确的值类型,又常常带有格式残留。
当借助不同库进行解析时,表现差异显著:
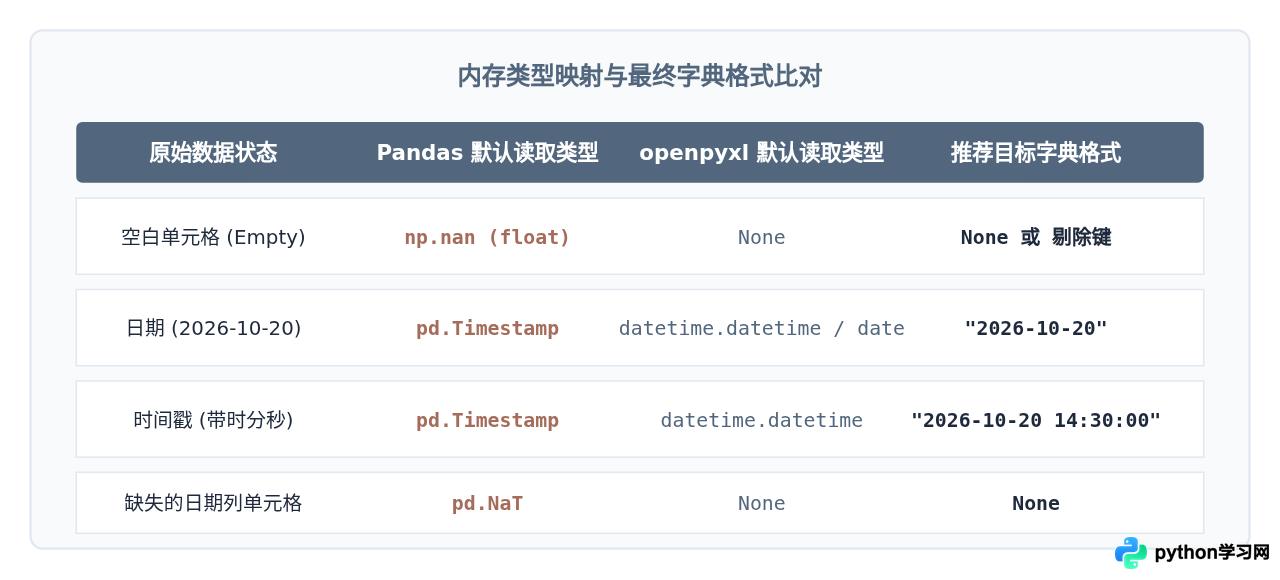
- Pandas 库:为了保持底层 NumPy 数组的高性能连续内存,Pandas 默认会将包含空单元格的数值或混合列提升为浮点类型,并将空值填补为
numpy.nan(Not a Number)。在 Python 中,nan != nan且无法被标准库json.dumps()正确序列化为null;同时,日期列会被转换为pandas.Timestamp,包含空值的日期列则会变成pandas.NaT。 - openpyxl 库:作为更贴近 Excel 原生 XML 结构的库,openpyxl 会将空单元格解析为原生
None,但如果单元格定义了日期格式,它会将其自动解析为 Python 的datetime.date或datetime.datetime对象。当需要把字典输出到前端或发送 HTTP JSON 请求时,这些非基本类型都会引发解析错误。
二、方案一:使用 Pandas 进行向量化清洗与字典生成
当处理规整的表格数据且数据量适中时,Pandas 是最方便的高效工具。很多人在转换字典时直接执行 df.to_dict(orient='records'),这会导致生成的列表中遍布 nan 和 Timestamp。正确的做法是在转换为字典之前,完成向量化清理。
1. 替换空值为 None 或空字符串
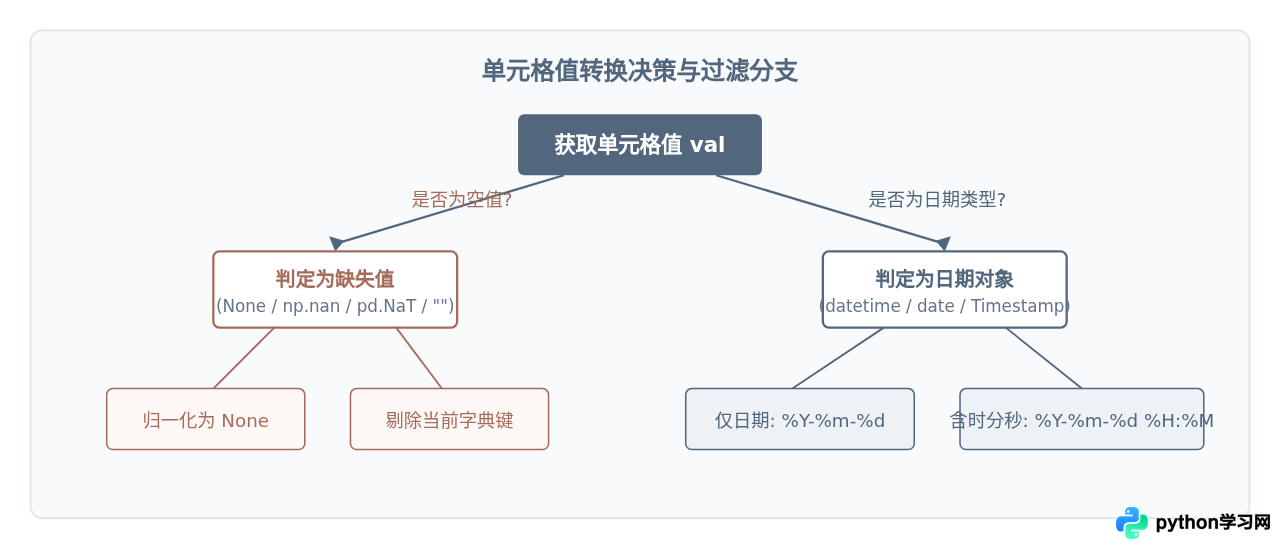
如果业务系统期望在字段缺失时体现为 JSON 的 null,必须将 np.nan 替换为 Python 的原生 None。需要特别注意:直接使用 df.replace(np.nan, None) 在某些较新版本的 Pandas 中可能会因为类型推断机制失效而保留浮点对象,推荐使用 df.where(pd.notnull(df), None) 或利用字典解析二次清洗。
2. 日期格式的向量化规整
在 Pandas 中,可以使用 dt.strftime() 对日期列进行显式转换。如果日期列包含缺失值,格式化操作会将空值转为字符串 "NaT",这依然是不合法的日期。因此应先转换非空日期,再统一规整。
import pandas as pd
import numpy as np

def read_excel_to_dict_pandas(file_path):
    # 1. 读取 Excel,指定日期列解析或自动推断
    df = pd.read_excel(file_path)

    # 2. 识别并格式化日期列
    for col in df.columns:
        if pd.api.types.is_datetime64_any_dtype(df[col]):
            # 格式化日期为 YYYY-MM-DD 字符串,缺失值保留为 None
            df[col] = df[col].apply(lambda x: x.strftime('%Y-%m-%d') if pd.notnull(x) else None)

    # 3. 将其余所有 NaN 浮点空值替换为原生 None
    df = df.where(pd.notnull(df), None)

    # 4. 转为每行一个字典的 records 列表
    records = df.to_dict(orient='records')
    return records

# 示例调用与输出形态
# [{'id': 101, 'name': '张三', 'entry_date': '2026-03-15', 'remark': None},
#  {'id': 102, 'name': '李四', 'entry_date': None, 'remark': '暂未分配'}]
避坑提示:如果表格中某一列是整型 ID,但存在空白单元格,Pandas 默认会将整列强制转为 float64(例如 ID 变成 101.0)。读取时可显式指定 dtype={'id': 'Int64'}(注意大写 I),利用 Pandas 可空整数类型,避免转字典后整数变成浮点数。
三、方案二:使用 openpyxl 进行轻量级逐行精细控制
如果项目没有引入 Pandas 依赖,或者面对超大 Excel 文件时不想占用大量内存,直接使用 openpyxl 以只读模式(read_only=True)读取是更轻量高效的选择。通过定义专用的单元格格式化函数,能够在生成字典的同时完成值过滤。
from openpyxl import load_workbook
import datetime

def format_cell_value(val, date_fmt='%Y-%m-%d', drop_none=False):
    """
    通用单元格格式化函数:
    1. 处理日期与时间类型
    2. 处理空白或 None
    """
    if val is None:
        return None

    # 处理日期时间类型(openpyxl 会自动转换为 datetime 或 date)
    if isinstance(val, (datetime.datetime, datetime.date)):
        return val.strftime(date_fmt)

    # 处理文本中的空字符串
    if isinstance(val, str):
        trimmed = val.strip()
        return trimmed if trimmed != "" else None

    return val

def read_excel_to_dict_openpyxl(file_path, drop_none_keys=False):
    # read_only=True 极大地降低超大文件内存占用
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    sheet = wb.active

    rows = sheet.iter_rows(values_only=True)
    try:
        headers = [str(h).strip() for h in next(rows)]
    except StopIteration:
        return []

    result_list = []
    for row in rows:
        row_dict = {}
        for header, cell_val in zip(headers, row):
            clean_val = format_cell_value(cell_val)

            if drop_none_keys and clean_val is None:
                # 策略 A:直接剔除空值键,减少字典传输体积
                continue
            # 策略 B:保留键并将值赋为 None
            row_dict[header] = clean_val

        result_list.append(row_dict)

    wb.close()
    return result_list
通过这种方式,可以在读取单元格时直接拦截异常类型,甚至可以根据业务需要在空值时省略该字段(drop_none_keys=True),这在构建 RESTful API 请求体时非常有效。
四、进阶场景与边界情况处理
- Excel 中的文本型日期:部分 Excel 数据由于人工录入,日期列中夹杂了
"2026/10/20"、"2026.10.20"等纯文本字符串,导致库函数无法自动将其识别为日期对象。对于此类非标准数据,可以在转换逻辑中增加dateutil.parser.parse或正则匹配兜底,保证输出格式统一为YYYY-MM-DD。 - 只包含时间的字段:在 Excel 中单独输入时间(如
14:30:00)时,openpyxl 会将其解析为datetime.time对象。需要与datetime.date分流处理,使用val.strftime('%H:%M:%S')格式化。 - 公式计算错误单元格:包含
#N/A、#DIV/0!的单元格在data_only=True模式下会被读取为错误字符串或空值,需建立安全校验逻辑,避免向接口传递无效的错误代码。
五、总结
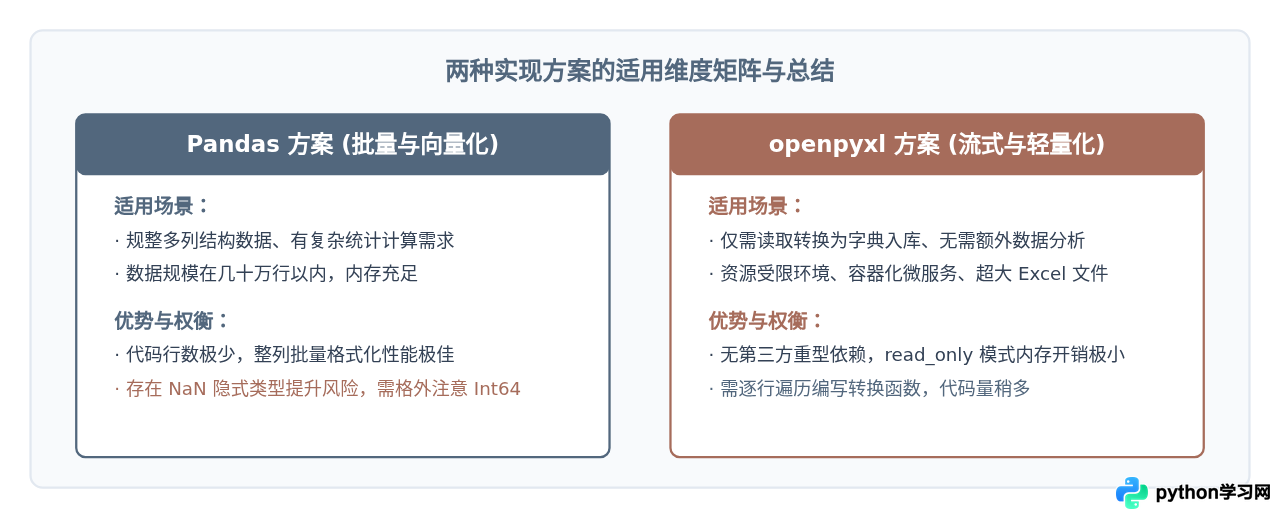
处理 Python 读取 Excel 转字典过程中的空值与日期,核心在于尽早收敛非标准数据类型。在使用 Pandas 时,必须防范 np.nan 和 pd.NaT 污染输出,合理利用 apply、strftime 与 where(pd.notnull) 确保生成标准原生对象;而在使用 openpyxl 时,建立清晰的流式格式化拦截器能够以更低的资源消耗获得高度可定制的字典输出。只要在转换时严格对齐下游系统的接收规范,就能彻底消除数据流转中的空指针与序列化异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















