


Python通过下标访问方式遍历元组的方法

在 Python 中遍历元组(tuple)通常推荐直接使用 for item in my_tuple 这种迭代方式,但在需要显式追踪当前项位置、根据索引进行跨步计算、成对比较或同步操作多个等长序列时,通过下标(索引)访问遍历则不可或缺。本文将系统讲解通过下标访问方式遍历元组的核心语法、运行机制、控制细节及边界防范。
一、元组下标寻址与索引体系
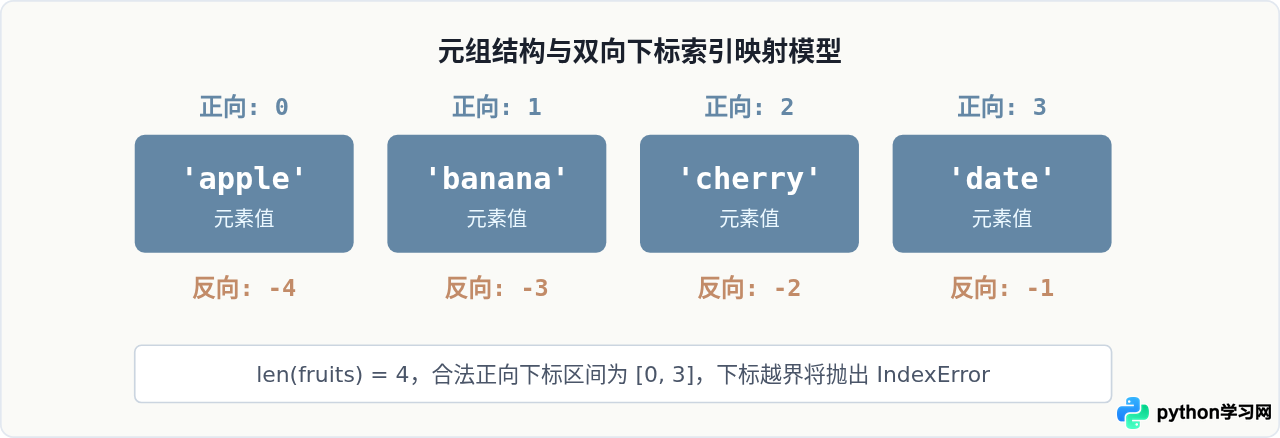
元组是 Python 中的有序不可变序列。正因为其具有明确的内部顺序,元组中的每个元素都会被分配一个从 0 开始递增的整数位置编号,称为正向索引(下标)。同时,Python 还提供了从 -1 开始从尾部向前计数的负向索引。
通过下标遍历元组的核心逻辑是:首先确定元组的长度 n,接着生成一个有效索引的整数序列(通常为 0 至 n-1),最后在循环体内利用 my_tuple[i] 的语法依次提取每个位置上的元素。
二、最常用的标准方法:for 循环结合 range(len(...))
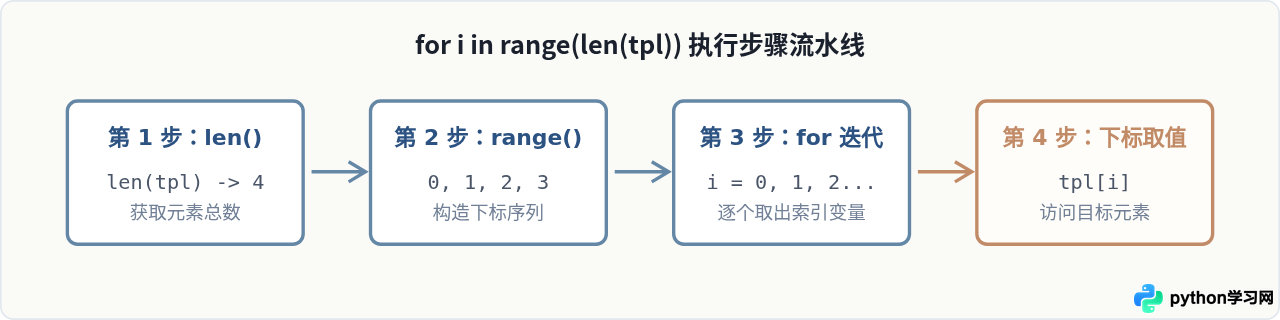
在 Python 中,通过下标遍历序列最标准且清晰的写法是将内置函数 len() 与 range() 配合使用。len(tpl) 返回元组的长度,而 range(len(tpl)) 则生成从 0 到 len(tpl) - 1 的整数序列,完美匹配元组的合法下标范围。
执行流程主要包含以下四个步骤:
- 获取长度:调用
len(tpl)计算元组包含的元素个数。 - 生成索引区:
range()构造出对应的闭开区间[0, len)。 - 循环迭代:
for循环按序将每个数字赋值给循环变量i。 - 索引取值:在循环体内部,通过
tpl[i]获取对应的元素值并执行处理。
下面是具体的代码示例与执行验证:
# 定义一个包含不同水果名称的元组
fruits = ("apple", "banana", "cherry", "date")

# 使用 range(len(fruits)) 生成索引进行正向遍历
for i in range(len(fruits)):
    print(f"索引: {i}, 对应元素: {fruits[i]}")
示例输出如下:
索引: 0, 对应元素: apple
索引: 1, 对应元素: banana
索引: 2, 对应元素: cherry
索引: 3, 对应元素: date
三、底层控制方法:使用 while 循环手动控制下标
除了利用 for 循环自动递增下标,还可以通过 while 循环手动管理下标计数器。在循环开始前将计数器初始化为 0,循环条件设置为 i < len(tpl),并在每次处理完元素后手动执行 i += 1。
这种写法的优势在于提供了对游标移动步长的精细控制权。例如,如果在遍历过程中需要根据元素内容跳过后续某些位置,或者需要按照步长 2(访问所有偶数下标项)进行跳转,手动递增计数器能更加灵活。
scores = (95, 88, 76, 92, 81)

# 初始化下标计数器
index = 0
length = len(scores)

# 通过 while 循环和条件判断控制下标
while index < length:
    val = scores[index]
    print(f"位置 [{index}] 的分数为: {val}")
    index += 1  # 关键步骤:下标自增,防止死循环
示例输出如下:
位置 [0] 的分数为: 95
位置 [1] 的分数为: 88
位置 [2] 的分数为: 76
位置 [3] 的分数为: 92
位置 [4] 的分数为: 81
while 循环进行下标遍历时,必须保证计数器在所有逻辑分支下都能正确递增,否则会导致循环条件始终满足,从而引发死循环。
四、特殊访问场景:倒序与跨步下标遍历
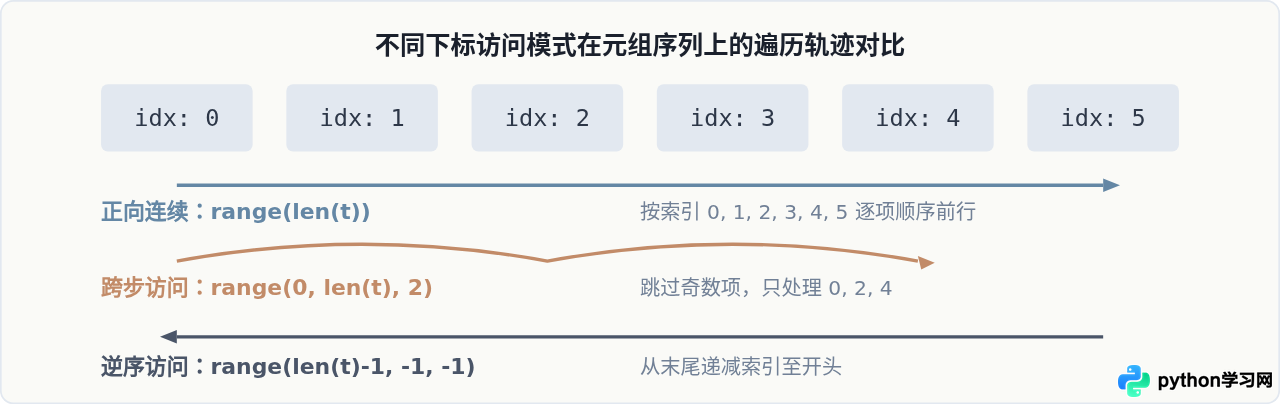
下标访问的另一大实用特性在于可以随心所欲定制访问轨迹,包括从后向前反向遍历和固定间隔跨步访问。
1. 逆序下标访问
如果希望从最后一个元素遍历到第一个元素,既可以使用负索引,也可以利用 range(start, stop, step) 构造递减的正向下标序列:
data = ("A", "B", "C", "D")

# 方法 A:利用递减的正向下标 (从 len-1 到 0,步长 -1)
for i in range(len(data) - 1, -1, -1):
    print(f"逆序正向索引: {i}, 值: {data[i]}")

# 方法 B:直接利用 Python 的负数下标 (-1 到 -len)
for i in range(1, len(data) + 1):
    print(f"负数索引: {-i}, 值: {data[-i]}")
2. 跨步跳跃访问
当只需要处理奇数位或偶数位的项时,调整 range() 的第三个参数 step 即可:
colors = ("red", "green", "blue", "yellow", "purple", "cyan")

# 仅遍历偶数索引:0, 2, 4
for i in range(0, len(colors), 2):
    print(f"偶数位索引 [{i}]: {colors[i]}")
五、核心注意事项与边界防范
通过下标访问遍历元组时,由于显式引入了数值运算,相较于纯迭代写法更容易在边界处发生错误。编写代码时需注意以下关键细节:
1. 严格防范 IndexError 越界异常
对于长度为 N 的元组,合法的非负下标最大只能是 N - 1。如果循环条件写成 i <= len(tpl) 或者 range(len(tpl) + 1),在最后一步访问 tpl[N] 时就会立即触发 IndexError: tuple index out of range。
2. 元组与列表的区别:不可变性限制
在列表(list)中,程序员常利用下标进行原地赋值修改,例如 my_list[i] = new_value。但元组是不可变对象(immutable),通过下标只能进行只读访问。尝试执行 my_tuple[i] = val 将直接抛出 TypeError: 'tuple' object does not support item assignment。如果遍历的目的是替换元素,必须创建新元组或转为列表。
3. 下标遍历与 enumerate() 的选型对比
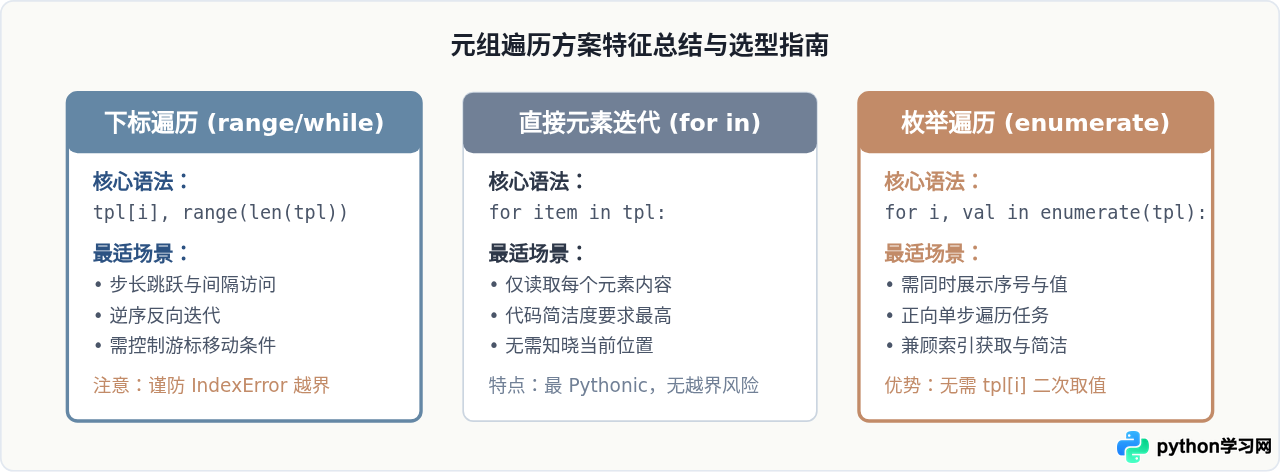
很多时候开发者使用下标遍历只是为了在打印或日志中显示当前的序号。如果不需要跳步、逆序或多列表下标联动,Python 推荐使用 enumerate() 内置函数,它既保留了简洁安全的迭代机制,又能同时返回当前索引和对应元素。
总结
通过下标访问遍历元组是掌握序列底层控制的关键操作。标准实践首选 for i in range(len(tpl)) 结构,逻辑直观且不易出错;在需要灵活调整步进节奏时可选用 while 循环;需要逆序或跳步时则借助带步长参数的 range(start, stop, step)。在编写代码时,牢记元组的只读特性与 0 至 len - 1 的边界约束,即可稳定、安全地完成各项下标遍历需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















