


显存不足怎么本地部署AI大模型?GGUF量化与CPU推理方案详解

很多人想体验本地大语言模型的隐私安全与离线便利,却被“显存不足”这四个字劝退。打开任务管理器,看着仅剩几GB的可用显存,再对比动辄需要16GB甚至24GB显存的7B参数模型,这种无力感非常真实。
但这并不意味着低配电脑就与本地AI绝缘。显存瓶颈的本质是数据精度与存储方式的冗余,而非算力的绝对缺失。通过改变模型的存储格式(量化)并转移计算重心(从GPU转向CPU),我们完全可以在普通笔记本甚至老旧台式机上流畅运行主流开源模型。
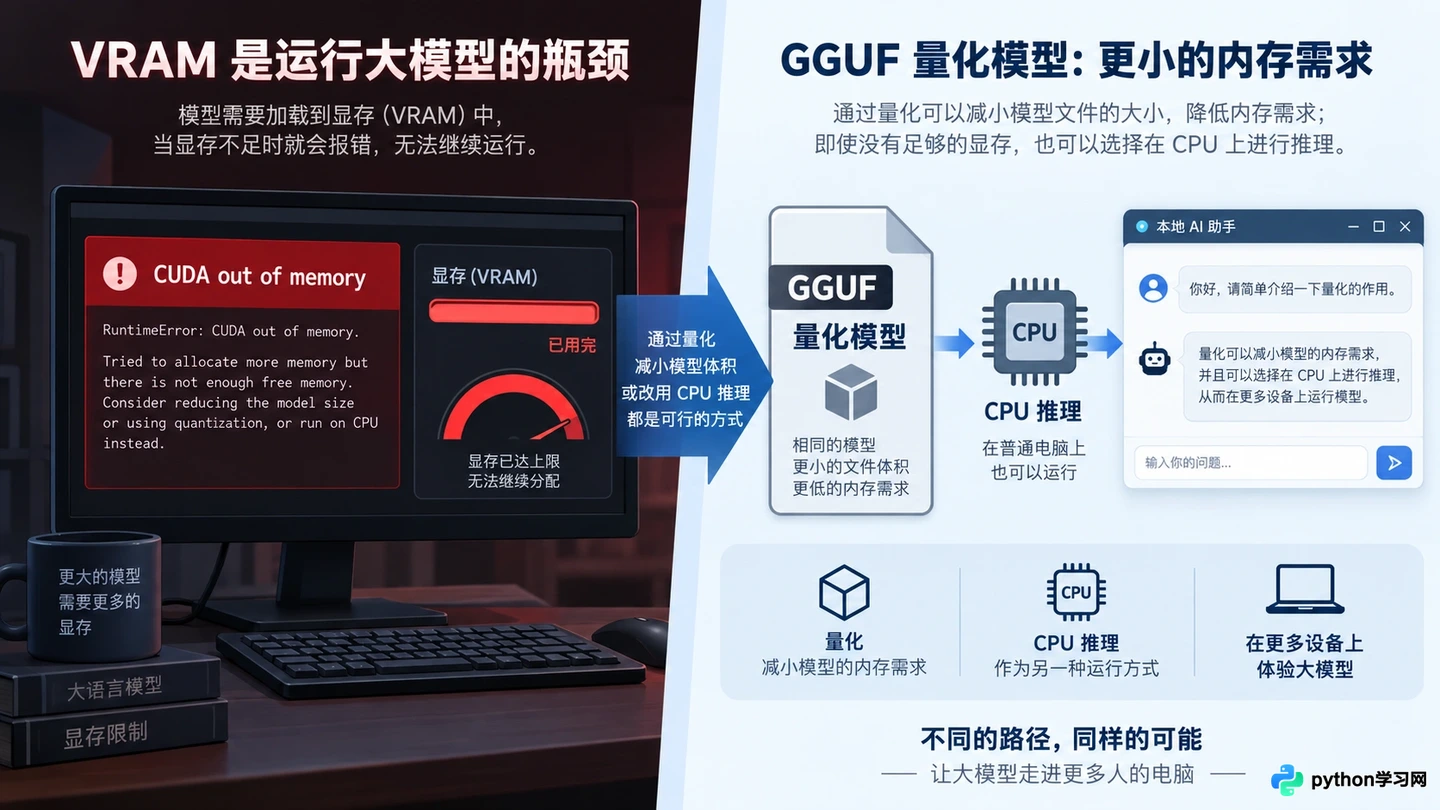
显存瓶颈与GGUF量化方案的直观对比
核心逻辑:用精度换空间,用内存代显存
传统深度学习框架通常以FP16(半精度浮点数)加载模型,这意味着每个参数占用2字节。一个70亿参数(7B)的模型仅权重就需要约14GB显存,再加上推理过程中的KV缓存,16GB显存确实捉襟见肘。
GGUF(GGML Universal File)格式的出现改变了这一局面。它允许我们将模型参数从FP16压缩为INT4(4位整数)甚至更低。在这种量化级别下,7B模型的体积可缩减至4-5GB左右。更关键的是,GGUF格式专为CPU推理优化,配合llama.cpp等推理引擎,可以直接利用系统内存(RAM)而非显存(VRAM)来加载模型。
这一转换的核心代价是推理速度的下降和极微小的精度损失,但对于日常对话、文本总结等非实时性严苛的场景,这种交换是完全值得的。
场景一:获取与选择适合的GGUF模型
并不是所有模型都适合低配环境。在Hugging Face或ModelScope等平台搜索模型时,直接添加关键词“GGUF”或“Q4_K_M”能大幅缩小范围。
对于8GB内存的用户,建议从3B-7B参数量的模型入手,如Qwen2.5-3B或Llama-3.2-3B。这些模型在量化后仅需2-3GB内存,留出的空间足以容纳操作系统和其他后台进程。若拥有16GB内存,则可以尝试7B-9B参数的模型,选择Q4_K_M(4位量化)或Q5_K_M(5位量化)版本。
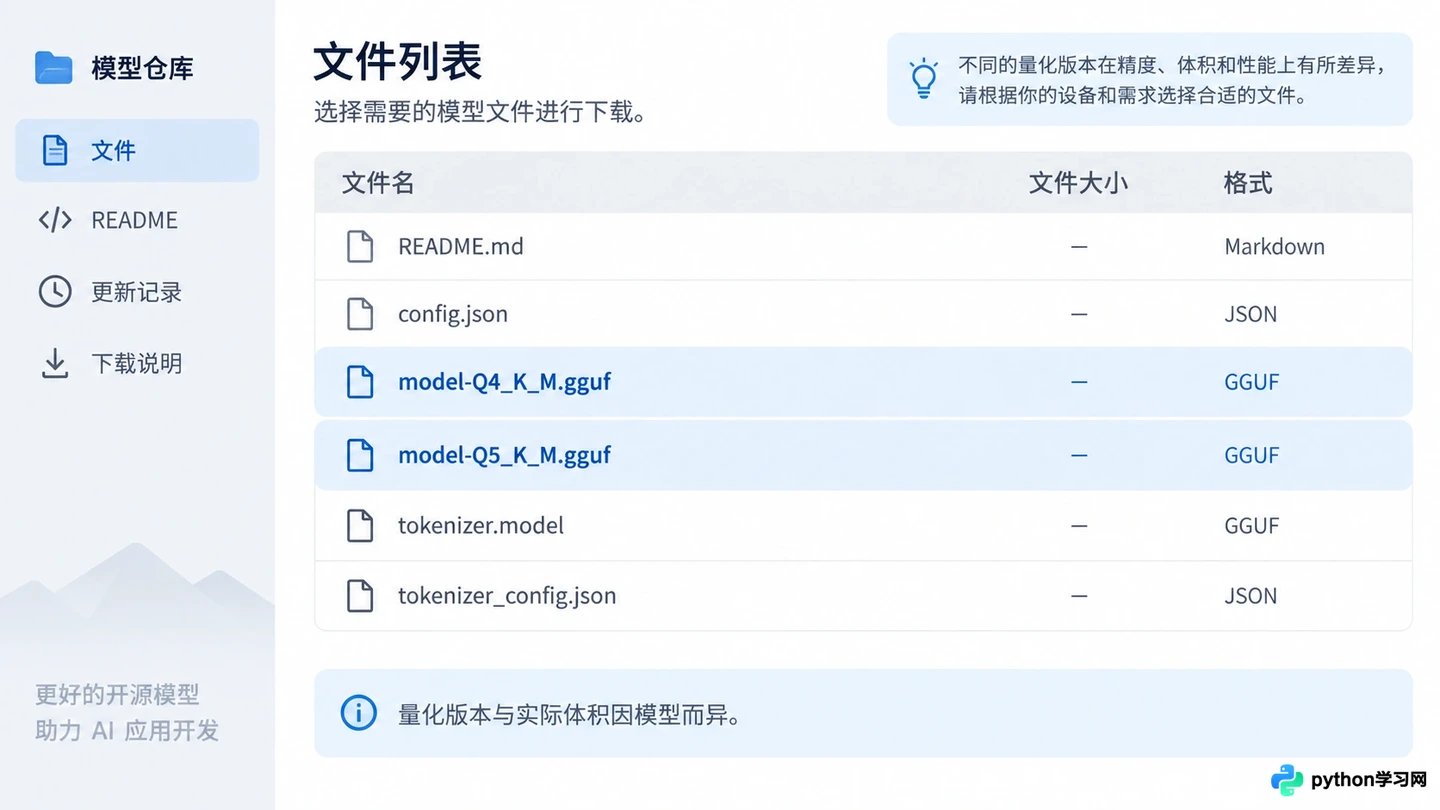
在模型库中筛选合适的GGUF量化版本
下载时需注意文件命名规则:Q4_K_M代表中等质量的4位量化,通常在速度与智能程度间取得最佳平衡;Q8_0接近原始精度但体积较大;IQ2_XS则是极端压缩,适合极低内存环境但可能影响逻辑能力。不要盲目追求高量化位数,对于CPU推理而言,Q4往往是性价比最高的甜点区。
场景二:使用llama.cpp进行纯CPU推理
llama.cpp是目前最成熟的C++推理后端,它对Apple Silicon和x86 CPU都有极好的优化。无需复杂的Python环境配置,直接使用预编译的二进制文件即可启动。
Windows用户可下载带有cuda或cpu标识的release版本,Linux/macOS用户则可通过源码编译获得最佳性能。启动命令非常简单:
./main -m path/to/your-model.gguf -p "你好,请介绍一下你自己" -n 512 --temp 0.7
其中-m指定模型路径,-p为提示词,-n限制最大生成token数。如果希望获得交互式聊天体验,可以使用chatml或llama3等内置模板,或者搭配图形化前端如Ollama、LM Studio。
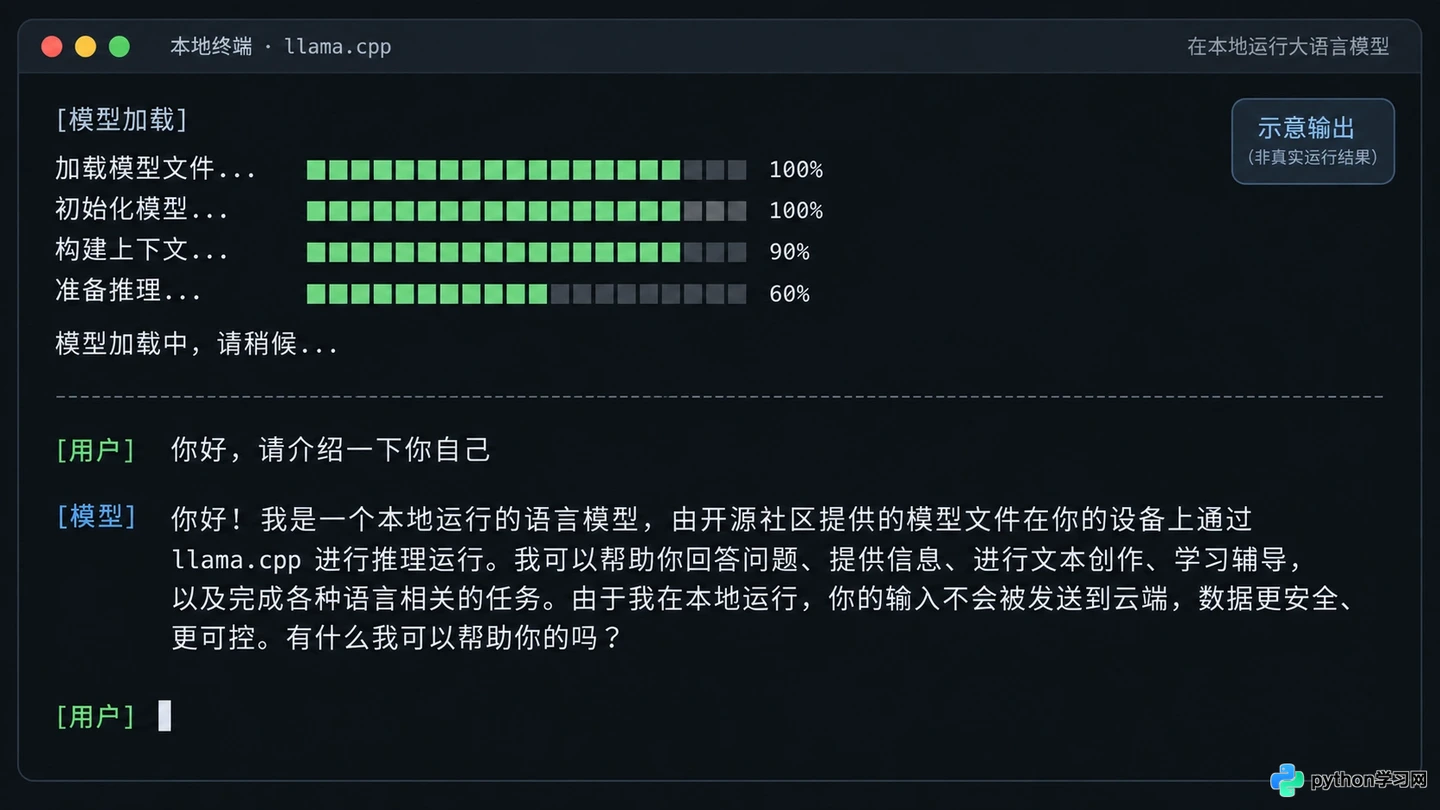
llama.cpp终端运行界面示例
在纯CPU模式下,内存带宽成为新的瓶颈。DDR4与DDR5内存的性能差异在此时会明显体现。双通道内存配置比单通道能提供更稳定的token生成速度。虽然无法达到GPU每秒几十上百个token的速度,但在现代CPU上,Q4量化的7B模型通常能维持每秒5-15个token的输出,足以满足阅读跟随的需求。
场景三:混合推理与层数卸载策略
如果你的电脑拥有一张显存较小(如4GB或6GB)的独立显卡,完全放弃GPU是一种浪费。llama.cpp支持“部分层卸载”(Layer Offloading)。
通过-ngl参数,你可以指定将多少层模型运算卸载到GPU上。例如:
./main -m model.gguf -ngl 20 -t 8
这表示将前20层计算放在GPU,其余留在CPU,并使用8个CPU线程辅助。由于矩阵乘法在GPU上效率极高,即使只卸载部分层,也能显著提升整体推理速度。关键在于找到显存能容纳的最大层数,这需要少量试错:从-ngl 10开始逐步增加,直到出现显存溢出错误,然后回退一档。
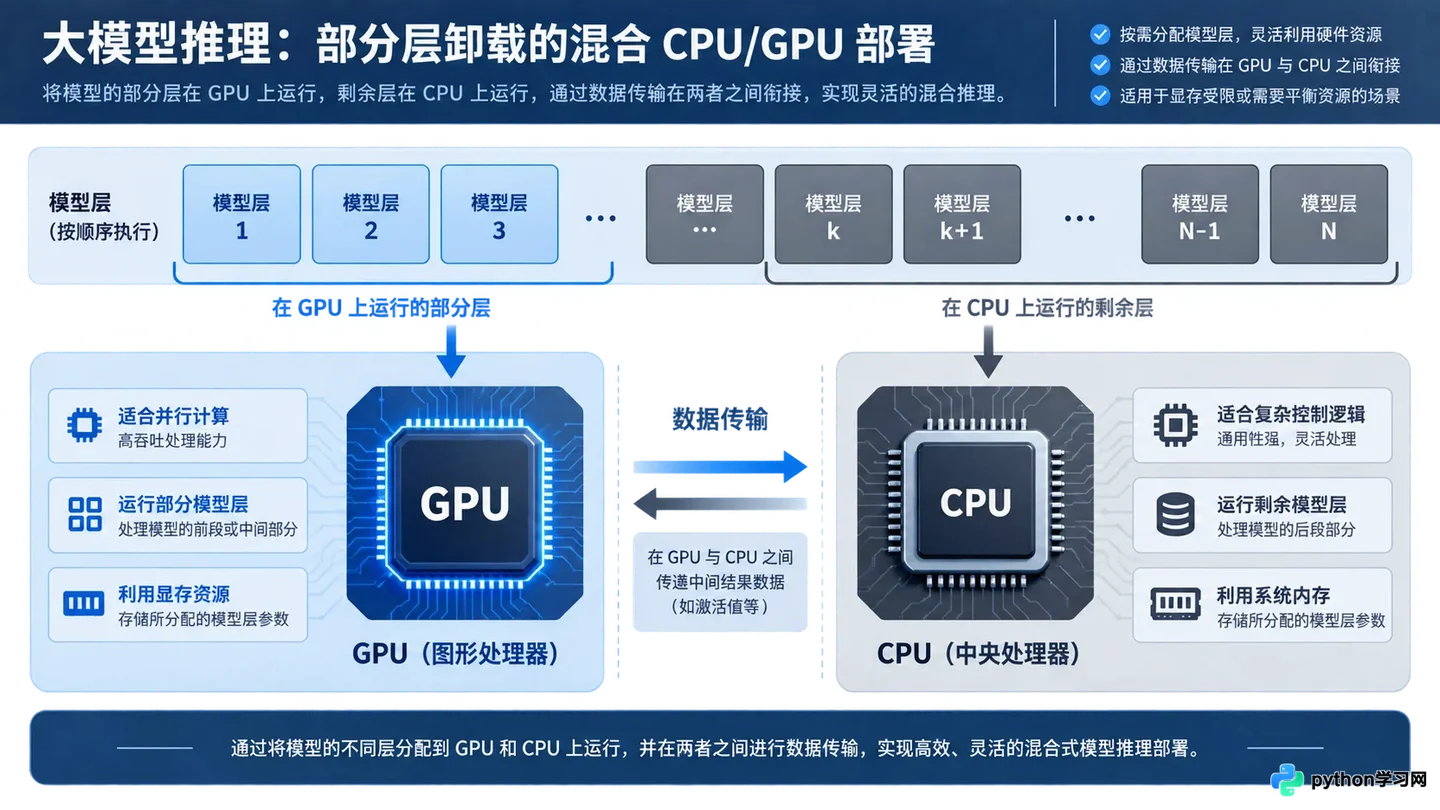
部分层卸载到GPU的混合推理原理
这种混合模式既利用了GPU的高速计算,又通过CPU和系统内存承担了剩余负载,是低显存用户提升体验的最有效手段。需要注意的是,数据传输在PCIe总线上的开销依然存在,因此并非卸载层数越多线性提升越明显,但相比纯CPU仍有质的飞跃。
边界与预期管理:这不是万能药
必须清醒认识到,CPU推理存在物理上限。当模型参数量超过13B,或者上下文窗口设置得极大(如32k以上)时,即使是DDR5内存也会面临带宽墙,导致生成速度降至每秒1-2个token,变得难以忍受。
此外,量化必然带来信息损失。在处理复杂逻辑推理、代码生成或细微语义辨析时,Q4模型的表现可能略逊于FP16原版。但对于日常问答、创意写作和信息提取,这种差异往往难以察觉。
低配设备也能享受本地AI的便利
本地部署的真正意义在于可控与隐私,而非极致性能。如果你接受稍慢的响应速度,换取数据不出本地、无订阅费用且随时可用的AI助手,那么GGUF量化加CPU推理就是当前最具性价比的技术路径。它让AI从云端的神坛走下,真正进入了每一台普通电脑的硬盘里。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















