


Python split方法实战:按分隔符快速截取字符串字段

在Python文本处理与数据清洗中,str.split() 是提取特定字段最高频使用的基础工具。掌握其分隔符匹配规则、空白折叠特性与截取计数参数,能够帮助我们在无需引入复杂正则的前提下,快速、稳定地完成结构化文本字段的精确截取。
一、split方法的核心语法与默认行为
Python字符串内置的 split() 方法用于沿着指定的分隔符将字符串切分为列表。其标准函数签名如下:
str.split(sep=None, maxsplit=-1)该方法接受两个可选参数:sep 代表作为分隔界限的字符或子串;maxsplit 代表执行分割的最大次数,默认值 -1 表示不限制切分次数,即完整切分全文。
1. sep 为 None 时的默认空白折叠机制
当不传入任何参数或显式指定 sep=None 时,split() 会采用算法级的分组机制:将任意连续出现的空白字符(包括空格、制表符 \t、换行符 \n、回车符 \r 等)视为单个聚合分隔符,并且会自动忽略字符串首尾多余的所有空白。
raw_text = "   Python    split   method   practice  \n"
result = raw_text.split()
# 示例输出:['Python', 'split', 'method', 'practice']
2. 指定明确分隔符时的精确匹配
一旦给 sep 传入了具体字符(例如单个空格 " " 或逗号 ","),方法的解析逻辑将完全切换为“严格精确匹配”。在精确匹配模式下,每一个相邻的分隔符之间都会计算一个元素;如果分隔符位于最开头、最末尾,或者两个分隔符紧密相连,中间就会产生空字符串 ""。
csv_row = "item_1,,15.00,in_stock,"
parts = csv_row.split(",")
# 示例输出:['item_1', '', '15.00', 'in_stock', '']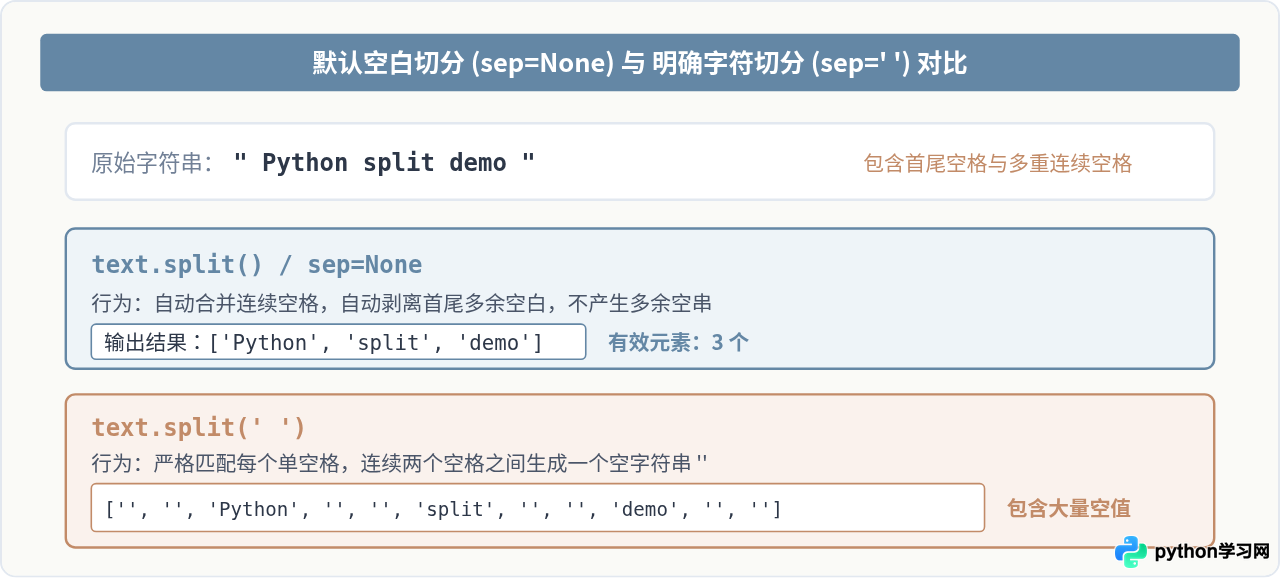
二、按指定分隔符截取字段的常用技巧
在面对如 CSV 行、日志输出、系统环境变量或键值对字符串时,我们通常需要截取其中某个特定位置的字段。
1. 索引提取法(单字段截取)
切分返回的结果是一个标准 Python 列表,因此可以直接结合下标索引获取目标值。结合正向索引与负向索引,可以迅速定位首尾字段:
record = "USR_2048|active|2026-10-20|beijing_node"
fields = record.split("|")

# 提取首个字段:用户ID
user_id = fields[0]       # "USR_2048"

# 提取倒数第一个字段:节点名
node = fields[-1]          # "beijing_node"

# 提取倒数第二个字段:日期
date_str = fields[-2]      # "2026-10-20"
2. 多变量解包解构(多字段一次性截取)
当输入格式完全固定且字段数目确定时,可以直接使用元组解包语法将切分后的列表一次性分配给各个独立变量,使代码更加直观:
coordinate = "116.4074,39.9042,43.5"
lon, lat, alt = coordinate.split(",")

print(f"经度: {lon}, 纬度: {lat}, 海拔: {alt}")
# 示例输出:经度: 116.4074, 纬度: 39.9042, 海拔: 43.5
三、控制切分次数:maxsplit 与 rsplit 进阶实战
在实际场景中,数据字段内部往往本身就含有分隔符。如果一味全局切分,会导致后面的内容被误拆。此时 maxsplit 参数能够发挥关键的控制作用。
1. 限制切分次数保留尾部整块文本
例如在解析 HTTP 头信息或键值日志时,键和值之间使用冒号分隔,但值字段内部可能含有多重冒号(如时间戳、URL 或 JSON 串)。通过设置 maxsplit=1,可以确保只切分第一个冒号,保留完整的后续内容:
log_line = "2026-10-20 14:30:00:INFO:disk_check:status=ok:latency=12ms"

# 仅切分前两处冒号,将时间、级别与详细负载分离开
date_part, level, payload = log_line.split(":", maxsplit=2)

# date_part -> "2026-10-20 14" (注意:若只切前缀,需注意格式边界)
# 更合理的场景:提取配置项
config = "database_url:mysql://user:pass@localhost:3306/prod_db"
key, url = config.split(":", maxsplit=1)
# key -> "database_url"
# url -> "mysql://user:pass@localhost:3306/prod_db"
2. 从右侧切分:rsplit 的对应应用
与从左向右切分的 split() 相对,str.rsplit() 提供了从右侧向左侧开始切分的能力。在不带 maxsplit 参数时,两者切分出的列表内容完全一致;但在限制切分次数时,rsplit 能够轻松解决“提取文件扩展名”或“截取路径最后一级”等任务:
file_path = "archive.data.backup.tar.gz"

# 从右侧切分一次,提取主文件名与最终后缀
base_name, ext = file_path.rsplit(".", maxsplit=1)
# base_name -> "archive.data.backup.tar"
# ext       -> "gz"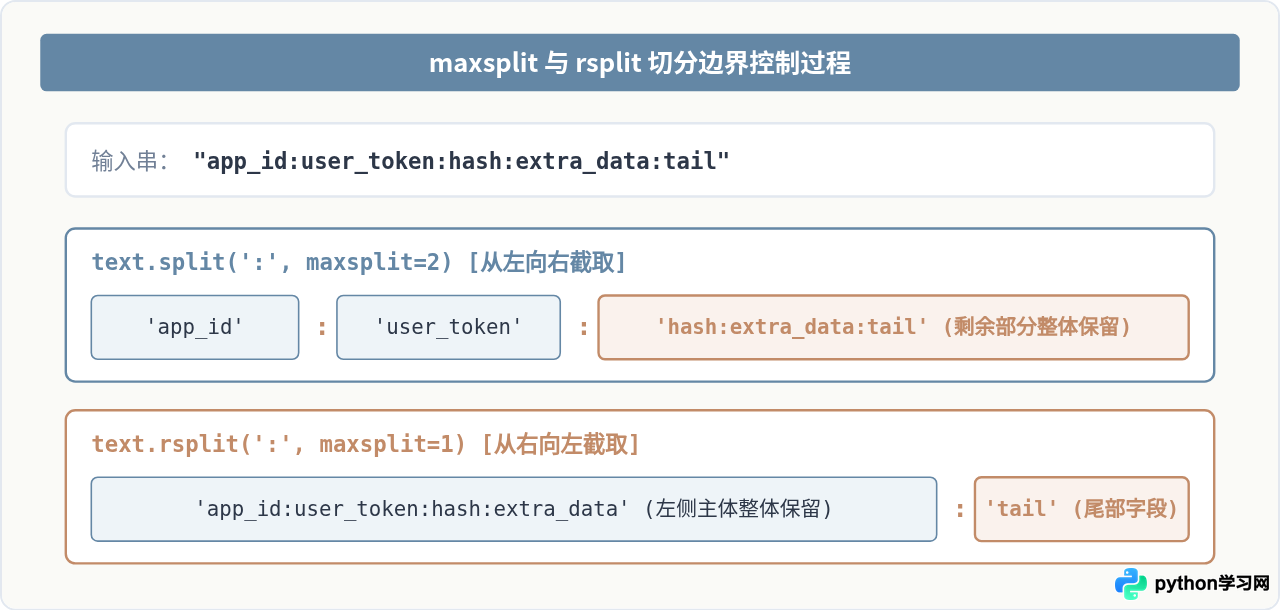
四、工程实战:结构化字段安全截取四步法
在生产环境下,输入的字符串往往存在不规范格式、空值或缺失字段。如果直接盲目切分并解包,极易触发 ValueError: not enough values to unpack 或 IndexError: list index out of range。建议遵循标准四步截取流程:
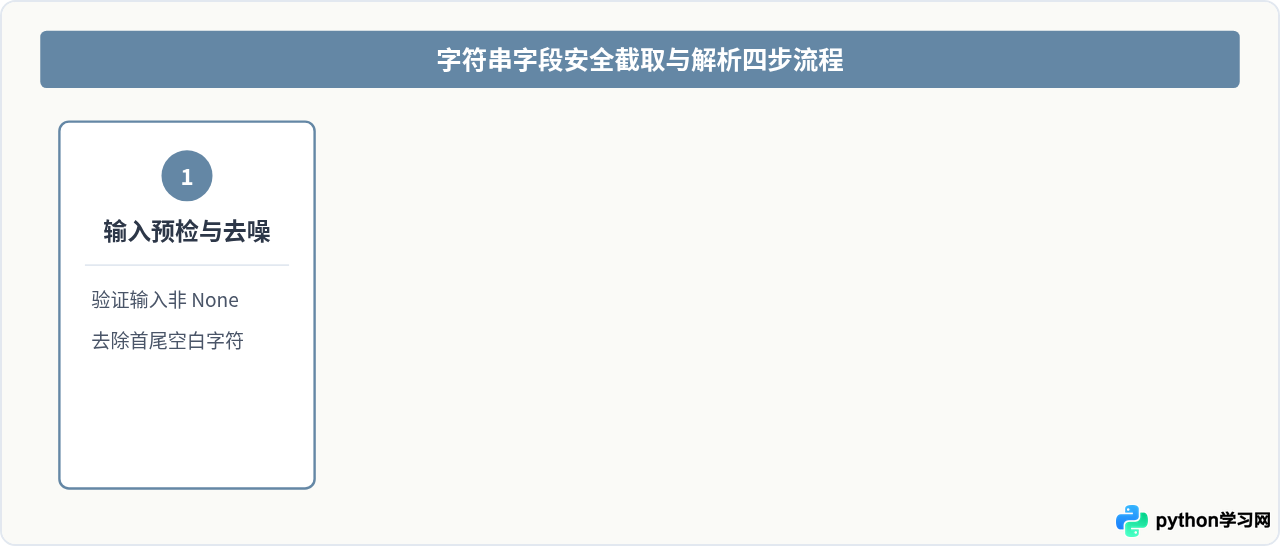
安全截取示例代码
def parse_user_record(raw_line: str) -> dict:
    # 步骤 1:去噪预检
    cleaned = raw_line.strip()
    if not cleaned:
        return {}

    # 步骤 2:指定分隔符切分(限制最多切3次,提取4个字段)
    parts = cleaned.split(",", maxsplit=3)

    # 步骤 3:长度校验,防御截取越界
    if len(parts) < 3:
        raise ValueError(f"记录格式非法,有效字段不足: {raw_line}")

    user_id = parts[0]
    username = parts[1]

    # 步骤 4:类型转换与缺失默认值填充
    try:
        score = float(parts[2])
    except ValueError:
        score = 0.0

    extra_info = parts[3] if len(parts) > 3 else "N/A"

    return {
        "user_id": user_id,
        "username": username,
        "score": score,
        "extra_info": extra_info
    }

# 测试用例
sample = "1001,alex,95.5,verified_account"
print(parse_user_record(sample))
# 示例输出:{'user_id': '1001', 'username': 'alex', 'score': 95.5, 'extra_info': 'verified_account'}避坑提示:当原字符串中完全不包含指定分隔符时,split() 不会抛出异常,而是会返回一个仅包含原字符串本身的单元素列表 [original_str]。因此切勿直接根据分隔符是否存在来假设返回列表的长度。
五、常见问题排查与关键决策总结
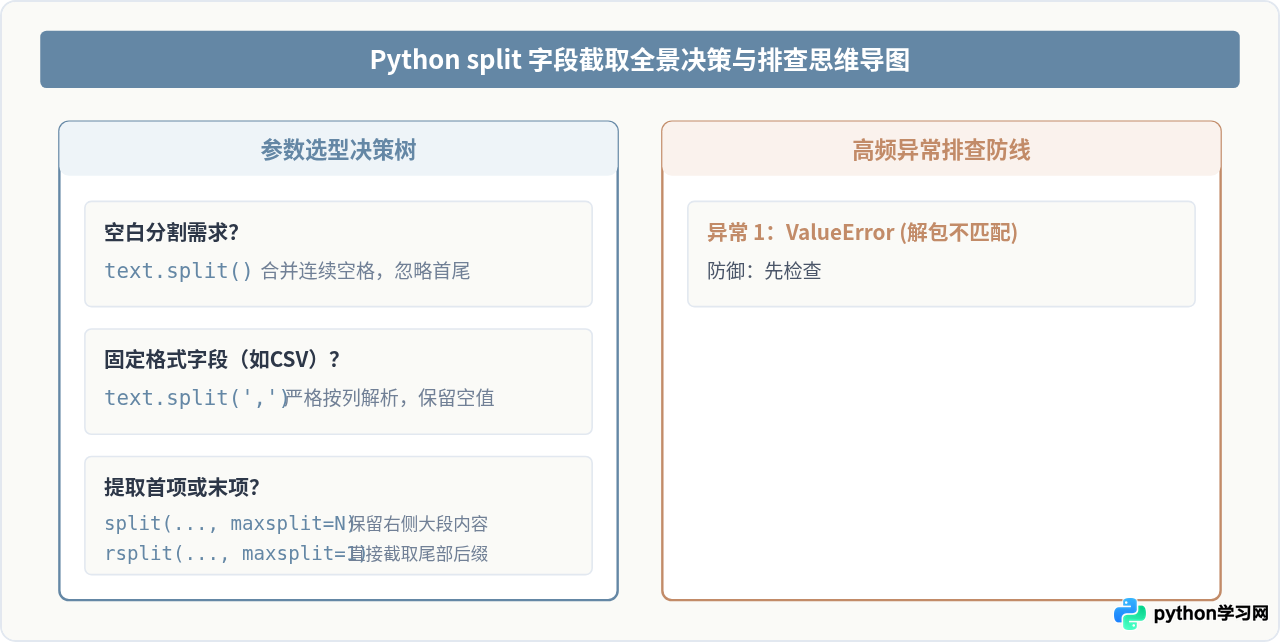
为了在不同业务场景中选择最优的截取策略,可以参考以下总结与技术选型图谱:
| 业务场景 | 推荐调用方式 | 主要优势与考量 |
|---|---|---|
| 命令行参数/自由排版文本 | text.split() |
自动压缩多个空格或制表符,自动清理边缘空白 |
| 标准 CSV / TSV 格式数据 | text.split(",") 或 split("\t") |
严格按列定位,空单元格会被正确保留为空串 "" |
| 键值对或固定头部报文 | text.split(":", maxsplit=1) |
保护值中的复杂符号不被额外切碎 |
| 文件后缀名/右侧特定字段 | text.rsplit(".", maxsplit=1) |
直接从右向左截取,避免计算左侧复杂层级 |
| 复合/动态多字符分隔符 | re.split(r"[,;|\s]+", text) |
当单字符规则无法满足时,升级至正则切分 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















