


为什么不能在Python for循环中直接删除列表元素

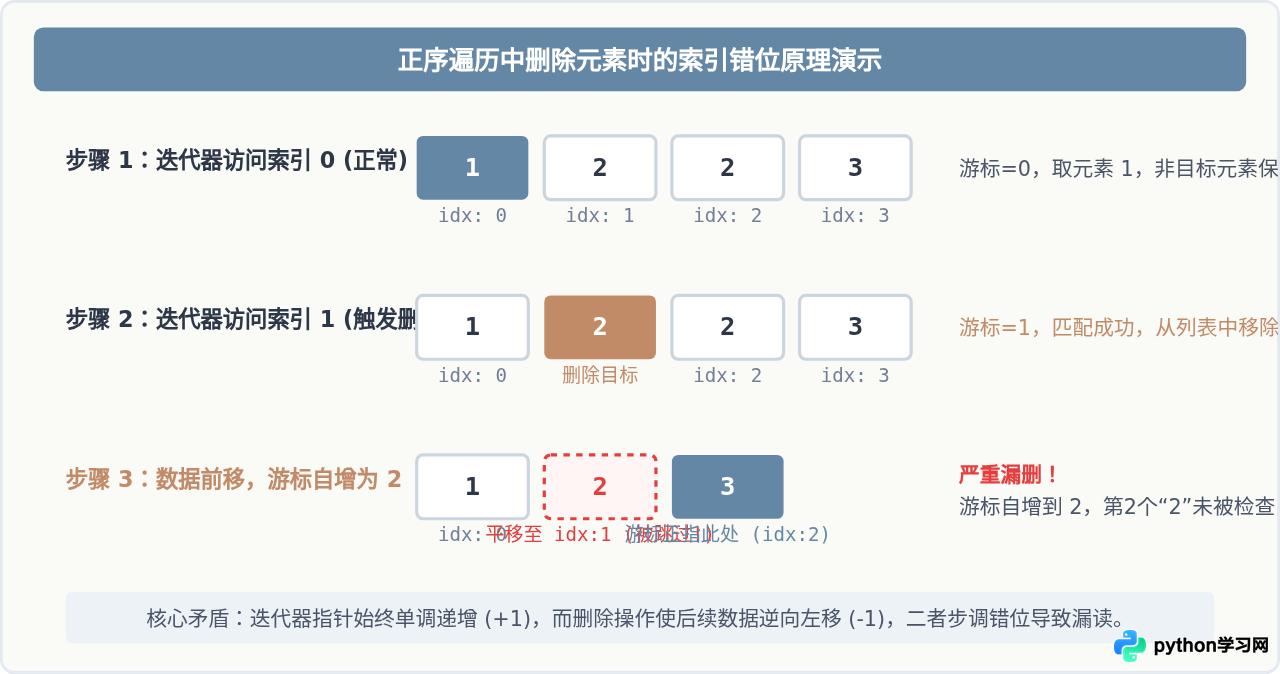
在 Python 中,通过 for 循环遍历列表时直接删除元素,会导致遍历过程出现漏判、跳过元素甚至索引错乱等隐蔽 Bug。其核心原因在于:Python 的 for 循环在底层依靠迭代器内部记录的递增整数索引依次提取元素,而列表作为连续内存的动态数组,在删除某个元素后会将其后所有元素立即向前平移;递增的索引遇到前移的数据,便会径直跳过紧随其后的相邻元素。
一、典型现象与常见代码陷阱
许多初学者在编写列表过滤逻辑时,往往习惯直接在 for 循环中查找并删除目标元素。下面这段看似逻辑严谨的代码,就是最经典的触发场景:
# 示例代码:试图删除列表中所有的 2
nums = [1, 2, 2, 3, 4]

for item in nums:
    if item == 2:
        nums.remove(item)

print(nums)
# 预期结果:[1, 3, 4]
# 实际输出结果:[1, 2, 3, 4]
执行后可以清楚地看到,列表中仍然残留了一个数字 2。不仅是 remove() 方法,如果在按索引迭代时使用 del nums[i] 或 nums.pop(i),同样会出现相同或者更加严重的漏删问题,甚至可能直接抛出 IndexError: list index out of range 异常。
二、底层机制深入剖析
要彻底理解为什么会发生上述错位,需要从 Python 虚拟机的底层数据结构与迭代器协议说起:
1. 列表在内存中是连续分配的指针数组
在 CPython 源码实现中,PyListObject 并不是双向链表,而是维护了一段连续的指针数组。这就决定了在列表中间删除任意一个元素时,虚拟机必须通过内存移动(类似于 C 语言中的 memmove),将该位置之后的所有元素指针整体向前平移一位以填补空隙,整个列表的长度 len 也相应减 1。
2. for 循环本质是内部迭代器的索引递增器
当执行 for item in nums: 时,Python 解释器首先调用 iter(nums) 生成一个列表迭代器对象(listiterator)。该对象在底层主要记录了两个变量:指向列表实体的指针,以及一个表示当前遍历位置的整数计数器 it_index。
每次循环迭代触发 __next__() 时,底层逻辑仅执行两步:
- 检查
it_index是否小于当前列表的len(nums);若超出则终止循环(抛出StopIteration)。 - 提取
nums[it_index]赋值给循环变量,随后无条件将it_index递增 1(即it_index += 1)。
三、安全解决列表元素删除的四种标准方案
在实际工程中,根据是否需要就地修改原列表、数据规模大小以及内存占用要求,有四种标准而安全的实现路径。
方案一:列表推导式(强烈推荐,Pythonic 首选)
在绝大多数开发场景下,过滤数据最清晰、最快速的做法不是“从旧列表中逐个删除”,而是“挑选出需要保留的元素构成新列表”。
# 方案一:使用列表推导式
nums = [1, 2, 2, 3, 4]

# 构建只包含目标保留项的新列表
nums = [x for x in nums if x != 2]

print(nums) # 输出:[1, 3, 4]优势与原理:列表推导式由底层 C 代码优化执行,无需在原数组中发生多次昂贵的数据大块搬移,时间复杂度为线性的 $O(n)$。代码简洁且可读性极高。
方案二:逆序遍历(需要原地修改且内存受限时推荐)
如果列表数据量巨大,无法分配额外的新列表内存,或者有明确要求必须在原列表对象上进行 del,则应当采用从后往前的逆序遍历方式。
# 方案二:逆序遍历删除
nums = [1, 2, 2, 3, 4]

# 从最后一个索引递减到 0
for i in range(len(nums) - 1, -1, -1):
    if nums[i] == 2:
        del nums[i]

print(nums)  # 输出:[1, 3, 4]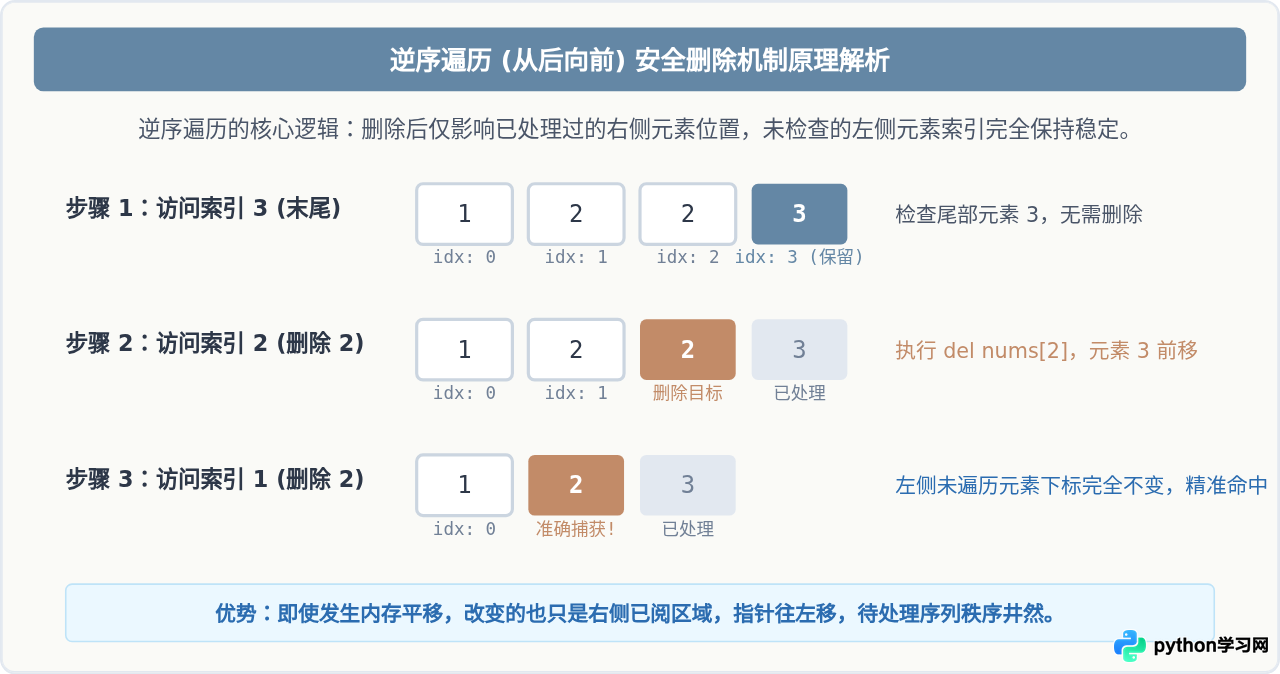
方案三:遍历浅拷贝副本(适合简单小列表)
如果既想保留正向 for item in list 的直观写法,又需要修改原列表,可以遍历列表的切片副本 nums[:] 或 list(nums):
# 方案三:遍历切片副本
nums = [1, 2, 2, 3, 4]

# 迭代器绑定的是切片产生的独立副本
for item in nums[:]:
    if item == 2:
        nums.remove(item)

print(nums)  # 输出:[1, 3, 4]
注意点:这种方式虽然避免了索引错位漏读,但 nums.remove() 本身每次都需要重新从头遍历寻找目标值,在大列表下会导致 $O(n^2)$ 的时间开销,不建议在对性能有要求的场景中使用。
方案四:切片赋值(兼顾就地修改与高性能)
如果函数外部有其他变量引用了同一个列表,重新赋值 nums = [...] 会让变量指向新的对象而丢失引用绑定。此时可以使用切片赋值 nums[:] = ...:
# 方案四:切片赋值(原地替换全部内容)
def filter_in_place(data):
    # 使用切片赋值,保证外部传入的引用指向的原对象内容被原地更新
    data[:] = [x for x in data if x != 2]

my_list = [1, 2, 2, 3, 4]
filter_in_place(my_list)
print(my_list)  # 输出:[1, 3, 4],原列表对象内容被原地更新
四、四种方案的横向对比与技术选型
为了便于读者根据实际业务场景进行技术决策,下面对常见过滤/删除方案的关键指标进行系统对比:
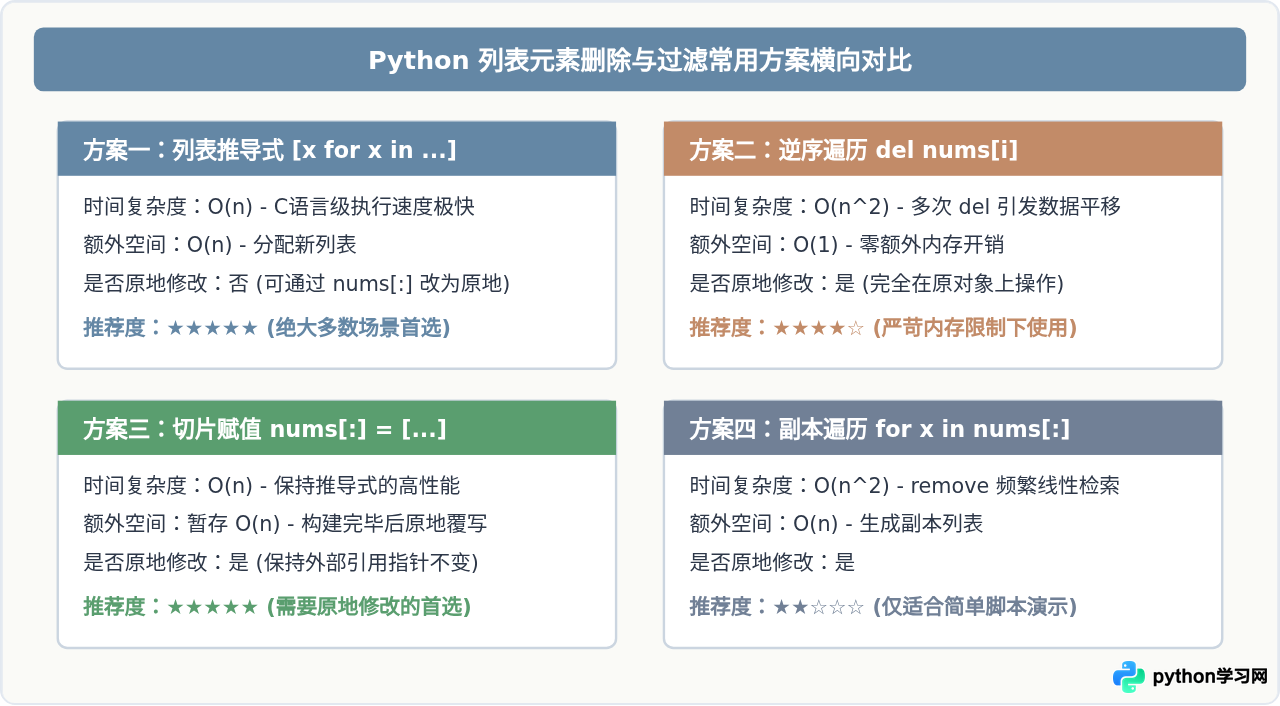
| 处理方式 | 代码写法示例 | 时间复杂度 | 空间复杂度 | 是否保持原对象地址 |
|---|---|---|---|---|
| 列表推导式 | nums = [x for x in nums if condition] |
$O(n)$ | $O(n)$ | 否(生成新列表) |
| 切片赋值 | nums[:] = [x for x in nums if condition] |
$O(n)$ | $O(n)$ 暂存 | 是(原地修改) |
| 逆序索引遍历 | for i in range(len(nums)-1, -1, -1): del nums[i] |
$O(n^2)$ | $O(1)$ | 是(原地修改) |
| 副本遍历 | for x in nums[:]: nums.remove(x) |
$O(n^2)$ | $O(n)$ | 是(原地修改) |
五、开发决策路径与总结
面对业务中“过滤或剔除列表元素”的需求,开发者可以按照下图所示的决策路径选择最优解法:
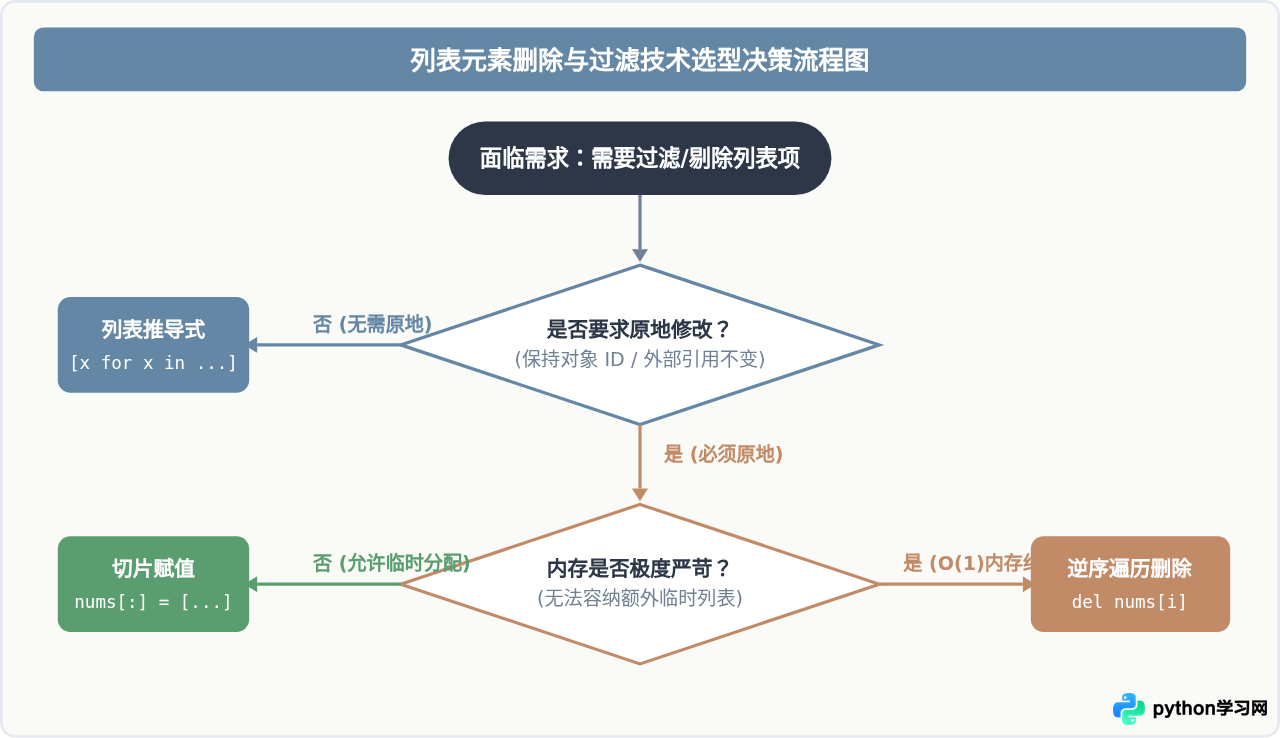
综上所述,“不能在 for 循环中直接删除列表元素”并非 Python 的设计缺陷,而是动态数组结构与简单递增迭代器在设计约束下的必然结果。只要牢记“迭代器向前走,删除向左移”这一根本矛盾,并在实践中优先使用列表推导式或切片赋值,就能写出既清晰稳健又高性能的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















