


怎么高效自学Python?避开只看不练的常见误区

自学 Python 时,许多人最常经历的瓶颈并非语法过于深奥,而是陷入一种“听讲解恍然大悟,关掉屏幕大脑一片空白”的假性掌握状态。要改变这种低效循环,关键在于打破传统的线性视听学习模式,转而建立“以微小任务为驱动、交互验证为核心”的即时闭环:每接触一个语法特性,必须在5分钟内通过终端或编辑器手动输入并验证结果;每学完一个功能模块,立即脱离教程独立编写一段20行以内的可用脚本。本文将梳理只看不练的心理成因,并提供一套可直接落地的自学操作路径。
一、认清“只看不练”的本质:为何教程看懂了,写代码却一片空白
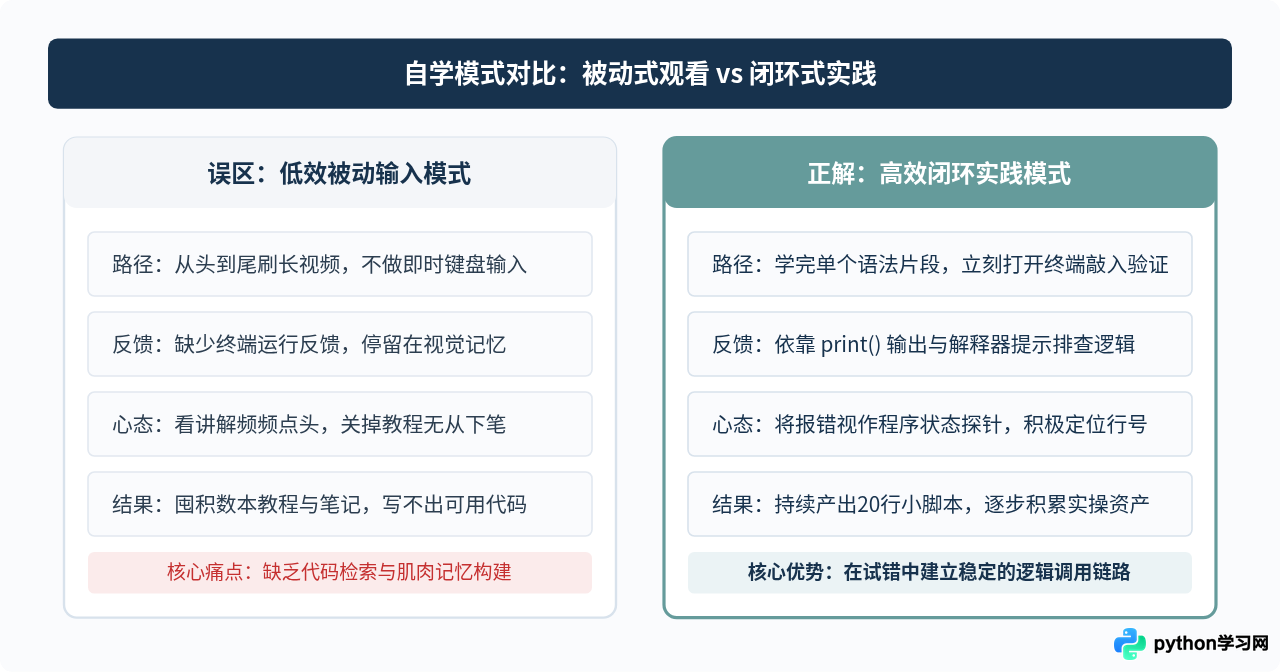
许多初学者往往把自学 Python 当作一门需要“先系统背诵、再上机考试”的学科。他们花费数周时间刷完长达数十小时的视频课程,或者在笔记本上工工整整抄写各类函数用法,但真正面对空白的代码编辑器时,连一个基础的文件读取逻辑都无法组织。这种停滞通常由以下三种认知偏差造成:
- 被动接收造成的认知幻觉:观看教学视频时,思路顺着讲师预设的逻辑推进,读者的大脑只参与了语义识别,并未调动检索与逻辑构建能力。这种顺畅感容易被误解为自己已经掌握。
- 前置知识囤积症:总认为自己“还没准备好”,试图把类、装饰器、多线程、异步等高级特性全部学完才动手写程序。然而编程是一门工程实践技能,没有底层实践支撑的高级概念只会加速遗忘。
- 对报错信息的过度畏惧:初学者常常将程序抛出的
Traceback红色报错视为挫败,因害怕出错而不敢自主敲击键盘,宁可反复核对标准答案也不愿自行调试。
二、重塑自学流程:四步建立“即学即练”的操作闭环
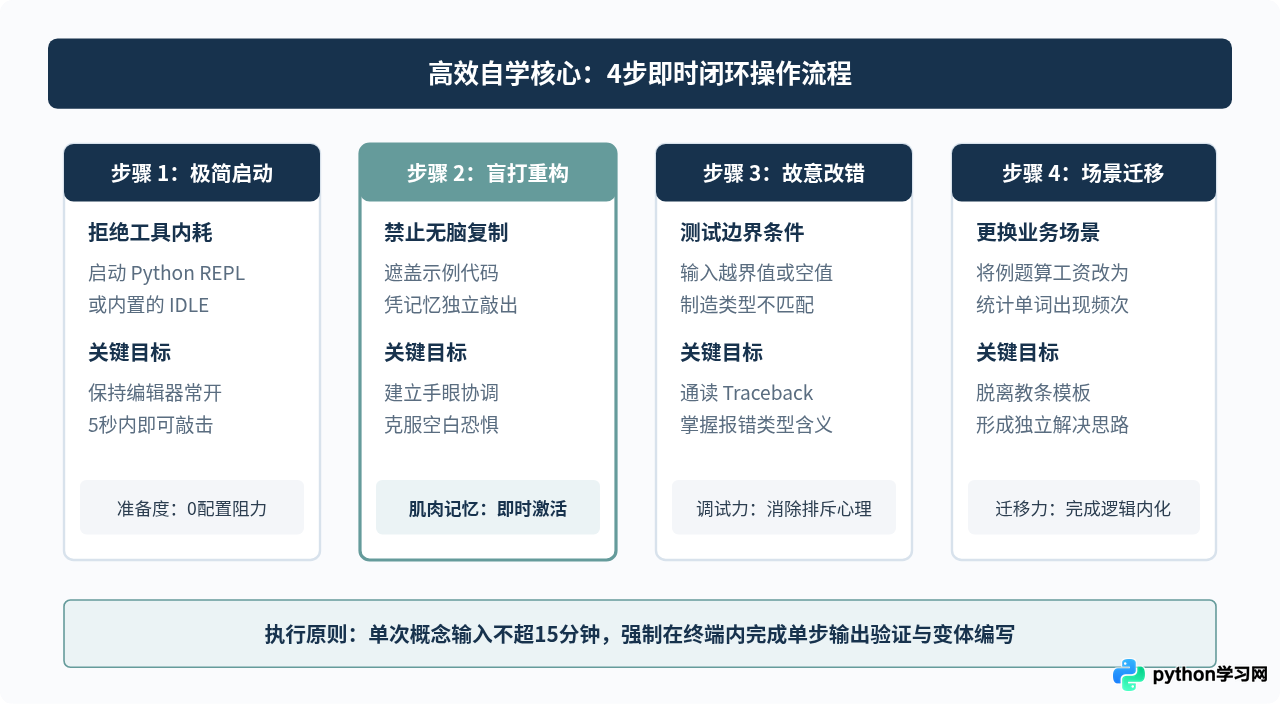
要摆脱眼高手低的困境,必须在日常学习中建立一套强制性的操作纪律。不要追求一天学完多少页内容,而要关注当天让解释器实际运行了多少行代码。建议按照以下四个步骤来落实每一次语法学习:
第一步:搭建极简的即时验证环境
不要在初学的第一天就纠结于复杂的IDE插件配置、虚拟环境管理器或远程服务器连接。这些工具固然专业,但容易在开始阶段制造大量与语言本身无关的技术摩擦。直接打开系统终端输入 python(或使用安装包自带的 IDLE 交互窗口),保证自己随时可以在一个极简环境中敲下代码并看到回显。
第二步:执行“5分钟吸收,10分钟盲打”微循环
阅读教材或官方文档时,严格控制单次连续阅读的时间上限为5分钟。一旦看到一个代码示例(例如列表切片或字典遍历),立刻把文档遮住或最小化,在终端中凭记忆敲出相同功能的代码。如果报错或卡住,再回头看一眼,随后再次合上文档重敲,直到能一气呵成独立写出为止。
第三步:故意修改参数与制造报错
代码运行成功只是及格线,更关键的步骤是“主动破坏它”。尝试把字符串传入原本接收整数的参数,把索引越界,或者把字典中不存在的键作为取值目标。亲眼看到 Python 抛出 IndexError、KeyError 或 TypeError,并仔细阅读报错信息中的最后两行。只有了解代码在什么情况下会崩溃,才能真正掌握该语法的边界与安全使用方式。
第四步:脱离教材,完成功能变体
如果教材演示的是“计算员工工资列表的平均值”,那么在完成验证后,立刻将其改为“过滤出成绩及格的学生名单并去重”。更换业务场景、改变数据结构类型,迫使大脑将刚学到的语法规则应用到新的上下文中,从而完成知识的固化。
三、实战演示:从单个语法点到微型实用脚本的进阶
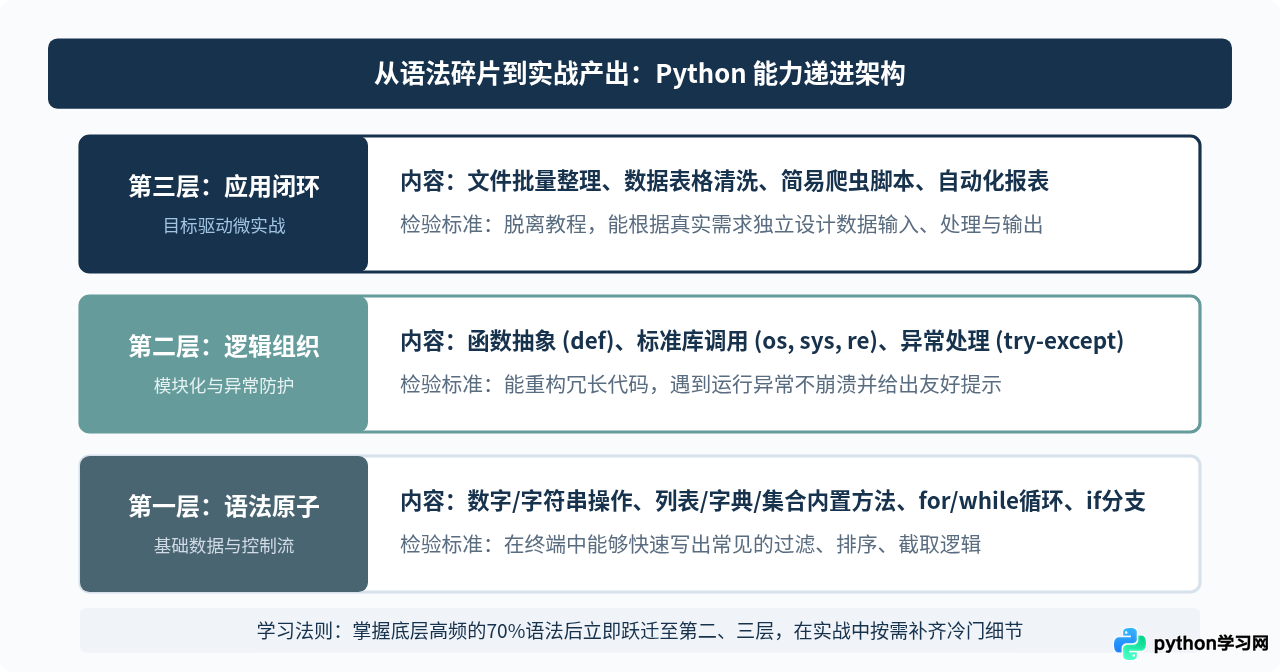
为了让自学者切身体会“代码如何从碎片成长为工具”,我们以处理日常工作中的“杂乱文件整理”为例,展示如何将基础语法层层组装成可运行的代码。
1. 在交互式环境中掌握单一语法原子
许多初学者直接上手写复杂脚本,结果多重错误交织在一起,根本分不清是字符串拆分写错还是循环逻辑写错。正确的做法是在 REPL 中先对每一个方法进行单步验证:
# 示例终端操作:验证字符串前缀与后缀处理
>>> filename = "report_2026_final.bak"
>>> filename.endswith(".bak")
True
>>> filename.replace(".bak", ".txt")
'report_2026_final.txt'
在确认了 endswith() 与 replace() 的输出完全符合预期后,我们再去学习如何调用标准库的 os 模块列出目录内容。
2. 编写具备容错能力的微型实用脚本
当下述的判断、循环与文件系统调用结合在一起时,一个只有20行的清理小工具就成型了。我们在代码中故意加入异常捕获,确保即使遇到不可读文件,程序也不会直接崩溃:
import os

def clean_backup_files(target_dir):
    """清理指定目录下所有以 .bak 结尾的冗余文件"""
    if not os.path.isdir(target_dir):
        print(f"[错误] 目录不存在: {target_dir}")
        return

    cleaned_count = 0
    for filename in os.listdir(target_dir):
        if filename.endswith(".bak"):
            full_path = os.path.join(target_dir, filename)
            try:
                os.remove(full_path)
                cleaned_count += 1
                print(f"[已删除] {filename}")
            except OSError as err:
                print(f"[跳过] 无法删除 {filename}: {err}")

    print(f"清理完毕,共移除 {cleaned_count} 个备份文件。")

# 示例调用(可在本地指定一个测试文件夹测试)
if __name__ == "__main__":
clean_backup_files("./workspace_test")实战建议:编写代码时,优先使用 os.path.join() 拼接路径,而不要直接用加号进行字符串拼接。这种细节习惯正是通过一次次实际运行脚本、在控制台观察不同系统下的输出差异所积累出来的。
四、防复发指南:保持高效自学的长效机制
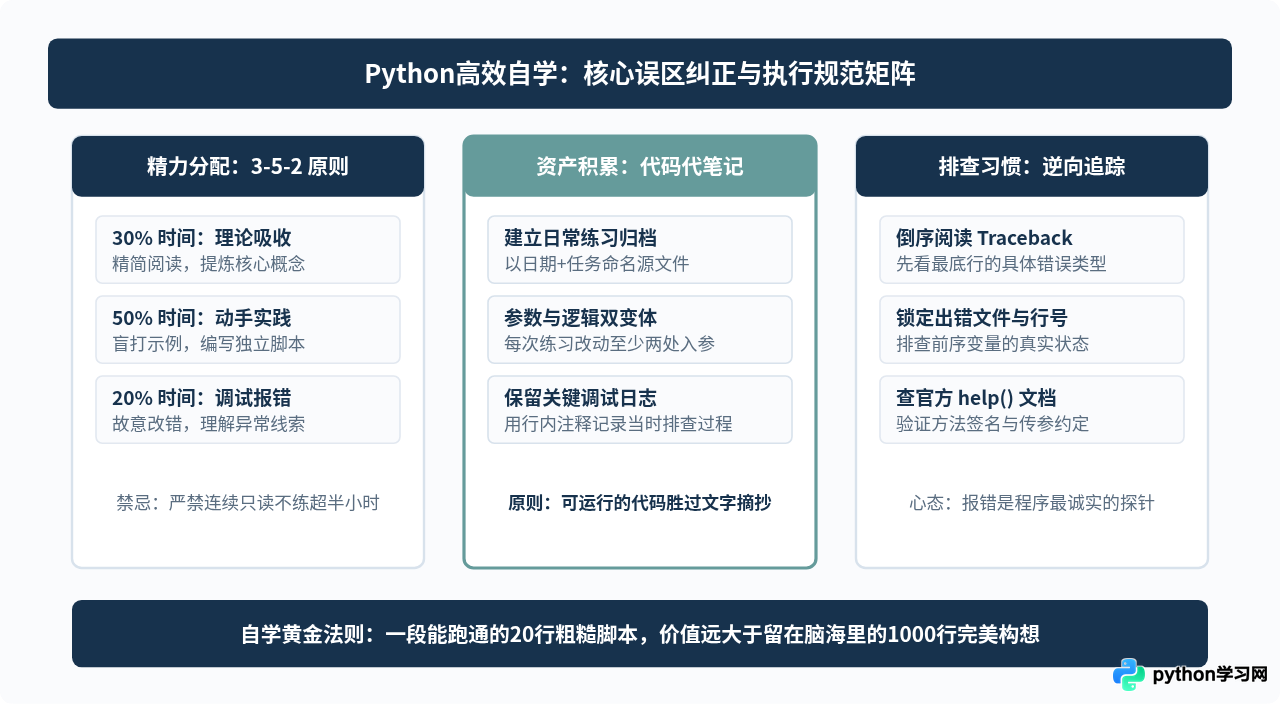
很多自学者在刚开始的几天充满干劲,敲了不少练习,但随着内容增多,旧知识遗忘、新概念受阻,又很容易退回到“躺平看视频”的舒适区。为了建立长期的学习惯性,建议遵循以下三项自律准则:
- 放弃完美主义笔记,建立按日期归档的实验代码库:初学阶段不要耗费大量精力去排版 Markdown 或绘制精美脑图,最好的笔记就是你亲手写过、能正常运行且带有注释的
.py文件。建立一个命名形如day03_string_clean.py的文件夹,把每一次的调试代码保存起来。 - 学会用内置帮助替代低效网络搜索:在终端中多使用
dir(obj)查看对象支持的所有方法,使用help(obj.method)查看标准文档说明。内置帮助准确、直接且没有任何广告干扰,能显著缩减从遇到问题到解决问题的时间。 - 恪守“先跑通、再重构”的代码编写顺序:不要在一开始就考虑设计模式、面向对象封装或运行效率。先用最直白甚至略显笨拙的顺序逻辑让功能跑通,验证无误后再考虑提炼函数与优化变量命名。
总结
自学 Python 的核心在于将注意力从“知识的广度收集”转向“键盘上的即时验证”。只要坚持极简环境、5分钟即时敲代码、主动故意制造报错、并按需组织微型实用脚本,就能彻底打破“只看不练”的假象,真正将编程语言转化为解决实际问题的工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















