


Python怎么替换字符串指定位置的字符

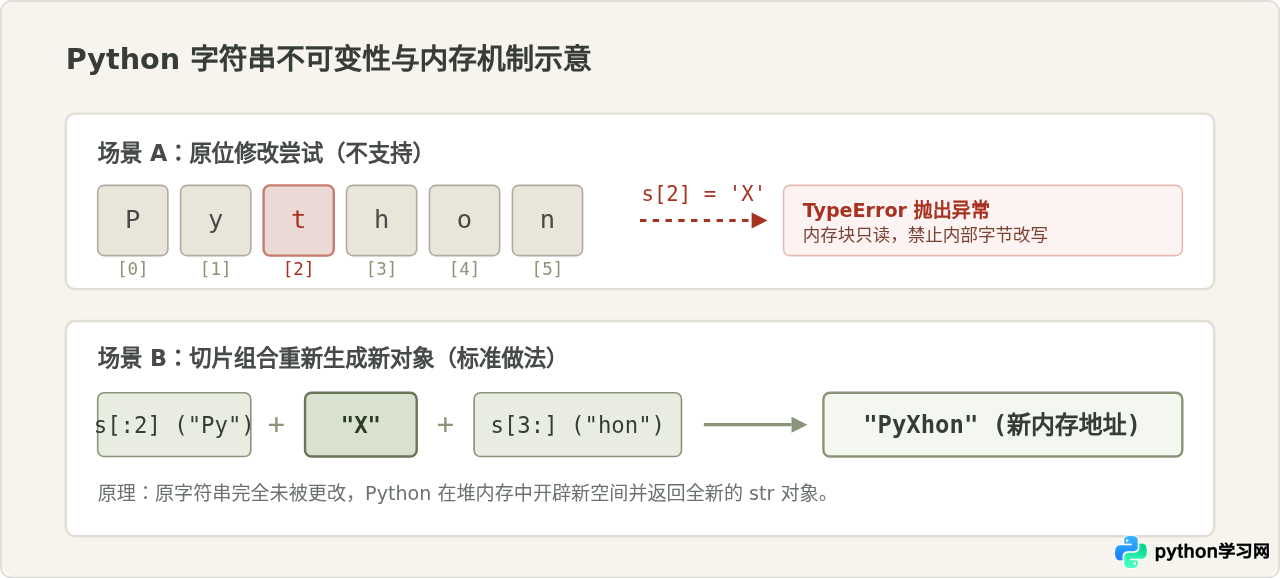
在 Python 中,直接对字符串按索引赋值(如 s[2] = 'x')会引发 TypeError 异常,因为字符串属于不可变类型(immutable)。要替换指定索引位置的字符,标准做法是基于原字符串生成一个新的字符串。最常用的两种方式是:单次替换使用切片拼接法(s[:i] + new_char + s[i+1:]),多次替换则先用 list(s) 转换为字符列表,就地修改后再通过 "".join() 拼回字符串。
为什么不能直接对字符串索引赋值
很多刚接触 Python 的开发者习惯了 C/C++ 或其他语言中字符数组的修改逻辑,容易写出如下代码:
text = "Python"
# 试图将位置 2 的字符 't' 替换为 'X'
text[2] = "X"TypeError: 'str' object does not support item assignment
该错误明确提示:str 对象不支持元素赋值。在 Python 的底层实现中,字符串对象一经创建,其内部缓冲区所占用的内存和字符序列便被固定。这一设计带来了多项核心优势:哈希值稳定(因此字符串能作为字典的键和集合的元素)、内存共享与驻留优化(避免重复分配相同短文本),以及多线程环境下的线程安全性。
方法一:切片拼接法(单次替换首选)
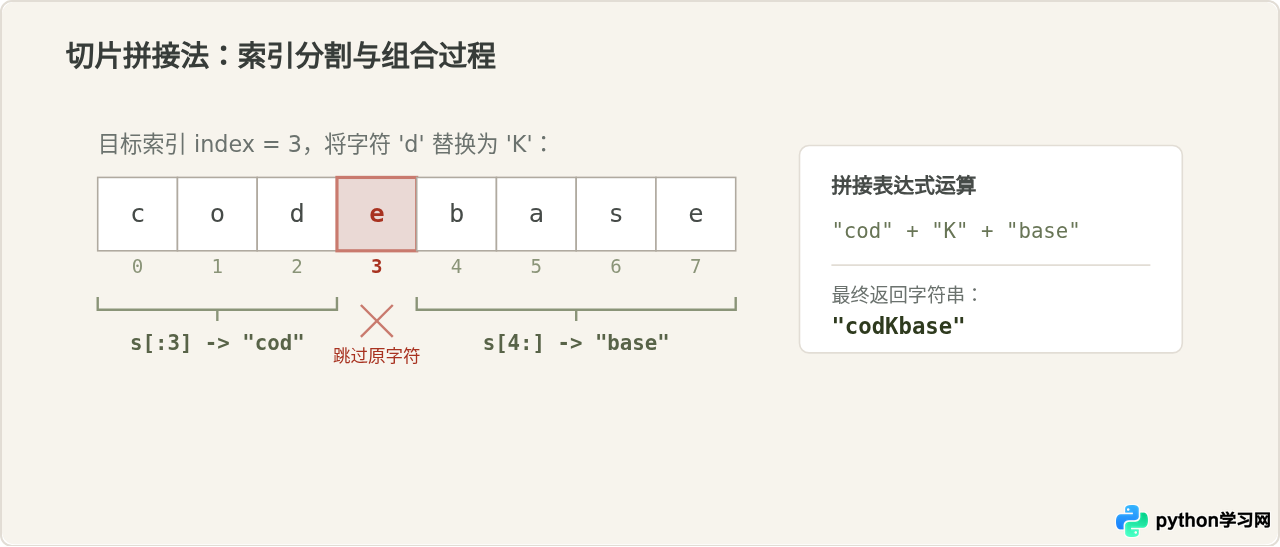
对于单次替换某个索引位置的字符,切片(Slicing)加字符串拼接是语法最直接、执行效率最高的方式。其基本逻辑是将原字符串从待替换位置左右截开,在中间嵌入目标字符:
s = "Hello World"
index = 6
new_char = "w"

# 拼接:左半部分 + 新字符 + 右半部分
result = s[:index] + new_char + s[index + 1:]
print(result)Hello world
切片索引分割细节
Python 切片语法 s[start:end] 是左闭右开区间。假定要修改索引为 i 的字符:
s[:i]:获取从开头到索引i - 1的子串(共i个字符)。new_char:插入的新字符或新子串(支持单字符或任意长度字符串)。s[i + 1:]:跳过原索引i,截取从i + 1到末尾的全部子串。
方法二:列表转换法(多次修改首选)
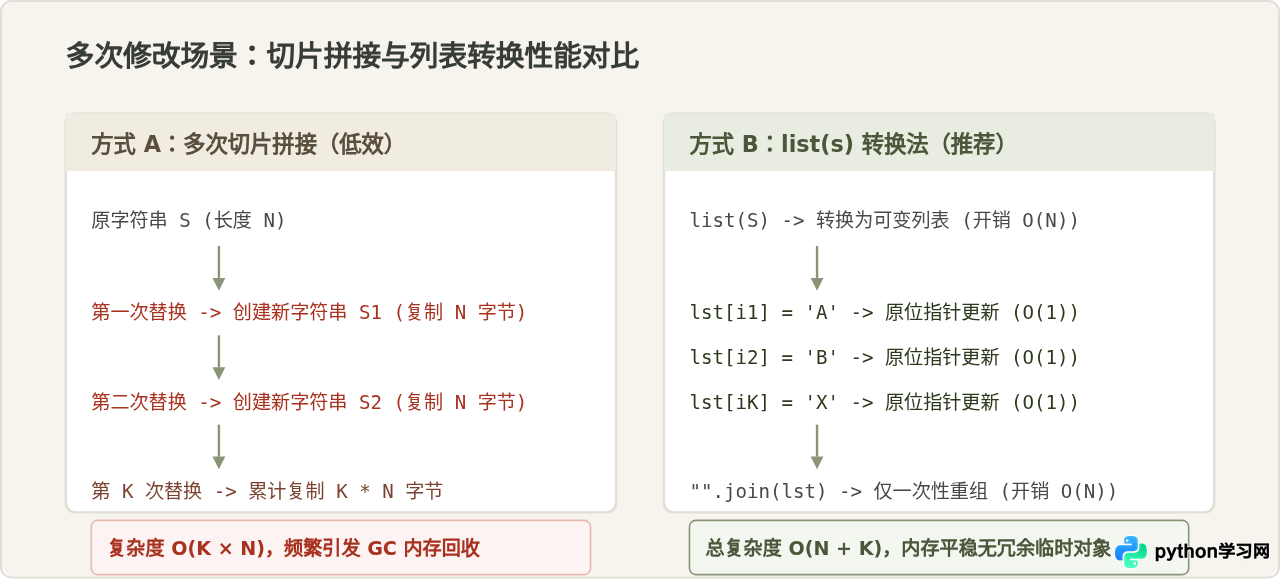
如果需要在循环中多次修改同一个字符串不同位置的字符,或者需要同时批量替换多个索引,切片拼接法会出现性能瓶颈。每次切片拼接都会在内存中创建一份完整的字符串副本,产生 \(O(N)\) 的复制开销;若修改 \(K\) 次,总时间复杂度将上升至 \(O(K \times N)\)。
此时推荐使用列表转换法:将字符串转为可变的 list,直接就地按索引赋值修改,最后通过 "".join() 一次性组装回字符串。列表索引修改的时间复杂度仅为 \(O(1)\),整体只需在开始和结束时做两次内存转换。
s = "apple"
# 1. 转换为字符列表
char_list = list(s)

# 2. 对列表直接按索引修改(O(1) 原地操作)
char_list[0] = "A"
char_list[4] = "y"

# 3. 重新拼回字符串
result = "".join(char_list)
print(result)Apply
常见误区辨析:为什么不能直接使用 str.replace()
部分初学者容易误以为 str.replace() 可以完成“替换指定位置字符”的任务。实际上,replace(old, new, count) 是基于内容匹配,而不是基于位置索引匹配的。
辨析要点:replace() 接收的是字符本身(内容),第三个参数 count 只能限定从左往右替换的“最大次数”,而无法指定“只修改第 4 个索引位”。
s = "banana"
# 假设目标是只替换索引 3 处的字符 'a' 为 'X'
# 错误做法:直接调用 replace
wrong_result = s.replace("a", "X", 1)
print("replace 结果:", wrong_result)

# 正确做法:切片定位
index = 3
correct_result = s[:index] + "X" + s[index + 1:]
print("切片替换结果:", correct_result)replace 结果: bXnana
切片替换结果: banXna
在上述例子中,"banana" 中索引 1、3、5 处的字符都是 'a'。调用 s.replace("a", "X", 1) 只会替换最先出现的第 1 个 'a'(即索引 1),无法精准触达索引 3。因此,凡是带有明确位置索引的替换需求,切勿使用内容维度的 replace 方法。
编写健壮的替换函数:边界与负索引处理
在实际工程代码中,直接调用 s[:i] + c + s[i+1:] 可能面临两个隐患:
- 负索引边界问题:当传入
index = -1(即替换最后一个字符)时,s[index + 1:]等价于s[0:],会导致切出整个字符串,从而产生逻辑错误。 - 越界错误(IndexError):Python 切片在索引超出范围时不会报错(例如
"abc"[100:]返回空串),这可能导致静默吞掉越界 Bug,掩盖逻辑缺陷。
以下是封装好的严谨替换函数,统一支持正负索引校验与长度保护:
def replace_char_at(text: str, index: int, new_char: str) -> str:
    """
    安全替换字符串指定位置的字符
    :param text: 原字符串
    :param index: 替换位置(支持正索引和负索引)
    :param new_char: 替换后的字符或字符串
    :return: 替换完成后的新字符串
    """
    length = len(text)

    # 负索引标准化转为正索引
    normalized_index = index if index >= 0 else index + length

    # 显式越界检查
    if not (0 <= normalized_index < length):
        raise IndexError(f"字符串索引超出范围: 长度 {length}, 传入索引 {index}")

    return text[:normalized_index] + new_char + text[normalized_index + 1:]

# 验证效果
sample = "abcdef"
print(replace_char_at(sample, 2, "Z"))    # 正索引:abZdef
print(replace_char_at(sample, -1, "X"))   # 负索引末尾:abcdeX
print(replace_char_at(sample, -3, "M")) # 负索引倒数第三:abcMefabZdef
abcdeX
abcMef
方法选型与总结
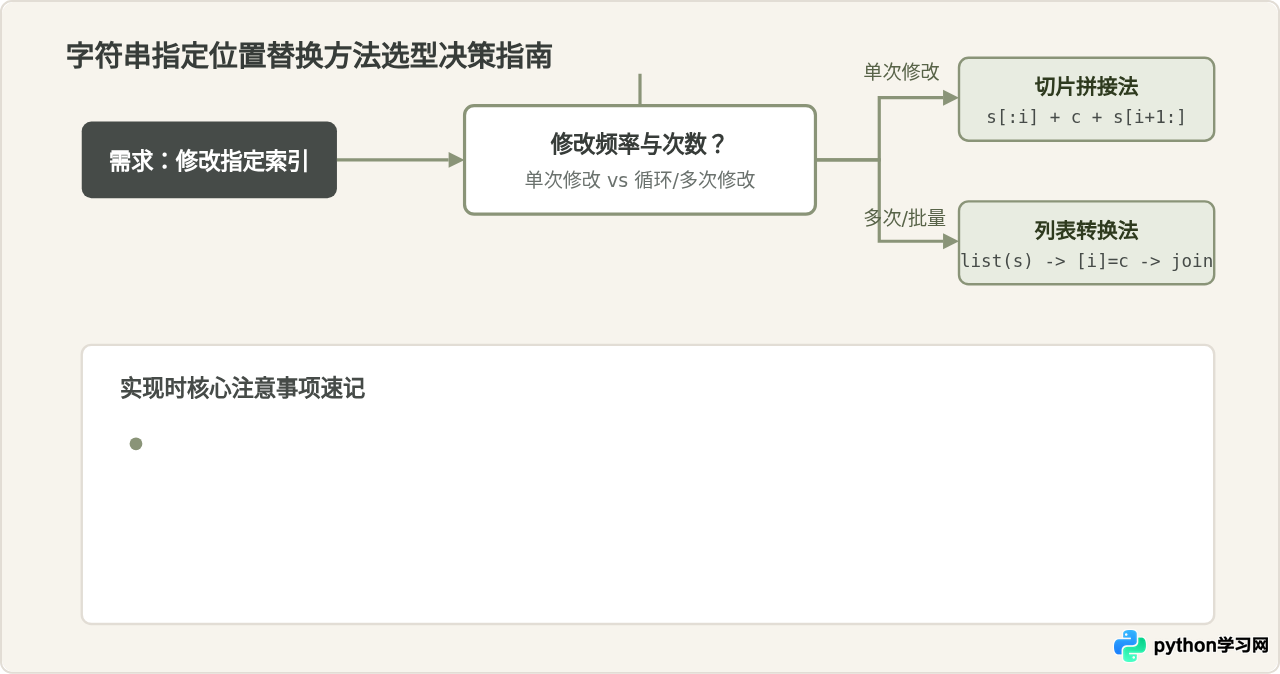
替换 Python 字符串中指定位置的字符,虽然在语法形式上没有原位赋值运算符,但通过切片与容器转换均能高效达成。不同场景下的技术选型可参考下表与决策图:
| 技术方案 | 适用场景 | 优点 | 注意事项 |
|---|---|---|---|
| 切片拼接法 | 单次替换、代码简短、确定索引位 | 无类型转换,单次操作速度最快,语法直观 | 注意负索引 -1 时的边界处理 |
| 列表转换法 | 多次修改、批量替换、循环原地更新 | 多次修改时避免冗余复制,整体性能稳定 | 需占用两倍内存存储列表结构 |
| bytearray 转换 | 纯 ASCII 编码或底层字节流处理 | 支持真正意义上的就地(In-place)修改 | 仅支持字节/ASCII,非 ASCII 字符需处理多字节解码 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















