


Python print函数怎么用:sep、end与file参数详解

print 函数的完整原型与执行机制
在 Python 3 中,print() 是一个标准的内置函数,它的官方定义原型如下:
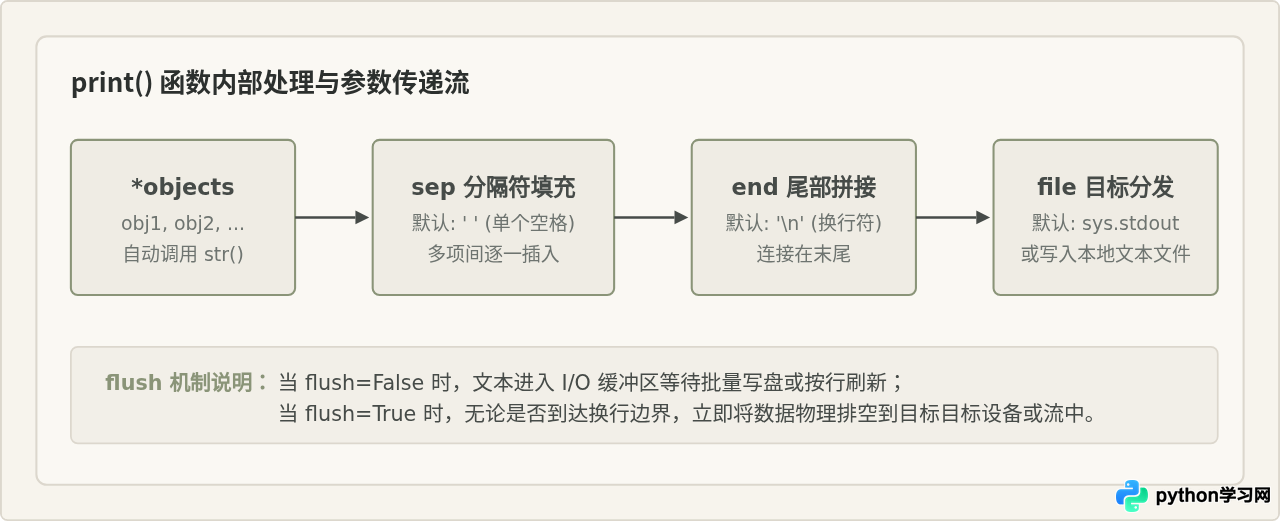
print(*objects, sep=' ', end='\n', file=None, flush=False)该原型揭示了控制台输出背后的具体逻辑:
*objects:可变位置参数,支持同时传入任意数量的对象。如果传入多个对象,Python 会在内部自动调用每个对象的str()方法将其转为文本。sep:指定在多个对象之间插入的分隔字符串,默认是一个半角空格' '。end:指定在全部内容输出完毕后追加的尾部字符,默认是换行符'\n'。file:指定数据写入的目标流对象,默认是None,运行时会自动指向标准输出终端sys.stdout。flush:布尔值,指定是否立即强制刷新底层输出缓冲区,默认为False。
sep 参数:控制多个对象的连接符号
sep 是 separator(分隔符)的缩写。在调用 print() 传入两个及以上对象时,Python 会将 sep 的字符串值插入在每两个相邻对象的文本表示之间。
1. 改变常见格式输出
在默认情况下,多个参数之间使用单个空格分开。如果需要格式化输出日期、路径或逗号分隔格式(CSV),可以直接指定 sep:
# 默认输出:空格隔开
print("2026", "10", "22")
# 示例输出:2026 10 22

# 使用破折号拼接日期
print("2026", "10", "22", sep="-")
# 示例输出:2026-10-22

# 输出为逗号分隔格式 (CSV 记录)
print("Alice", 28, "Engineer", "Beijing", sep=",")
# 示例输出:Alice,28,Engineer,Beijing

# 输出换行分隔的多行文本
print("项目1", "项目2", "项目3", sep="\n")
# 示例输出:
# 项目1
# 项目2
# 项目3
2. 紧密拼接:设置 sep=''
当希望把数字与文字、或是前缀与后缀拼合在一起且不留空隙时,将 sep 设为空字符串 '' 是非常直接的处理方式:
currency = "CNY"
amount = 899.5
print(currency, amount, sep="")
# 示例输出:CNY899.5注意边界条件:sep 参数只在传入多个参数(用逗号隔开)时起作用。如果只向 print() 传入了一个已经被拼接好的字符串表达式,例如 print("A" + "B", sep="-"),此时位置参数实际只有一个,sep 将不会产生任何效果。
end 参数:控制行尾结尾标记与单行输出
end 参数决定了当前 print() 调用完成之后追加的内容。很多读者经常困惑“为什么每次调用 print 都会自动另起一行”,原因就在于 end 默认被设置成了换行符 '\n'。
1. 避免自动换行与行间紧凑排版
将 end 设置为空字符串 '' 或其他标记符号,可以让下一次调用 print() 的输出紧接在当前内容之后:
# 默认情况下连续两次调用输出在不同行
print("正在载入配置...", end=" ")
print("完成")
# 示例输出:正在载入配置... 完成

# 在同循环中以制表符相连
for i in range(1, 5):
    print(f"[{i}]", end="\t")
print()  # 打印一个空行重置光标
# 示例输出:[1]	[2]	[3]	[4]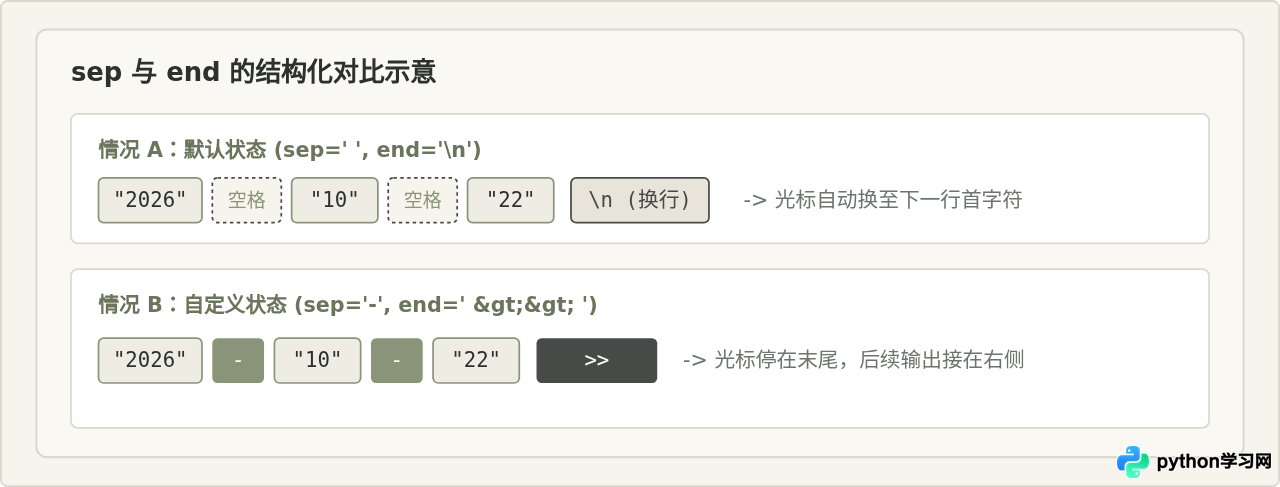
2. 结合 flush 参数消除行缓冲延迟
在标准终端环境中,标准输出流(sys.stdout)通常采用“行缓冲”机制。这意味着只有遇到换行符 '\n',或者缓冲区填满时,内容才会被物理显示到屏幕上。
如果将 end 设置为空字符串用于实现单行进度刷新或动态计数,控制台可能因为没有收到 '\n' 而暂存数据,导致界面看似假死,最后一次性全弹出来。此时必须搭配 flush=True:
import time

# 模拟加载进度显示
for step in range(1, 6):
    print(f".", end="", flush=True)
    time.sleep(0.5)

print(" 完毕!")
# 效果:屏幕上每隔0.5秒立即出现一个点,不会产生视觉滞后
file 参数:将输出目标重定向至文件与流
file 参数允许我们改变输出的目的地。只要一个对象具有符合 Python 协议的 write(string) 方法,就可以作为 file 的赋值对象。默认情况下它是 sys.stdout,也可以是打开的文件句柄、标准错误流 sys.stderr 或内存字符串流 io.StringIO。
1. 使用上下文管理器写入本地文件
在需要记录运行日志或生成报告时,结合 with open(...) 可以安全高效地向文件输出内容,无须手动进行字符串转换与换行拼接:
log_path = "app_runtime.log"

with open(log_path, mode="a", encoding="utf-8") as f:
    # 相比 f.write(),print 会自动转字符串并自动添加换行
    print("2026-10-22 23:00:00", "[INFO]", "任务启动成功", file=f)
    print("处理记录数:", 1024, "耗时(ms):", 35.8, file=f)

# 验证文件写入情况
with open(log_path, mode="r", encoding="utf-8") as f:
    print(f.read())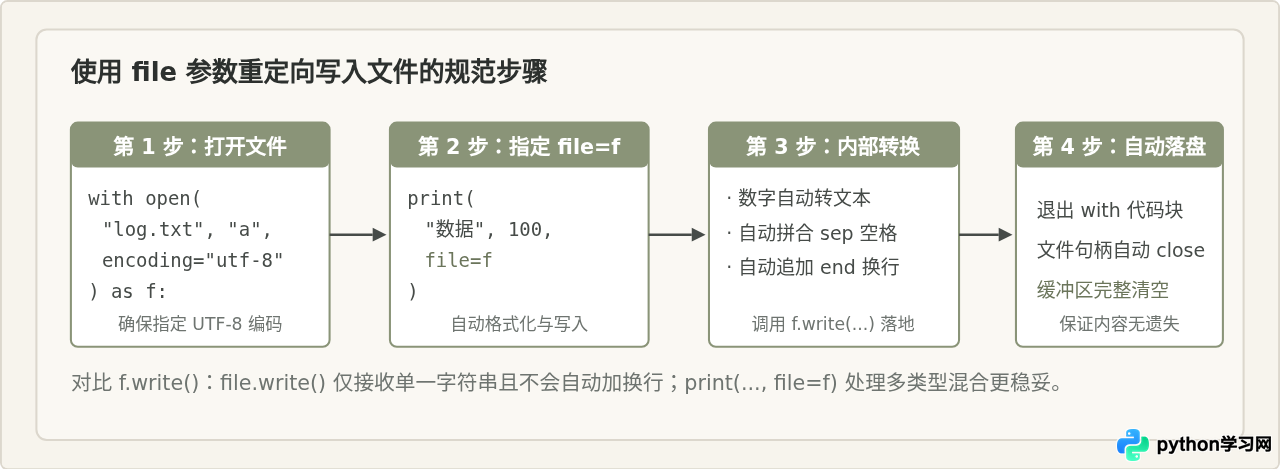
2. 重定向到标准错误流 sys.stderr
在编写命令行工具或后台脚本时,将普通信息与告警报错区分开是良好的编程习惯。通过指定 file=sys.stderr,可以在标准输出被管道重定向到文件时,依然让错误警报正常显示在终端窗口中:
import sys

# 正常标准输出 (文件描述符 1)
print("开始解析数据包...")

# 错误或预警信息输出到 stderr (文件描述符 2)
print("警告: 发现未定义的参数配置,已采用默认配置替代。", file=sys.stderr)
常见混淆点与实践辨析
辨析 1:字符串加号拼接与 print 多参数传递
有些开发者认为:直接写 print("总数: " + count) 比 print("总数:", count) 更明确。这种写法在 count 是整数或浮点数时,会直接抛出 TypeError: can only concatenate str (not "int") to str 运行时异常。
使用逗号传递多个参数,底层会自动对每个对象调用 str(),不仅避免了手动类型转换的代码冗余,而且在多变量输出时更加稳健。如果需要去掉多余的空格,传入 sep="" 即可,无需改用 + 进行手动拼接。
辨析 2:已经有了 f-string,还需要这些参数吗?
自 Python 3.6 引入 f-string(格式化字符串字面量)后,文本的行内排版变得非常优雅。例如 print(f"{year}-{month}-{day}") 确实可以完成日期的拼接。但在以下场景中,内置命名参数依然不可替代:
- 动态容器解包:对于未知长度的列表或元组,
print(*items, sep=", ")能够一行代码完成所有元素的格式化展开,无需额外调用", ".join(map(str, items))。 - 跨调用的光标控制:f-string 只能控制单次格式化的内容本身,不能控制输出光标是否换行,必须依赖
end=""。 - 物理输出分流:重定向目标必须通过
file参数实现,这是单纯的字符串格式化机制无法做到的。
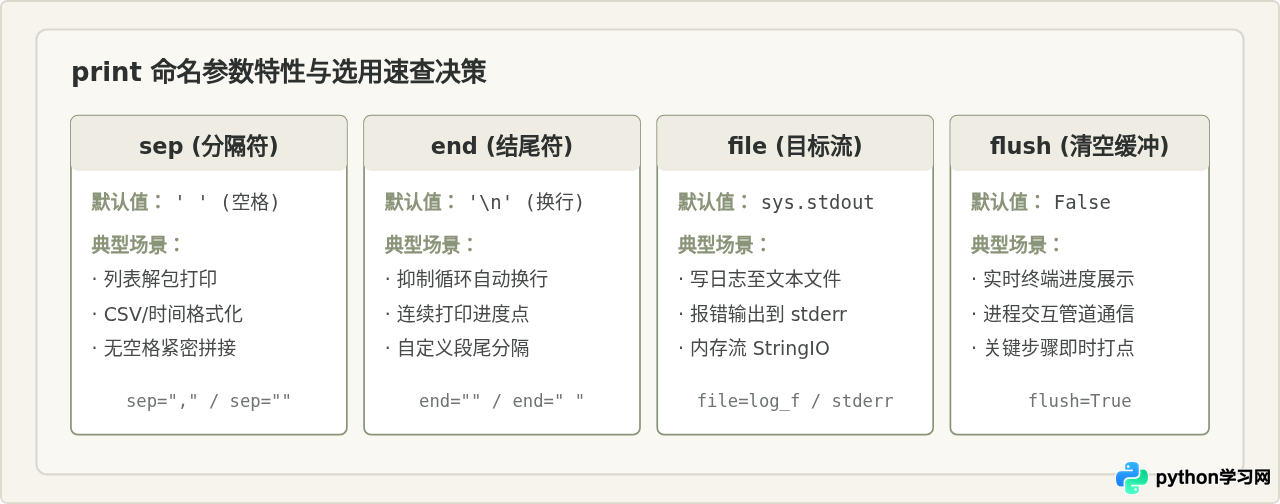
参数核心特性速查表
| 参数名称 | 默认值 | 接受类型 | 核心作用 |
|---|---|---|---|
*objects |
无 | 任意类型(可变数量) | 需要打印的数据,在内部逐一自动调用 str() 转换 |
sep |
' ' (空格) |
str 或 None |
多个对象输出时的中间连接字符 |
end |
'\n' (换行符) |
str 或 None |
本次输出结束时追加的尾部字符,控制光标换行行为 |
file |
sys.stdout |
具有 write() 方法的流对象 |
指定数据写入的目标流,常用于文件重定向或错误流 |
flush |
False |
bool |
控制是否立即强制清空底层输出缓冲区,避免终端显示滞后 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















