


Python手写词法分析器:基于正则表达式的Tokenizer实现

词法分析是编译和解析的第一步——把一串原始字符拆成有类型的记号(Token)。Python标准库的 re 模块提供了足够的正则能力,配合 re.compile 和命名分组,几十行代码就能写出一个可用的 Tokenizer。本文从 Token 的定义开始,逐步构建一个完整的手写词法分析器,最终用它处理一段简单的算术表达式源码。
一、词法分析器做什么
词法分析器(Lexer / Tokenizer)的输入是一段源代码字符串,输出是一个 Token 序列。每个 Token 至少包含两个信息:类型(比如 NUMBER、IDENTIFIER、PLUS)和值(对应源码中的原始文本)。有些实现还会记录行号和列号,方便后续报错。
以表达式 x = 3 + 42 * y 为例,词法分析器应该输出如下 Token 序列:
| 类型 | 值 |
|---|---|
| IDENTIFIER | x |
| ASSIGN | = |
| NUMBER | 3 |
| PLUS | + |
| NUMBER | 42 |
| STAR | * |
| IDENTIFIER | y |
空格和换行通常在这一步被丢弃(除非语言语法需要它们)。遇到无法识别的字符时,词法分析器应该报错并指出位置。
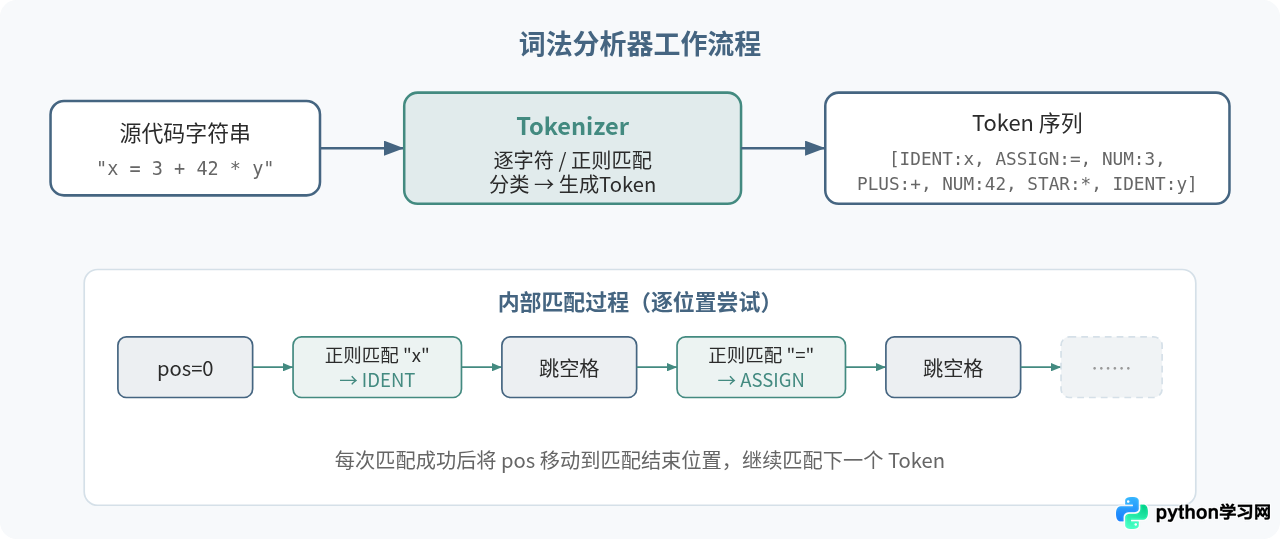
二、用命名分组构建主正则
手写 Tokenizer 最直接的办法是:为每种 Token 写一条正则,然后用 |(或运算)把它们合并成一条大正则。Python 的命名分组 (?P<NAME>...) 能让我们在匹配成功后直接知道命中了哪种 Token。
需要注意的是,re 模块要求同一正则里命名分组不能重名。在合并时,每种 Token 类型的名字就是分组名,不会冲突。
定义 Token 规则
用一个列表存储每种 Token 的名称和对应正则。顺序很重要:正则引擎从左到右尝试匹配,把更长、更具体的模式放前面。比如 >= 必须排在 > 前面,关键字 if 要在普通标识符之前用 \b 限定边界。
import re
from typing import NamedTuple

# Token 数据结构
class Token(NamedTuple):
    type: str    # Token 类型
    value: str   # 原始文本
    line: int    # 行号
    column: int  # 列号

# Token 规则列表:(类型名, 正则表达式)
TOKEN_SPEC = [
    ('NUMBER',    r'\d+(\.\d*)?'),   # 整数或小数
    ('ASSIGN',    r'='),              # 赋值
    ('PLUS',      r'\+'),             # 加号
    ('MINUS',     r'-'),              # 减号
    ('STAR',      r'\*'),             # 乘号
    ('SLASH',     r'/'),              # 除号
    ('LPAREN',    r'\('),             # 左括号
    ('RPAREN',    r'\)'),             # 右括号
    ('IDENT',     r'[A-Za-z_]\w*'),   # 标识符
    ('NEWLINE',   r'\n'),             # 换行
    ('SKIP',      r'[ \t]+'),         # 空格和制表符(跳过)
    ('MISMATCH',  r'.'),              # 无法识别的字符
]
几点说明:
NUMBER放在IDENT前面,因为\d+不会和标识符冲突,但顺序清晰更易维护。SKIP用来吃掉空白,匹配后不生成 Token。MISMATCH放在最后,任何前面都没匹配上的字符会落到这里,触发报错。
合并正则
把所有规则用 | 拼接成一条带命名分组的正则:
tok_regex = '|'.join(
    f'(?P<{name}>{pattern})' for name, pattern in TOKEN_SPEC
)
master_pat = re.compile(tok_regex)
合并后的正则大致形如:
(?P<NUMBER>\d+(\.\d*)?)|(?P<ASSIGN>=)|(?P<PLUS>\+)|... re.finditer 会从左到右依次尝试每个分支,返回第一个成功的匹配。只要规则顺序正确,就能保证最长匹配优先。
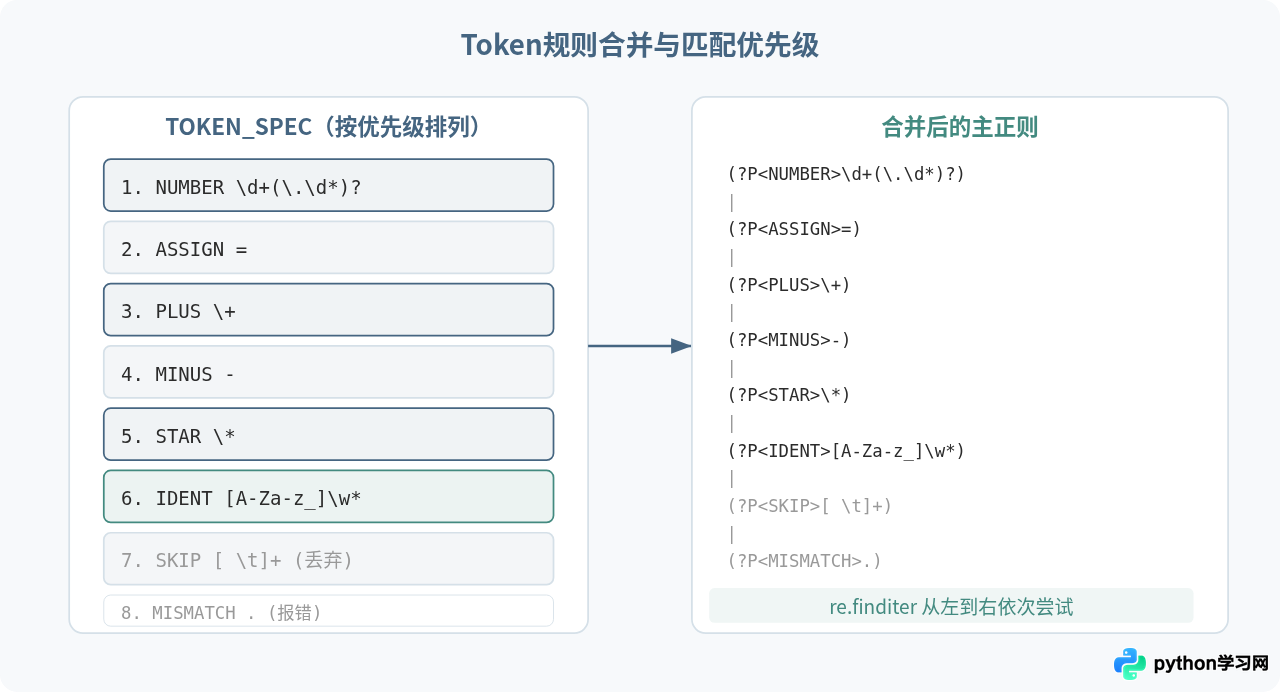
三、完整的 Tokenizer 实现
把上面的准备工作整合成一个 tokenize 函数。它接收源代码字符串,返回 Token 生成器:
import re
from typing import NamedTuple, Generator

class Token(NamedTuple):
    type: str
    value: str
    line: int
    column: int

TOKEN_SPEC = [
    ('NUMBER',    r'\d+(\.\d*)?'),
    ('ASSIGN',    r'='),
    ('PLUS',      r'\+'),
    ('MINUS',     r'-'),
    ('STAR',      r'\*'),
    ('SLASH',     r'/'),
    ('LPAREN',    r'\('),
    ('RPAREN',    r'\)'),
    ('IDENT',     r'[A-Za-z_]\w*'),
    ('NEWLINE',   r'\n'),
    ('SKIP',      r'[ \t]+'),
    ('MISMATCH',  r'.'),
]

def tokenize(code: str) -> Generator[Token, None, None]:
    tok_regex = '|'.join(
        f'(?P<{name}>{pattern})' for name, pattern in TOKEN_SPEC
    )
    master_pat = re.compile(tok_regex)

    line_num = 1
    line_start = 0

    for mo in master_pat.finditer(code):
        kind = mo.lastgroup        # 命中的分组名
        value = mo.group()         # 匹配到的文本
        column = mo.start() - line_start + 1

        if kind == 'NUMBER':
            # 如果包含小数点就转 float,否则 int
            # 这里只记录原始文本,类型转换留给后续阶段
            pass
        elif kind == 'NEWLINE':
            line_num += 1
            line_start = mo.end()
            continue
        elif kind == 'SKIP':
            continue
        elif kind == 'MISMATCH':
            raise RuntimeError(
                f'第 {line_num} 行第 {column} 列:'
                f'无法识别的字符 {value!r}'
            )

        yield Token(kind, value, line_num, column)
几个关键点:
mo.lastgroup返回匹配成功的命名分组名称,直接就是 Token 类型。- 行号和列号通过记录每行起始位置来计算,不需要逐字符扫描。
NEWLINE和SKIP匹配后执行continue,不产出 Token。- 遇到
MISMATCH抛异常,附带准确的位置信息。
四、测试运行
写一段测试代码验证 Tokenizer 的输出:
source = '''x = 3 + 42
result = x * (y - 1)
'''

print(f'{"类型":<12} {"值":<10} {"行":<4} {"列":<4}')
print('-' * 36)
for tok in tokenize(source):
    print(f'{tok.type:<12} {tok.value:<10} {tok.line:<4} {tok.column:<4}')
示例输出:
类型           值          行   列
------------------------------------
IDENT        x          1    1
ASSIGN       =          1    3
NUMBER       3          1    5
PLUS         +          1    7
NUMBER       42         1    9
IDENT        result     2    1
ASSIGN       =          2    8
IDENT        x          2    10
STAR         *          2    12
LPAREN       (          2    14
IDENT        y          2    15
MINUS        -          2    17
NUMBER       1          2    19
RPAREN       )          2    20
每个 Token 的类型、值、行号、列号都准确对应源码位置。如果源码中出现 # 或 @ 等未定义的字符,MISMATCH 规则会触发异常并报出具体位置。
五、如何扩展
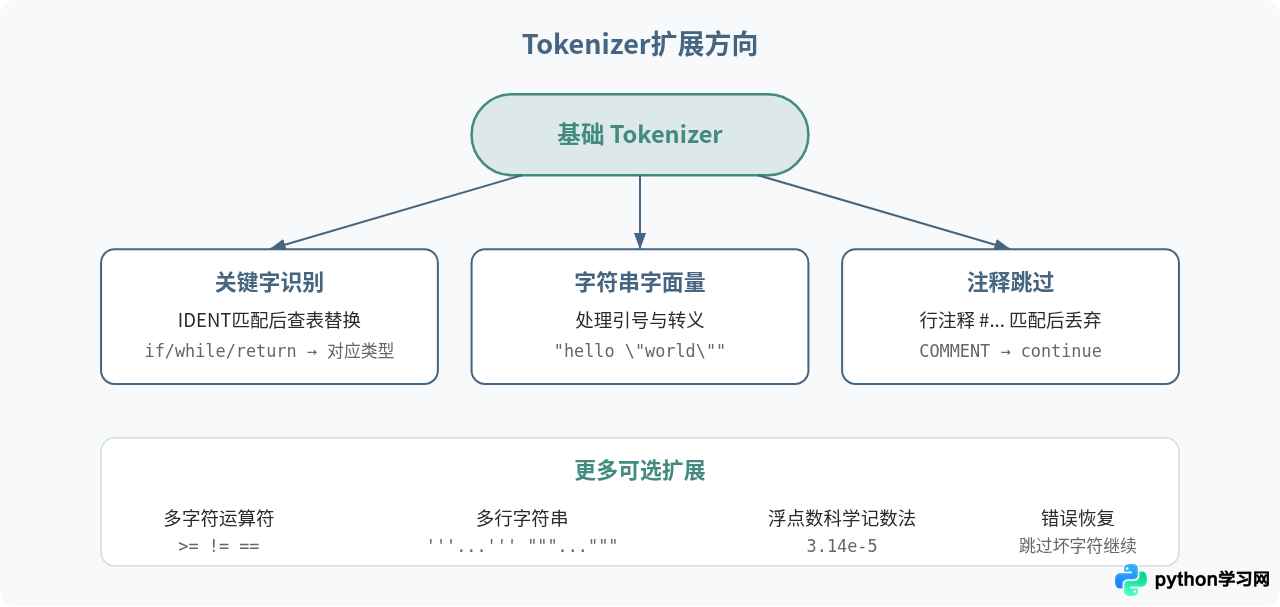
上面的 Tokenizer 处理的是简单算术表达式。实际应用中,可以按需扩展规则。下面列出几个常见方向。
添加关键字识别
许多语言有保留关键字(如 if、while、return)。一种做法是先按 IDENT 匹配,再在生成 Token 时查表替换类型:
KEYWORDS = {'if', 'else', 'while', 'return', 'def'}

# 在 tokenize 函数中,匹配到 IDENT 后加入:
if kind == 'IDENT' and value in KEYWORDS:
    kind = value.upper()   # 'if' -> 'IF', 'while' -> 'WHILE'
这比为每个关键字写一条正则更简洁,也不容易因为顺序出错。
支持字符串字面量
在 TOKEN_SPEC 中添加字符串规则。双引号字符串的正则可以写成:
('STRING', r'"[^"\\]*(?:\\.[^"\\]*)*"'),这条正则处理了转义字符的情况(如 \"),需要放在 MISMATCH 之前。
支持注释
行注释通常匹配到行末:
('COMMENT', r'#[^\n]*'),把 COMMENT 和 SKIP 一样处理——匹配后跳过,不生成 Token。
六、常见问题与注意事项
规则顺序导致错误匹配
如果把 IDENT 放在 NUMBER 前面,像 3abc 这样的输入会先把 3 匹配为 IDENT 的一部分吗?不会——因为 [A-Za-z_]\w* 要求首字符是字母或下划线。但如果规则之间有真正的前缀冲突,顺序就至关重要。比如 == 和 =,如果 = 在前,== 永远不会被匹配到,因为引擎在第一个 = 处就成功返回了。
通用规则:更长的模式放前面,关键字用 \b 约束词边界。
性能考虑
re.finditer 在 CPython 中由 C 实现的正则引擎驱动,对于几千行的源码足够快。如果源码规模达到数万行,可以考虑:
- 预编译正则(本文已经使用
re.compile)。 - 使用
re.Scanner(非公开API,但功能类似,一些老项目在用)。 - 对性能要求极高的场景,换用 C 扩展或
mmap读取文件。
与 tokenize 标准库的区别
Python 自带 tokenize 模块,可以对 Python 源码做词法分析。它的规则完整覆盖了 Python 语法,包括缩进 Token(INDENT / DEDENT)、f-string 等。手写 Tokenizer 的意义在于:理解原理、为自定义语言或 DSL 构建解析器的第一步。
七、完整代码汇总
把上面所有部分合并成一个可以直接运行的脚本:
import re
from typing import NamedTuple, Generator

class Token(NamedTuple):
    type: str
    value: str
    line: int
    column: int

TOKEN_SPEC = [
    ('NUMBER',    r'\d+(\.\d*)?'),
    ('ASSIGN',    r'='),
    ('PLUS',      r'\+'),
    ('MINUS',     r'-'),
    ('STAR',      r'\*'),
    ('SLASH',     r'/'),
    ('LPAREN',    r'\('),
    ('RPAREN',    r'\)'),
    ('IDENT',     r'[A-Za-z_]\w*'),
    ('NEWLINE',   r'\n'),
    ('SKIP',      r'[ \t]+'),
    ('MISMATCH',  r'.'),
]

KEYWORDS = {'if', 'else', 'while', 'return', 'def'}

def tokenize(code: str) -> Generator[Token, None, None]:
    tok_regex = '|'.join(
        f'(?P<{name}>{pattern})' for name, pattern in TOKEN_SPEC
    )
    master_pat = re.compile(tok_regex)
    line_num = 1
    line_start = 0

    for mo in master_pat.finditer(code):
        kind = mo.lastgroup
        value = mo.group()
        column = mo.start() - line_start + 1

        if kind == 'NUMBER':
            pass
        elif kind == 'IDENT' and value in KEYWORDS:
            kind = value.upper()
        elif kind == 'NEWLINE':
            line_num += 1
            line_start = mo.end()
            continue
        elif kind == 'SKIP':
            continue
        elif kind == 'MISMATCH':
            raise RuntimeError(
                f'第 {line_num} 行第 {column} 列:'
                f'无法识别的字符 {value!r}'
            )

        yield Token(kind, value, line_num, column)

# ---------- 测试 ----------
if __name__ == '__main__':
    source = '''x = 3 + 42
result = x * (y - 1)
if x return y
'''
    print(f'{"类型":<12} {"值":<10} {"行":<4} {"列":<4}')
    print('-' * 36)
    for tok in tokenize(source):
        print(f'{tok.type:<12} {tok.value:<10} {tok.line:<4} {tok.column:<4}')
这段代码可以保存为 tokenizer.py,直接用 python tokenizer.py 运行,输出全部 Token 及其位置。
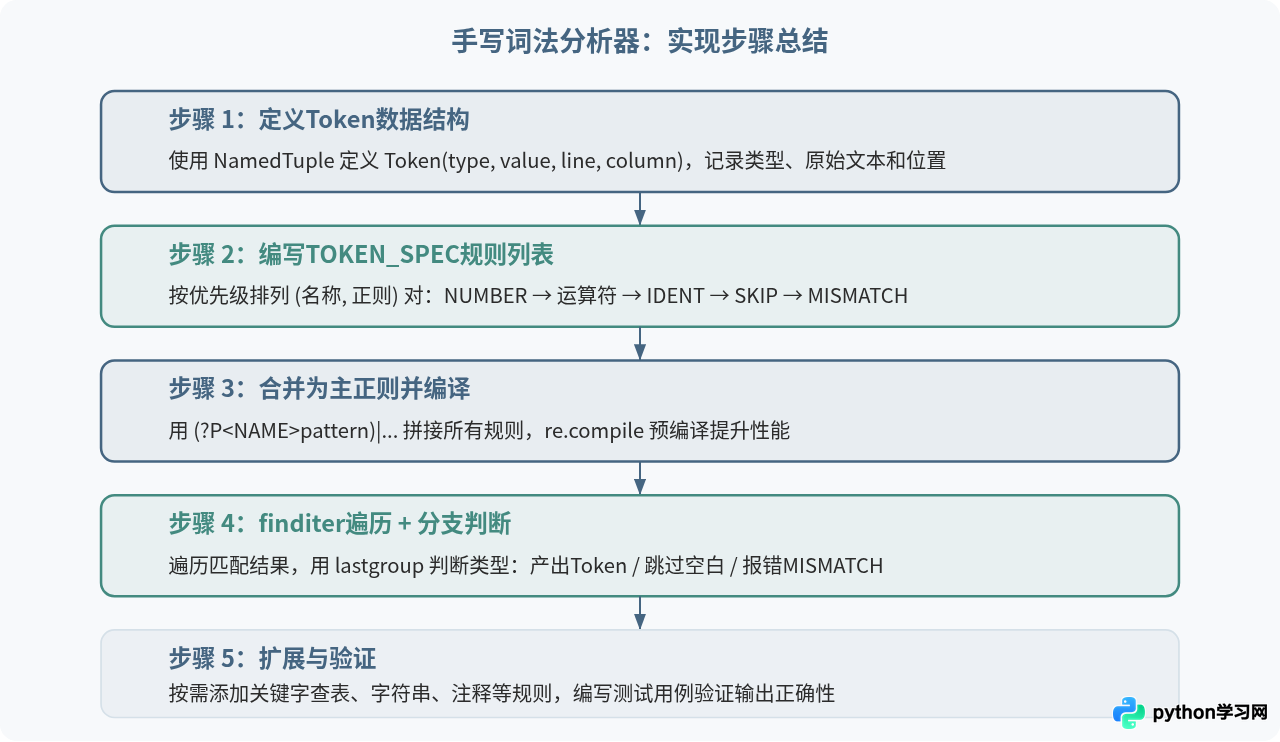
整个 Tokenizer 的核心不到 50 行。理解了这个模式之后,无论是为模板引擎写解析器、为配置文件定义格式,还是为自制编程语言搭建前端,都可以从这里开始,逐步添加规则、扩展功能。正则负责字符层面的匹配,命名分组负责分类,finditer 负责推进位置——三者配合,就是一个完整的词法分析器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















