


Python glob模块用法:使用通配符批量匹配文件路径

在处理数据整理、日志分析或批量文件重命名等日常开发任务时,根据特定规则查找文件是高频操作。Python 内置的标准库 glob 模块支持使用 Unix shell 风格的通配符进行文件路径检索,无需引入外部依赖。借助 *、? 与 [] 等模式符号,开发者能够通过极具表现力的简洁代码精确命中目标文件。
一、核心函数与执行流程
glob 模块主要对外提供两个用于检索的核心函数:glob.glob() 与 glob.iglob()。理解这两个函数的返回特性,是构建高效文件匹配逻辑的前提。
- glob.glob(pathname, *, root_dir=None, dir_fd=None, recursive=False, include_hidden=False):即时扫描目标路径,并将所有匹配到的路径作为字符串列表(
list)一次性返回。适合文件总量可预估、需要立即排序或获取长度的场景。 - glob.iglob(pathname, *, root_dir=None, dir_fd=None, recursive=False, include_hidden=False):以迭代器(生成器)的形式返回结果。每次迭代仅动态生成下一个匹配路径,不会将全部路径载入内存,适合遍历海量文件目录。
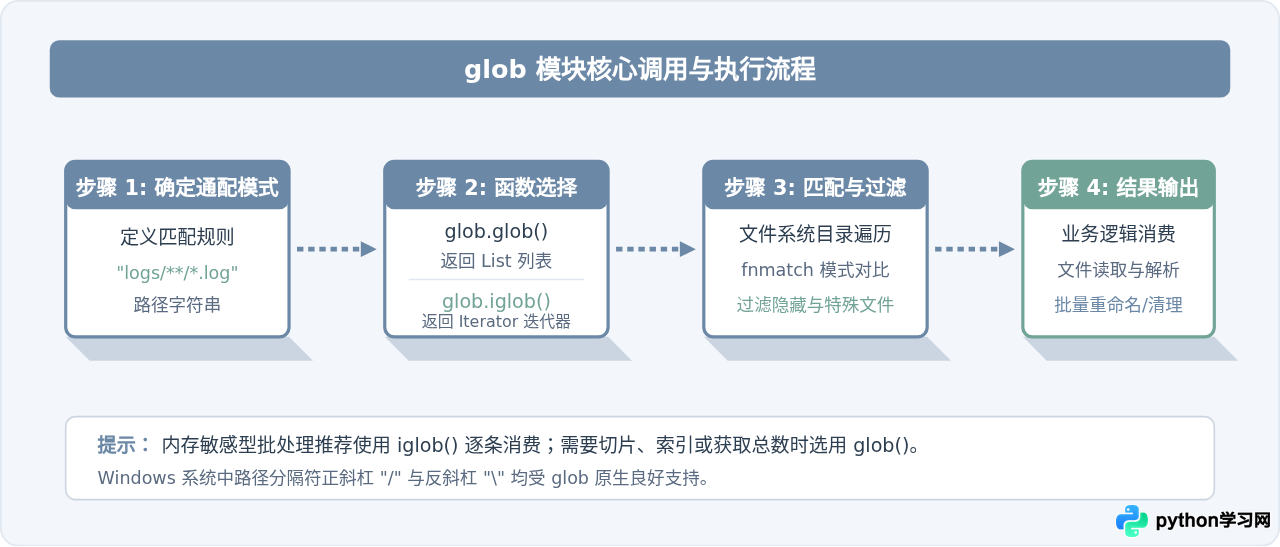
下面是一个基础调用的对比示例。注意观察两个函数返回对象的类型差异:
import glob

# 1. 使用 glob.glob() 获取列表
file_list = glob.glob("data/*.csv")
print(type(file_list))  # 输出: <class 'list'>
print(f"共发现 {len(file_list)} 个数据文件")

# 2. 使用 glob.iglob() 获取迭代器
file_iter = glob.iglob("data/*.csv")
print(type(file_iter))  # 输出: <class 'generator'>

# 遍历生成器逐个处理
for filepath in file_iter:
    print(f"正在读取: {filepath}")
二、基础通配符规则与语法详解
glob 使用与 Bash 等常用 Shell 相同的模式匹配规则,底层基于 os.scandir() 与 fnmatch.fnmatch() 实现。主要通配符包含以下四类:
- 星号
*:匹配任意数量(包括 0 个)的字符。在单层匹配中,星号不会跨越目录分隔符(如/或\)。 - 问号
?:精确匹配单个任意非目录分隔符字符。常用于匹配带有固定长度编号的文件名。 - 字符范围
[seq]:匹配字符集内部的任意一个字符。例如[0-9]匹配单数字,[a-z]匹配单个小写字母,[abc]匹配 a、b 或 c。 - 否定范围
[!seq]:匹配任何不在序列内部的字符。例如[!0-9]匹配非数字字符。
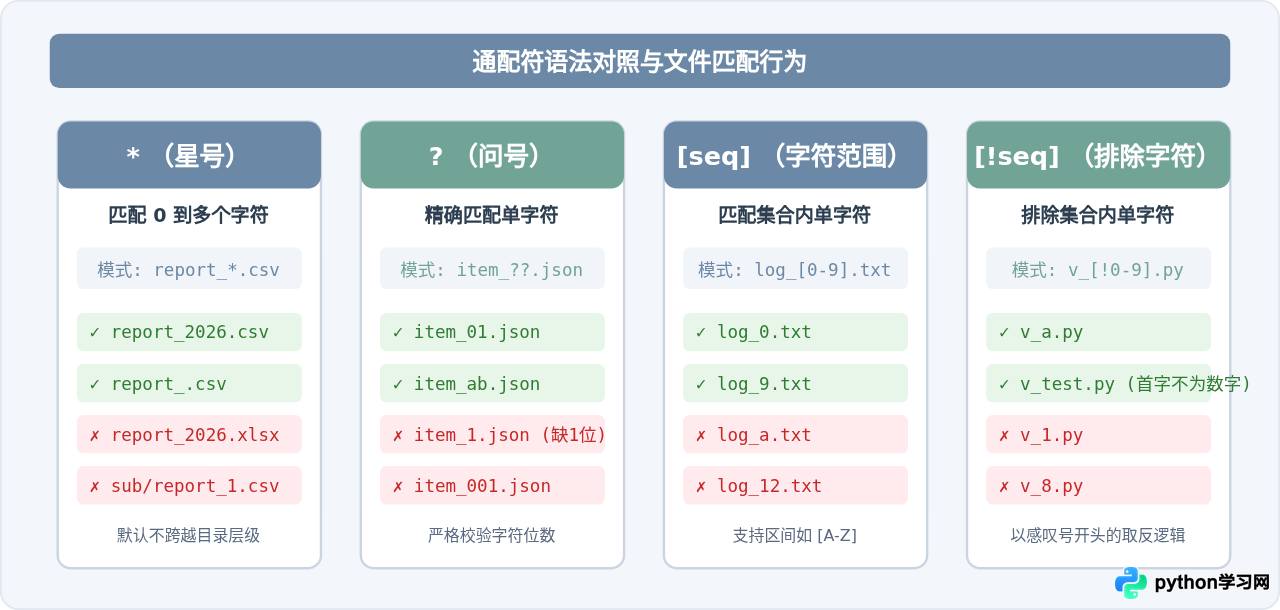
结合实际场景,可以编写如下匹配脚本:
import glob

# 场景 1:匹配所有 txt 文本文件
all_txt = glob.glob("docs/*.txt")

# 场景 2:匹配特定格式的月度归档日志(log_2026_01.log 至 log_2026_12.log)
month_logs = glob.glob("logs/log_2026_[0-1][0-9].log")

# 场景 3:精确查找命名为 node1.conf、node2.conf、node3.conf 的配置文件
nodes = glob.glob("configs/node[123].conf")

# 场景 4:排除前缀带下划线或测试标识的脚本
production_scripts = glob.glob("src/[!_]*.py")
三、递归扫描与多级目录匹配
在实际项目工程中,文件通常按模块或日期分散存放在多层嵌套的子文件夹中。传统的单层通配符 dir/*/*.py 只能精确匹配固定深度(当前为子文件夹下一级)的文件,无法向下穿透未知的层级。
从 Python 3.5 开始,glob 引入了双星号 ** 语法配合参数 recursive=True。当模式中包含 ** 且显式指定 recursive=True 时,glob 会递归搜索当前目录及所有深度的子目录。
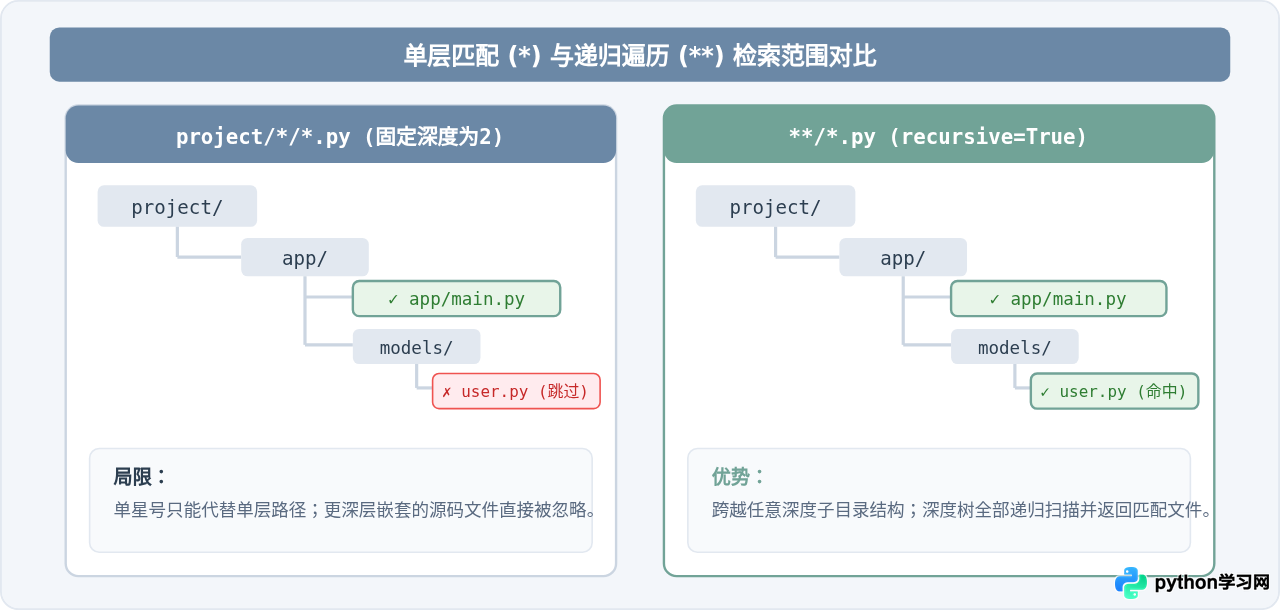
recursive=True 显式指定时,模式中的 ** 才会生效为跨层级通配符;如果遗漏该参数,** 将被降级为普通的单星号 *,仅匹配单层目录。
import glob

# 错误示范:未开启 recursive,无法遍历深层子目录
shallow_files = glob.glob("project/**/*.py")

# 正确写法:显式指定 recursive=True
all_python_files = glob.glob("project/**/*.py", recursive=True)

for path in all_python_files:
    print(path)
四、进阶特性与实用技巧
1. 转义特殊字符:glob.escape()
当要检索的真实目录名或文件名中本身就包含通配特殊字符(如文件名带中括号 [2026] Report.xlsx 或带问号)时,直接拼接模式会导致该字符被解析为通配规则,从而匹配失败。
调用 glob.escape(pathname) 可以将字符串中所有的 *、? 与 [] 进行转义,确保它们被作为普通字面量处理:
import glob

# 真实文件名中含有中括号:"[raw_data]_sample.csv"
raw_path = "dataset/[raw_data]_sample.csv"

# 错误检索:[raw_data] 会被识别为字符集
# glob.glob(raw_path) -> []

# 正确做法:使用 escape 转义前缀路径
escaped_prefix = glob.escape("dataset/[raw_data]")
pattern = f"{escaped_prefix}*.csv"
matched = glob.glob(pattern)
print(matched)  # 成功匹配
2. 根路径指定:root_dir 参数
从 Python 3.10 开始,glob() 与 iglob() 增加了 root_dir 参数。该参数允许指定匹配的基准目录,而返回的路径将直接是相对于 root_dir 的相对路径,无需手动进行字符串截取或相对路径计算:
import glob

# 检索 /var/log/ 下的所有日志,但返回相对路径
logs = glob.glob("*.log", root_dir="/var/log")
print(logs)
# 输出: ['syslog.log', 'nginx.log', 'auth.log'] 而非绝对路径
3. 包含隐藏文件:include_hidden 参数
自 Python 3.11 起,新增了 include_hidden 参数。在 Unix 类系统中,以点 . 开头的文件默认被视作隐藏文件,传统模式 * 默认忽略它们。将 include_hidden=True 开启后,通配符将完整扫描包括 .env、.gitignore 在内的隐藏文件。
五、技术选型与工具对比
在 Python 标准库与生态中,文件查找与路径操作方案众多,常见的包括 glob.glob、glob.iglob、pathlib.Path.glob 以及底层遍历工具 os.walk。各个工具的适用场景与性能特征如下:
| 工具方案 | 返回类型 | 语法风格 | 内存占用 | 适用典型场景 |
|---|---|---|---|---|
| glob.glob() | 列表 (list) | 函数式 / Shell 模式 | 中等(一次性加载) | 文件数不大、需要立即统计数量或排序的场景 |
| glob.iglob() | 生成器 (generator) | 函数式 / Shell 模式 | 极低(惰性求值) | 成千上万大批量文件的批处理与流式管道 |
| pathlib.Path.glob() | 生成器 (Path 对象) | 面向对象 | 低 | 现代 Python 代码、需要直接链式调用路径属性的方法 |
| os.walk() | 三元组生成器 | 底层迭代 | 低 | 需要深度精细控制遍历行为、根据目录名动态裁剪枝干的场景 |
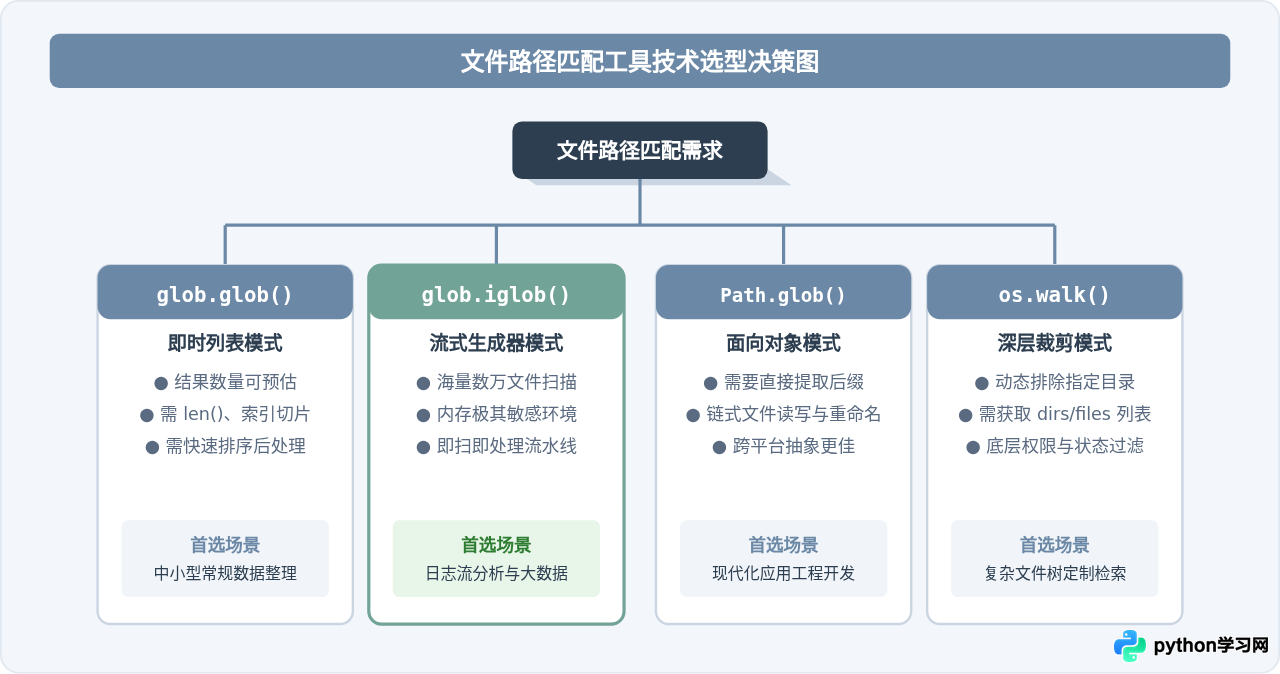
六、综合实战案例:批量解析与重命名
下面给出一个包含文件检索、内容处理与结果归档的完整范例。该场景模拟从多级实验数据目录中递归检索所有 CSV 报表,清洗后重命名备份:
import glob
import os

def process_reports(base_directory: str):
    # 构造递归检索模式:匹配所有子目录下的 2026 年数据文件
    pattern = os.path.join(base_directory, "**", "report_2026_*.csv")

    # 采用 iglob 避免一次性载入过多路径
    report_iterator = glob.iglob(pattern, recursive=True)

    success_count = 0
    for file_path in report_iterator:
        dirname, filename = os.path.split(file_path)

        # 提取文件名主体
        base_name, ext = os.path.splitext(filename)
        new_filename = f"processed_{base_name}{ext}"
        new_path = os.path.join(dirname, new_filename)

        # 执行业务处理(重命名示范)
        try:
            os.rename(file_path, new_path)
            print(f"成功归档: {file_path} -> {new_filename}")
            success_count += 1
        except OSError as err:
            print(f"处理失败 {file_path}: {err}")

    return success_count

if __name__ == "__main__":
    count = process_reports("./experiments")
    print(f"批处理完成,共归档 {count} 个文件。")
七、总结
glob 模块以其直观的 Shell 通配符语义,为 Python 开发者提供了兼具表现力与执行效率的文件批量匹配解决方案。在普通脚本与数据处理中,glob.glob() 能在极少代码量下快速获得目标路径列表;而在处理千万级海量日志或持续流式分析时,结合 glob.iglob() 与 recursive=True 则能在保障低内存开销的同时穿透多层文件树。正确运用通配符规则并注意特殊字符转义,能够显著提升路径处理逻辑的健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















