


利用Python @property实现懒加载与计算属性缓存

__init__ 初始化方法中执行这些操作,会导致对象实例化缓慢且浪费无用计算。本文通过具体代码与执行机制,讲解如何使用 Python 的 @property 装饰器实现属性的懒加载(延迟计算),并利用实例字典存储缓存结果,彻底平衡计算成本与访问体验。
一、为什么需要懒加载与计算属性缓存
在许多实际业务系统中,某些属性具备两个典型特征:第一,获取成本高(例如需要解析大型配置文件、加载数万行特征矩阵、或发起远程网络请求);第二,并不一定会立即使用,甚至在整个生命周期内只被某些特定分支代码访问。
常规做法往往有两种极端:
- 在
__init__中提前加载:即使后续业务流程根本不需要该属性,对象实例化时也会强行阻塞等待,严重拖慢启动速度并虚占内存。 - 使用普通方法
get_data()动态计算:虽然实现了按需调用,但若同一实例在多个地方反复调用,每次都会重新触发高昂的计算,造成严重的 CPU 与 I/O 资源浪费。
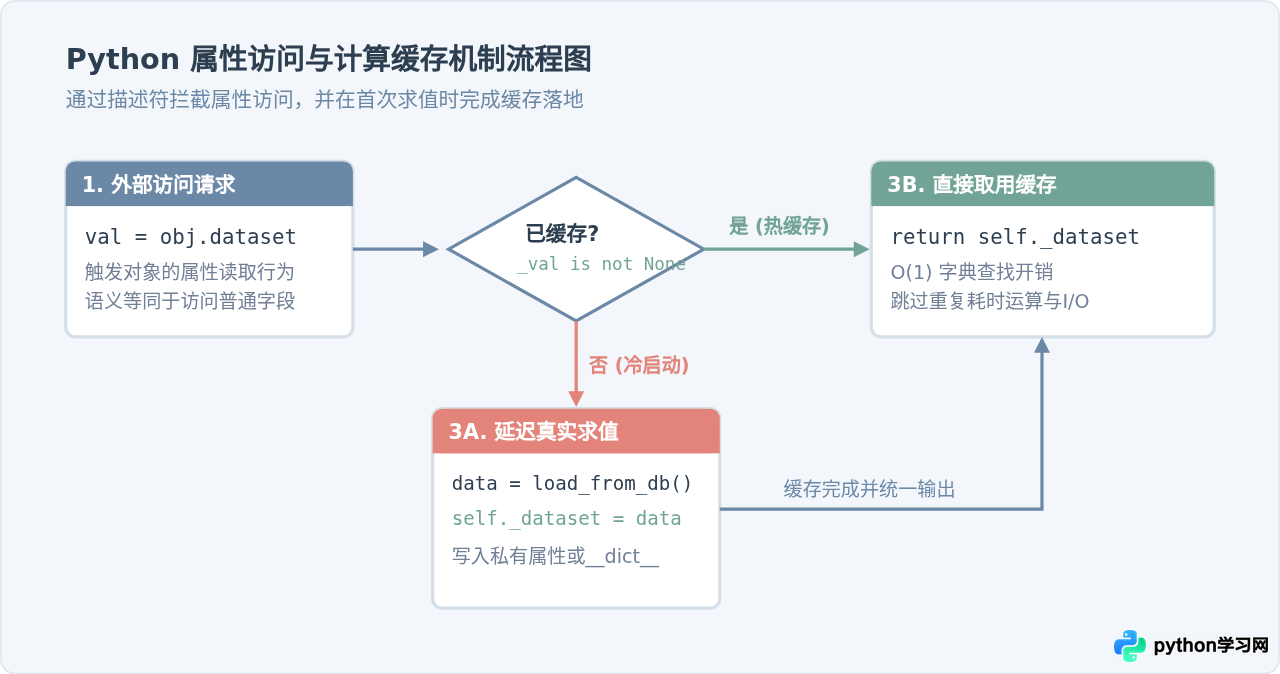
懒加载(Lazy Loading)结合计算属性缓存恰好解决了这一矛盾:它允许我们将属性的计算延迟到“首次被读取的瞬间”,并在计算完成后将结果持久存储在实例的私有状态中。后续所有访问都直接从内存缓存中取值,像访问普通实例变量一样轻快,同时保留了属性访问的语义简洁性。
二、基础实现:使用 @property 搭配私有变量
Python 内置的 @property 可以将类中的方法包装成可以通过类似属性直接访问的接口。结合私有属性(通常以单下划线 _ 开头),我们可以在该方法内部手动完成“判断缓存 → 计算赋值 → 返回结果”的标准闭环。
1. 完整实现范例
下面是一个模拟分析大型语料集的典型类。数据加载操作需要模拟两秒的磁盘解析:
import time

class TextAnalyzer:
    def __init__(self, filepath: str):
        self.filepath = filepath
        # 将缓存变量初始置为 None
        self._word_frequencies = None

    @property
    def word_frequencies(self) -> dict:
        """
        利用 @property 实现的懒加载计算属性。
        只有在首次调用 obj.word_frequencies 时才会执行加载。
        """
        if self._word_frequencies is None:
            print(f"[首次计算] 正在解析文件: {self.filepath} ...")
            # 模拟高耗时文件读取或分词计算
            time.sleep(1.0)
            # 计算完成,写入私有字段进行持久化缓存
            self._word_frequencies = {"python": 128, "property": 64, "cache": 32}
        else:
            print("[命中缓存] 直接读取内存中已有的分析结果")

        return self._word_frequencies
2. 执行效果验证
# 实例化阶段:瞬间完成,不产生任何耗时 I/O
analyzer = TextAnalyzer("dataset.txt")
print("对象已成功实例化")

# 首次访问属性:触发延迟计算
data1 = analyzer.word_frequencies
# 终端输出:
# [首次计算] 正在解析文件: dataset.txt ...

# 再次访问属性:立刻返回缓存,耗时为 0
data2 = analyzer.word_frequencies
# 终端输出:
# [命中缓存] 直接读取内存中已有的分析结果

assert data1 is data2 # 验证两者内存地址完全一致如果计算属性的有效结果恰好本身就可以是 None,使用 if self._value is None: 就会导致每次访问都判定为未缓存而重复计算。此时应使用一个唯一的哨兵对象(如 _UNSET = object())作为初始标记,通过 if self._value is _UNSET: 来确保判断的严谨性。
三、标准库解法:functools.cached_property 的机制与优势
在 Python 3.8 之后,标准库 functools 正式引入了 @cached_property 装饰器。它的设计极为优雅,不仅省去了手动维护私有下划线变量的样板代码,其底层原理更是充分利用了 Python 的描述符协议(Descriptor Protocol)与非数据描述符(Non-data Descriptor)特性。
1. 标准用法
from functools import cached_property
import time

class SensorStation:
    def __init__(self, station_id: str):
        self.station_id = station_id

    @cached_property
    def calibration_matrix(self):
        """仅在首次访问时执行,之后结果直接落入实例的 __dict__ 中"""
        print(f"-> 正在从云端调取传感器 {self.station_id} 的标定矩阵...")
        time.sleep(0.5)
        return [[1.0, 0.05], [0.02, 0.98]]
2. 底层运行原理深度拆解
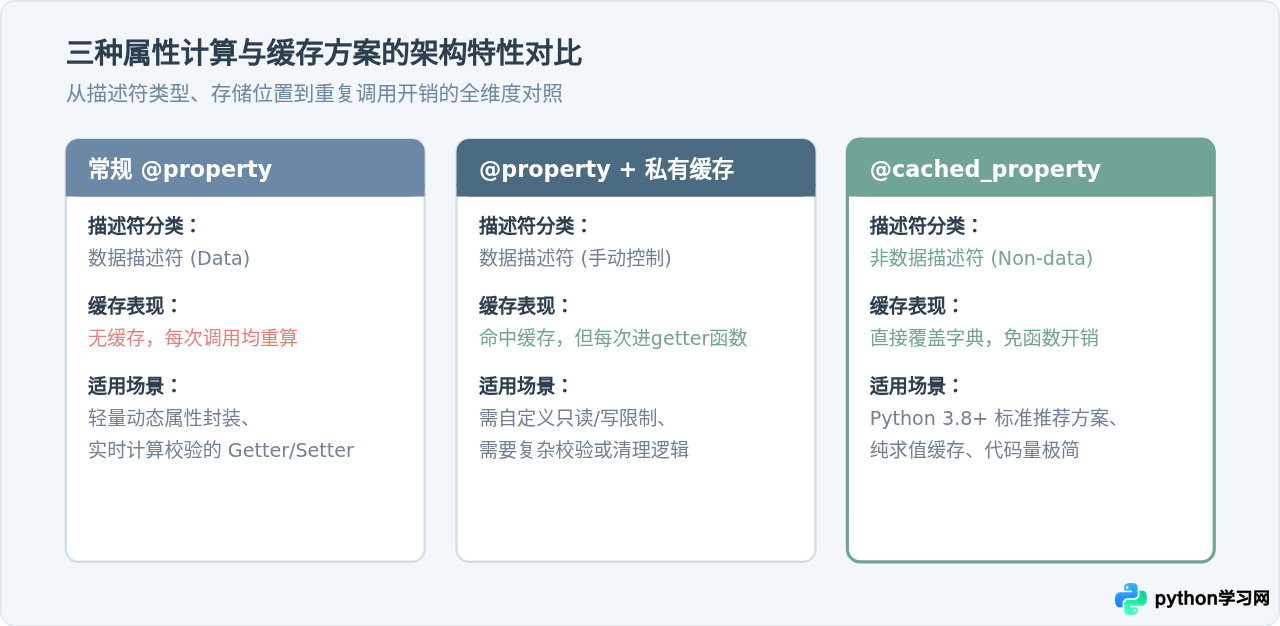
许多开发者感到好奇:@cached_property 是如何在后续调用中完全跳过方法调用的?这要归功于 Python 对象属性查找的优先级规则:
@property实现了__set__方法,属于数据描述符(Data Descriptor)。Python 在查找属性时,数据描述符的优先级高于实例的__dict__,因此每次访问obj.prop都会强行执行 getter 函数。- 而
@cached_property仅实现了__get__方法,属于非数据描述符(Non-data Descriptor)。 - 首次调用时,实例字典
obj.__dict__中还没有该属性名,Python 顺着类找到非数据描述符,执行其__get__方法。该方法计算出结果后,直接执行obj.__dict__[name] = result。 - 当下一次再访问
obj.calibration_matrix时,由于实例的__dict__的查找优先级高于非数据描述符,Python 直接从实例字典中取出值返回,完全不再经过描述符本身!
四、缓存失效与主动刷新的实现技巧
在实际工程中,数据不是一成不变的。当底层依赖的基础数据被修改时,原本缓存的计算属性必须能够被主动清除或重置,否则将产生“脏读”。
1. 如何清空 @cached_property 的缓存
由于 @cached_property 是直接将计算结果存入实例的 __dict__ 中,因此清除缓存极其直接——只需使用标准 del 关键字删除实例字典中对应的同名键:
station = SensorStation("ST-001")
_ = station.calibration_matrix  # 触发首次计算

# 当传感器重新校准后,主动清除缓存:
del station.calibration_matrix

# 下一次读取将重新触发计算
_ = station.calibration_matrix
2. 使用自定义 deleter 提供更优雅的重置语义
如果使用手写的 @property,可以通过定义 @<property>.deleter,让属性清除与重置逻辑对外表现得更加自然:
class UserReport:
    def __init__(self, user_id: int):
        self.user_id = user_id
        self._score = None

    @property
    def score(self):
        if self._score is None:
            print("-> 正在重新统计用户综合积分...")
            self._score = self._compute_complex_score()
        return self._score

    @score.deleter
    def score(self):
        """当调用 del report.score 时执行"""
        print("[重置] 用户积分缓存已清空")
        self._score = None

    def _compute_complex_score(self):
        return 98.5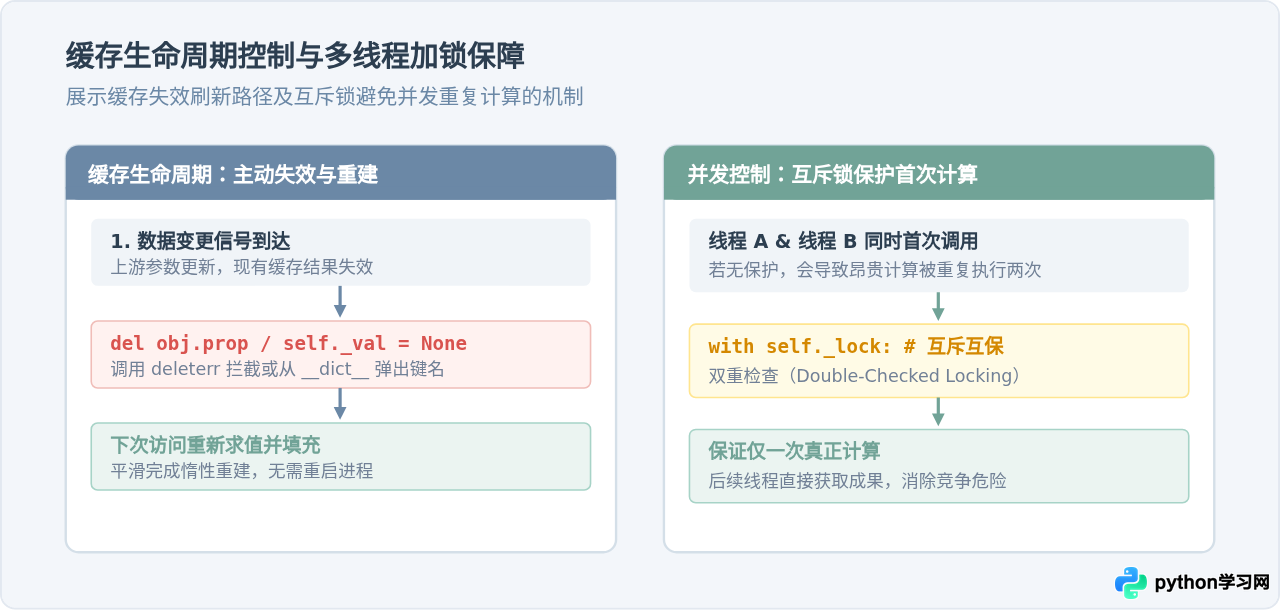
五、工程实践中的注意事项与常见陷阱
1. 多线程并发安全性
不管是自写的 @property 还是标准库的 @cached_property,其默认实现都不是线程安全(Thread-safe)的。
在多线程并发环境下,若多个线程恰好同时首次访问该属性,它们都会判定缓存尚未生成,从而同时进入计算逻辑。对于普通内存计算而言可能只是轻微算力浪费,但若该计算包含数据库写入、临时文件创建或网络订单生成,重复执行就会造成严重副作用。
如需在多线程环境下提供坚固保障,推荐配合 threading.Lock 进行双重检查锁定(Double-Checked Locking):
import threading

class SafeDataFetcher:
    def __init__(self):
        self._cache = None
        self._lock = threading.Lock()

    @property
    def data(self):
        # 第一次检查(无锁,保证高性能)
        if self._cache is None:
            with self._lock:
                # 第二次检查(持有锁,防止并发重复执行)
                if self._cache is None:
                    self._cache = self._fetch_heavy_data()
        return self._cache

    def _fetch_heavy_data(self):
        return {"status": "ok", "timestamp": 1729640000}
2. 与 __slots__ 的兼容性限制
为了优化内存占用,很多高频对象会声明 __slots__。但是:
functools.cached_property依赖将计算结果写入实例的__dict__。如果一个类声明了__slots__且没有把'__dict__'包含在 slots 列表中,访问@cached_property会直接抛出TypeError: No '__dict__' in 'MyClass' instance。- 如果必须同时使用
__slots__,请改用手写的@property并在__slots__中显式声明用于缓存的私有变量名(如__slots__ = ('filepath', '_word_frequencies'))。
3. 避免在不可变对象(Frozen Dataclass)中使用
在 Python 的 @dataclass(frozen=True) 中,实例被标记为只读不可变,尝试向其 __dict__ 或属性赋值会引发 FrozenInstanceError。对于不可变数据结构,应在初始化前计算完毕,或使用专门的只读缓存机制。
六、方案选型与总结
在实际项目开发中,选择哪种计算属性方案应当根据具体的语言版本、并发要求以及对缓存刷新的灵活性诉求来决策:
| 需求场景 | 推荐方案 | 核心优势 |
|---|---|---|
| Python 3.8+ 且只读、求值无副作用 | @functools.cached_property |
代码最简洁,标准库原生支持,零多余函数调用开销。 |
| 需要精细控制只读权限、校验或自定义 setter/deleter | @property + 私有变量 |
灵活性最高,支持封装复杂的失效与重置业务逻辑。 |
| 多线程高并发且计算带有外部副作用 | @property + threading.Lock 双重检查 |
彻底消除竞态条件,保证计算过程的幂等性与唯一性。 |
使用了 __slots__ 进行极限内存优化 |
@property + slots 预留私有字段 |
完全避开对实例 __dict__ 的硬性依赖。 |
综上所述,利用 @property 实现懒加载与缓存是 Python 面向对象设计中的经典技巧。合理运用这一模式,既能保持简洁统一的属性访问风格,又能将昂贵计算推迟到真正需要的时机,从而显著提升系统的响应速度与资源利用效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















