


Python字符串格式化:format方法与f-string怎么选?
str.format()。
一、核心机制与语法差异:为什么两者有本质不同?
Python 2.6 时代引入了 str.format() 方法,旨在取代老旧的 % 操作符。它通过普通字符串调用方法的形式工作,占位符使用大括号 {} 标识。而在 Python 3.6 发布的 PEP 498 中,官方正式引入了格式化字符串字面量(Formatted String Literals),即 f-string。
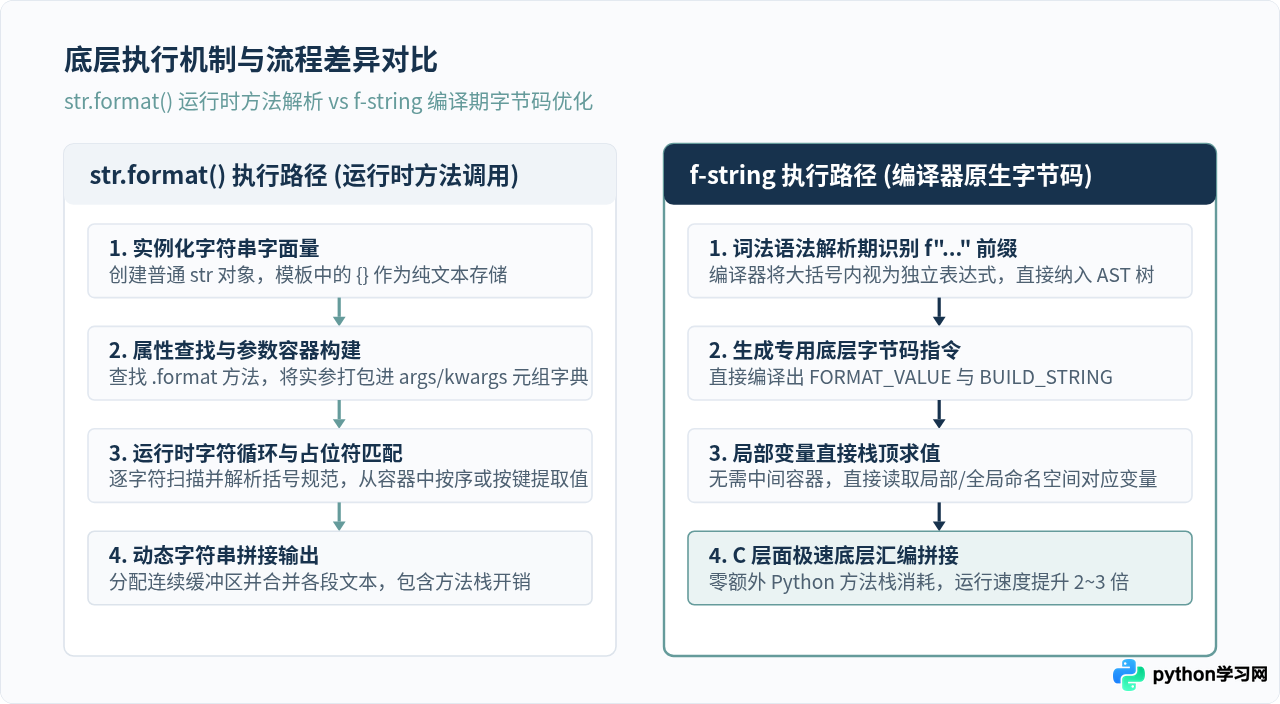
表面上看,两者只是书写格式的细微差别,但底层执行路径却截然不同:str.format() 是标准的对象方法调用,在代码运行到该行时执行函数调用流程;而 f-string 是 Python 词法与语法分析器在编译期直接识别的原生语言构件,它会被编译器直接翻译为专有的字节码指令。
通过下方典型的语法示例,可以直观观察两者在普通变量注入、计算表达式与格式控制上的语法差异:
# 示例变量
name = "Alice"
score = 92.456
items = ["Python", "Rust"]

# 1. str.format() 语法方式
msg_format = "学员 {} 的得分是 {:.1f},正在学习 {}".format(name, score, items[0])
# 支持位置索引或关键字映射
msg_format_kw = "学员 {n} 的得分是 {s:.1f}".format(n=name, s=score)

# 2. f-string 语法方式(直接在花括号内书写变量与表达式)
msg_fstring = f"学员 {name} 的得分是 {score:.1f},正在学习 {items[0]}"
# 花括号内支持直接执行 Python 合法表达式
msg_calc = f"下学期目标分数:{score + 5:.1f}"

# 示例输出(两者结果完全相同):
# 学员 Alice 的得分是 92.5,正在学习 Python
二、四大维度的技术选型深度剖析
为了在实际开发中做出最合理的技术决策,我们需要从可读性、运行性能、动态模板能力和调试安全性四个关键维度进行横向权衡。
1. 可读性与心智负担:视觉流向决定了维护效率
阅读代码时,程序员的视线是单向流动的。在 str.format() 中,当模板较长或者参数较多时,视线必须在前端的 {0}、{1} 与后端的实参列表之间来回跳跃扫描。一旦后续重构增减了参数,极易发生“索引错位”或“命名疏漏”引发的 IndexError 或 KeyError。
而 f-string 采用“就地填充”(In-place Interpolation)设计,变量与表达式就写在最终呈现的位置。阅读代码时一气呵成,完全消除了前后匹配的心智负担,重构与审查代码时更不容易遗漏。
2. 运行性能:C 语言级别的字节码指令优势
我们通过 Python 的 dis 模块反编译两者的底层字节码,即可发现性能差距的根源:
import dis

def run_format(name, score):
    return "User: {}, Score: {}".format(name, score)

def run_fstring(name, score):
    return f"User: {name}, Score: {score}"

# 观察字节码差异:
# run_format 包含 LOAD_ATTR (查找 format 方法), CALL_FUNCTION (函数调用帧开销)
# run_fstring 仅包含 FORMAT_VALUE 与 BUILD_STRING 指令,直接在当前虚拟机栈中完成组装
在大规模高并发数据处理、日志序列化或循环迭代(例如几万次数据拼接)的场景中,f-string 的执行耗时通常仅为 str.format() 的 35% ~ 50%,能够带来立竿见影的性能提升。
3. 动态模板与延迟求值:str.format() 的核心不可替代场景
技术选型不能一刀切。f-string 存在一个本质特性:定义即求值。Python 在解释到 f"..." 这一行代码时,就会立刻读取当前作用域中的变量并算出结果。这意味着,它无法用于“先定义模板、稍后再填充数据”的场景。
如果你的系统需要从外部 YAML/JSON 配置文件读取消息模板、实现国际化(i18n)多语言翻译文本,或者处理来自数据库的动态提示词模板,str.format() 是天然的解耦工具:
# 场景:从外部配置或数据字典中加载模板(无法使用 f-string)
# 模板字符串可能在模块初始化时加载,此时尚未产生具体的上下文数据
welcome_template = "尊敬的 {username},您的订单 {order_id} 已于 {delivery_time} 出库!"

# 业务运行到支付交付阶段,才动态注入具体数据
user_data = {
    "username": "张三",
    "order_id": "SN-20261024-9981",
    "delivery_time": "14:30"
}

# 使用字典解包动态填充
final_msg = welcome_template.format(**user_data)
# 示例输出:尊敬的 张三,您的订单 SN-20261024-9981 已于 14:30 出库!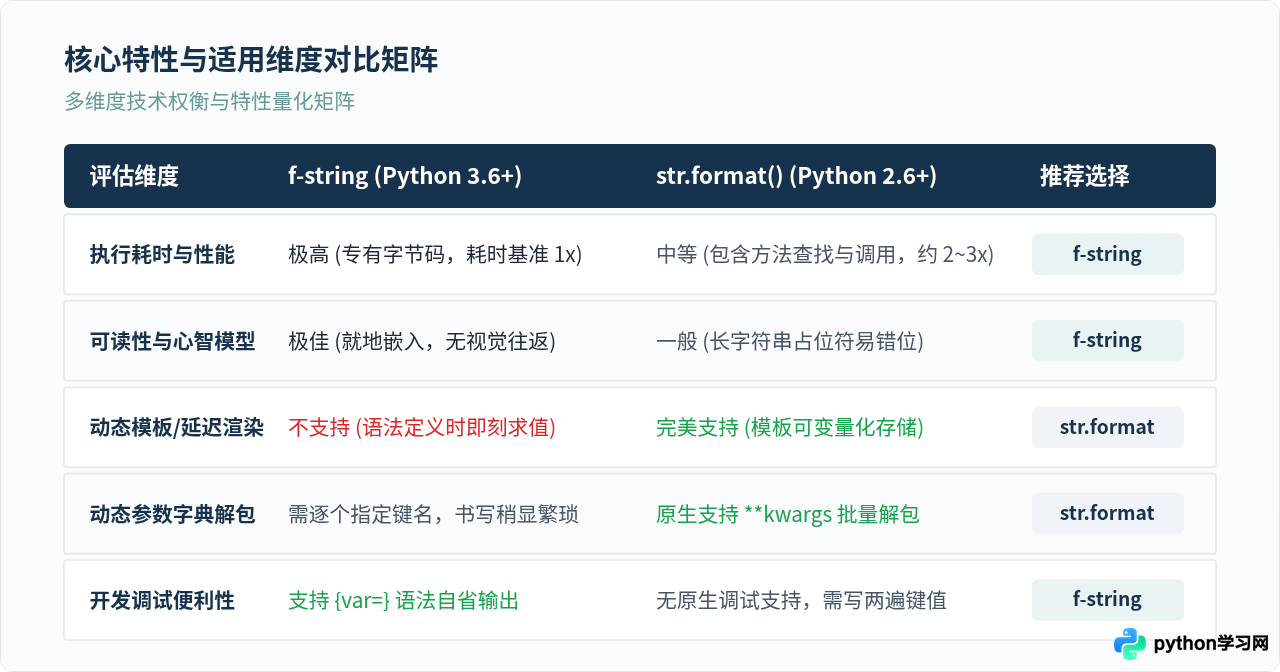
三、选型决策路径:面对具体场景如何做决定?
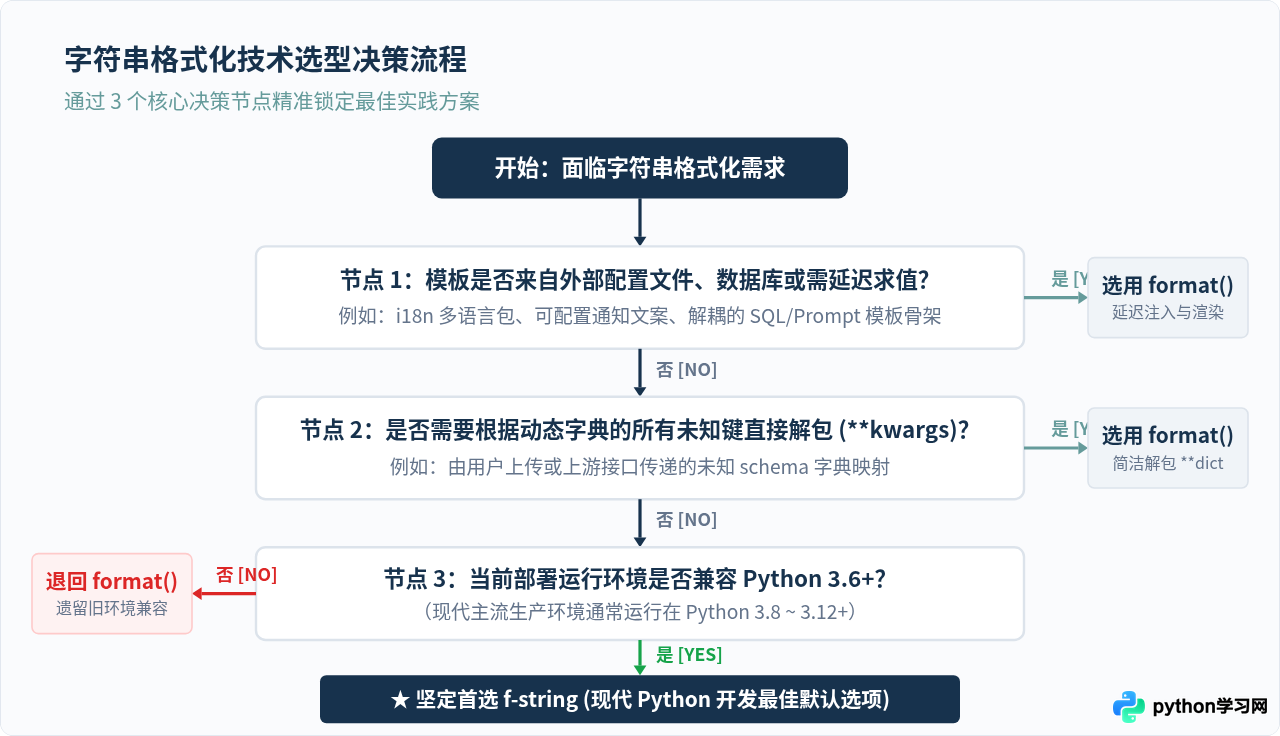
在团队开发与日常编码中,为了避免开发者在不同格式化语法间犹豫不决,可以遵循以下标准化的决策流程:
四、常见陷阱、格式化微语法与工程避坑
即便确定了选型,在日常使用这两者时仍有一些容易踩坑的语法细节和安全隐患需要留意。
1. 大括号字面量转义规则
无论是在 f-string 还是在 str.format() 中,大括号都是保留的标记字符。如果你生成的字符串本身包含大括号(例如输出 JSON 字符串、正则表达式或 CSS 代码),需要双写大括号进行转义:
status = 200
msg = "OK"

# 错误写法(会抛出 SyntaxError 或 KeyError):
# text = f"{"status": status}"

# 正确写法:使用 {{ 与 }} 表达字面量大括号
json_text = f'{{"code": {status}, "message": "{msg}"}}'
# 输出示例:{"code": 200, "message": "OK"}
2. f-string 的常用格式化说明符速查
f-string 完整继承并增强了 Python 的格式化说明符规范(在变量名后使用冒号 : 引导)。掌握这些速查技巧可以大幅精简格式化代码:
val = 12.3456
num = 42

# 1. 浮点数保留精度:{val:.2f} -> 12.35
print(f"精度截断:{val:.2f}")

# 2. 数字补零对齐:{num:05d} -> 00042
print(f"编号生成:{num:05d}")

# 3. 文本居中与填充:{name:^10}
name = "KuAi"
print(f"对齐显示:[{name:^10}]") # [   KuAi   ]

# 4. 千分位逗号分隔符:{amount:,} -> 1,234,567,890
amount = 1234567890
print(f"财务金额:¥{amount:,}")

# 5. Python 3.8+ 调试神器(添加等号同时打印变量名与值):
debug_count = 100
print(f"{debug_count=}") # 输出:debug_count=100
3. 安全性陷阱:不要直接使用 format 渲染不可信的用户输入
str.format() 拥有极其强大的属性访问能力(例如 {0.__class__})。如果在 Web 后端中将未经严格过滤的外部用户输入直接作为模板传给 .format(),攻击者可能通过属性链路遍历 Python 运行时的全局对象甚至触发代码执行漏洞。对于不可信的动态输入模板,推荐使用 string.Template(仅支持 $ 占位符且无法访问对象内部属性)作为安全替代。
五、总结:一句话记住选型口诀
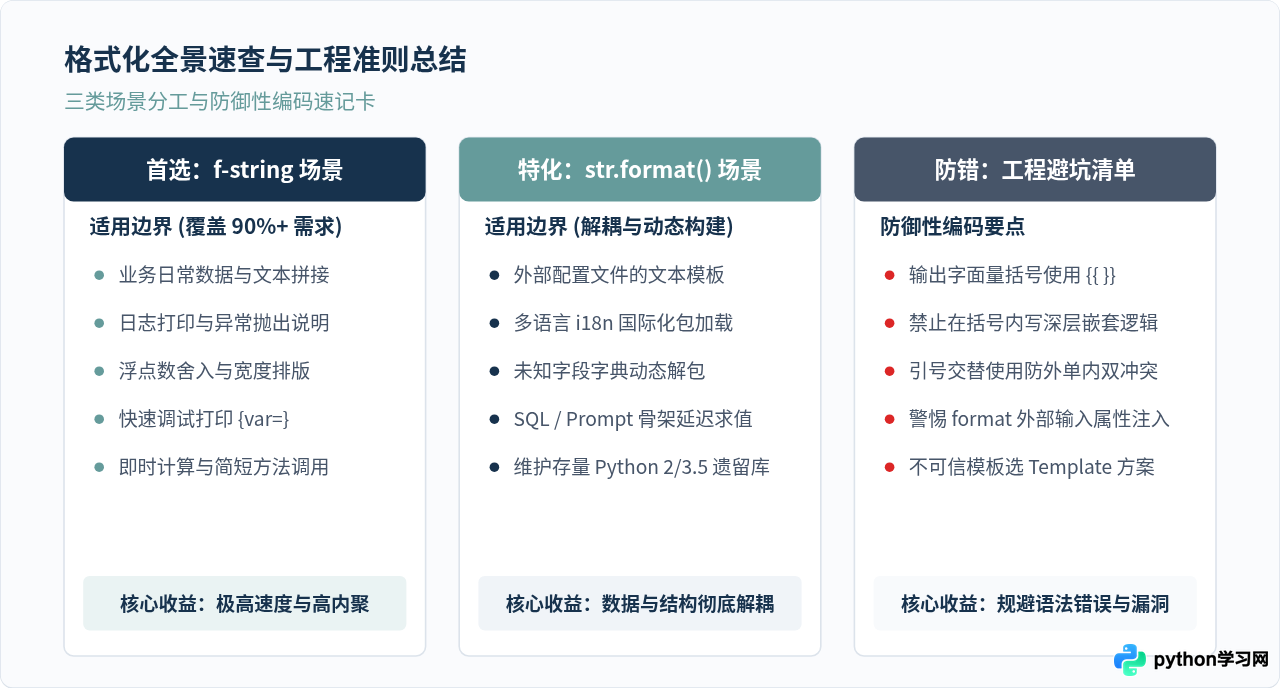
面对“format 方法与 f-string 怎么选”的问题,工程落地的最佳实践其实非常明确:
- 绝大多数情况:坚定采用
f-string。它具有不可比拟的执行性能(编译期原生字节码)与绝佳的可读性,是现代 Python 代码库的通用标准。 - 动态解耦场景:果断使用
str.format()。当模板需要跨文件传递、从配置文件加载、动态字典批量解包或延迟求值时,format方法依然是标准库中最稳健的工具。
牢记口诀:“即时拼接用 f-string,外部模板找 format”。结合本文提供的决策流程与防错清单,在日常编码与架构设计中便能自如取舍,写出兼具可读性与高运行效率的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















