


Python中%格式化、format()与f-string该怎么选?

在 Python 开发中,字符串拼接与动态插值是最常见的操作之一。从最早由 C 语言沿袭而来的 % 格式化,到 Python 2.6/3.0 引入的 str.format() 方法,再到 Python 3.6 推出的 f-string(字面量格式化字符串),Python 经历过三次重大语法迭代。面对这三种方式,核心选型策略可以概括为一句话:在 Python 3.6 及更新环境中,所有常规业务逻辑、计算插值与调试输出,无脑首选 f-string;日志打印场景保留标准 logging 的 % 占位延迟格式化;接收外部未知模板内容时改用安全的映射方式。
一、三种格式化机制的演进历程与底层工作原理
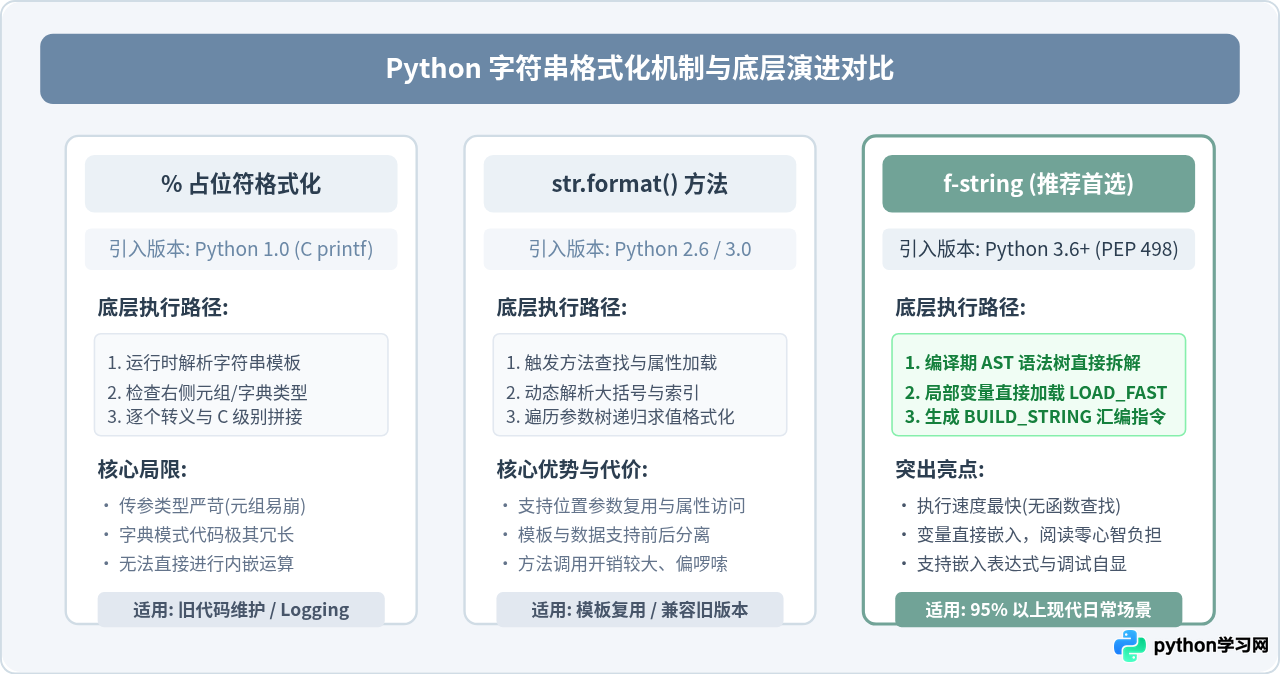
要做出合理的选择,首先需要理解这三种语法在底层解析机制上的根本差异。它们不仅是语法的简化,更代表了解释器执行效率和编译期优化的演变过程。
1. %-formatting(printf 风格)的语法与隐患
% 格式化完全借鉴了 C 语言的 printf 风格。它的书写直观,但其语法设计存在两个先天缺陷:
- 单值与元组的二义性:右侧操作数如果是单一变量,当该变量在运行期意外变成元组(tuple)时,解释器会将其误认为多个参数的容器,导致抛出
TypeError: not all arguments converted during string formatting。 - 字典模式啰嗦易错:通过
%(key)s传字典虽可解决位置问题,但键名需要重复书写,极大降低了阅读效率。
# 基础用法
name = "Alice"
score = 95.5
text = "学员: %s, 得分: %.1f" % (name, score)

# 单变量元组引发的经典陷阱示例
user_data = ("admin", 1)
# 下行会报错:TypeError: not all arguments converted during string formatting
# msg = "用户数据为: %s" % user_data
# 正确写法必须手动外包一层单元素元组:
msg = "用户数据为: %s" % (user_data,)
2. str.format() 的灵活性与规范化
为了摆脱 % 对元组的强依赖并提供更强的拓展能力,Python 引入了 str.format()。它将占位符统一改为花括号 {},支持按位置索引(如 {0}、{1})重复引用变量,支持通过 .属性 或 [索引] 直接访问成员,还能利用 **kwargs 解包字典。此外,它建立了统一的微语法(Format Specification Mini-Language),确立了对齐、补零、浮点控制等通用规范。
# 位置参数复用与属性读取
user = {"name": "Bob", "role": "Developer"}
msg = "{0[name]} 的角色是 {0[role]},再次确认姓名: {0[name]}".format(user)

# 动态解包字典
point = {"x": 10, "y": 20}
coords = "坐标为: X={x}, Y={y}".format(**point)
3. f-string(字面量插值)的彻底革新
从 Python 3.6 开始,PEP 498 引入了 f-string。它不仅仅是一个新函数或语法糖,而是由词法分析器和解析器在编译期直接处理的表达式。当解释器遇到以 f 或 F 开头的字符串时,它会把花括号内部的内容解析为实际的 Python 表达式节点,并在字节码层面转换为快速构建指令。这彻底消除了函数调用开销与参数查找步骤。
二、核心维度对比:为什么 f-string 成为了绝对主流?
在性能、代码可读性和功能丰富度三个维度上,f-string 都展现出了压倒性的优势。
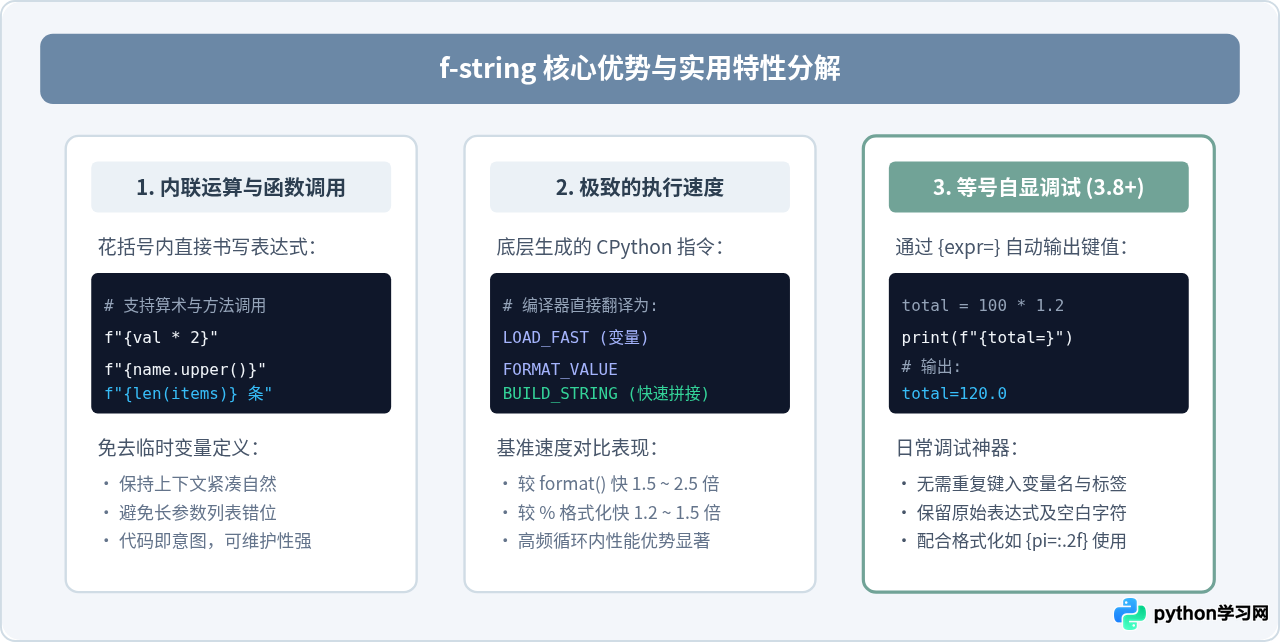
实测微基准参考(以百万次单变量格式化为例):
在 Python 3.11 官方解释器下进行标准基准测试:str.format() 耗时约 75ms,% 格式化耗时约 52ms,而 f-string 仅耗时约 31ms。由于 f-string 将变量直接在当前帧栈中以字节码提取,避开了字典加载和函数入栈出栈,在大规模循环渲染中具有实质性的性能红利。
三、什么时候不能(或不应该)使用 f-string?
虽然 f-string 是通用场景的最优解,但在特定工程需求下盲目替换会导致性能回退甚至安全风险。读者需要特别注意以下两个例外场景:
1. 日志记录场景(标准库 logging)
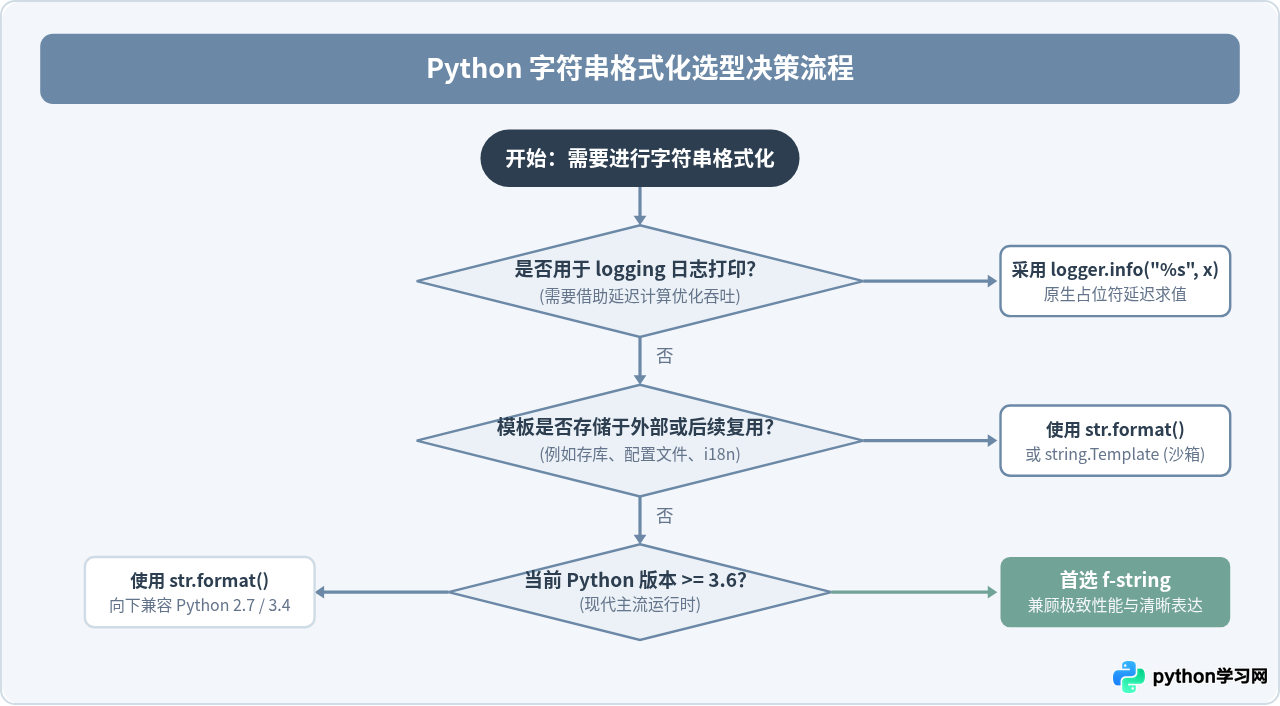
很多开发者习惯在日志中写 logger.info(f"User {uid} pay {amount}"),这在生产环境中是一个典型反模式。原因在于:f-string 会在执行到该行时立即计算并拼接字符串。如果当前环境设置的日志级别为 WARNING,该条 INFO 日志实际上并不会被记录,但 f-string 内部昂贵的字符串格式化计算已经白白消耗了 CPU 资源。
import logging
logger = logging.getLogger(__name__)

# 不推荐写法:哪怕日志级别不满足,f-string 也会立即完成插值计算
logger.debug(f"计算密集型数据: {compute_heavy_payload(user_id)}")

# 推荐写法:使用 logging 模块原生的 % 风格传参,实现延迟计算(Lazy Evaluation)
# 只有当日志级别满足时,logging 内部才会执行真正的字符串格式化
logger.debug("计算密集型数据: %s", compute_heavy_payload(user_id))
2. 模板持久化与不可信用户输入
由于 f-string 必须在定义时与当前运行时的局部变量环境紧密绑定,因此它无法将未填充的模板保存至数据库、配置文件或国际化(i18n)PO 文件中供后续加载。如果需要保存外部模板,str.format() 能够实现“先定义模板、后传入参数”的解耦。
安全防范提示:如果模板内容直接来自未经受信任的外部用户提交,绝不能随意对其调用 str.format(**input_dict),因为攻击者可以通过 {user.__init__.__globals__} 等反射链条窥探进程命名空间中的敏感凭证。面对用户自定义配置模板,标准库的 string.Template 是更加安全的沙箱替代方案。
四、清晰实用的选型决策流程
面对具体业务时,开发者只需按照如下标准流程进行判定,即可选出最适合的技术方案。
五、常用格式化需求对照与避坑要点
无论是 str.format() 还是 f-string,都共享同一套格式规范说明符(Format Specifier)。以下整理了开发中最常见的数字修饰、填充对齐与日期格式化的高频写法:
| 目标场景 | % 语法(旧) | str.format() 语法 | f-string 语法(现代推荐) | 输出示例 |
|---|---|---|---|---|
| 保留两位浮点小数 | "%.2f" % val |
"{:.2f}".format(val) |
f"{val:.2f}" |
3.14 |
| 整数前置补零 (4位) | "%04d" % num |
"{:04d}".format(num) |
f"{num:04d}" |
0042 |
| 千分位分隔符 | 不支持原生写法 | "{:,}".format(num) |
f"{num:,}" |
1,234,567 |
| 百分比转换 | "%.1f%%" % (r*100) |
"{:.1%}".format(r) |
f"{r:.1%}" |
85.6% |
| 字符串居中对齐 | 不支持居中 | "{:^10}".format(s) |
f"{s:^10}" |
test |
| 打印自身花括号 | "%%" 转义百分号 |
"{{}}".format() 双括号 |
f"{{{val}}}" 双括号转义 |
{42} |
常见细节避坑清单
- 花括号转义:在 f-string 中,如果需要输出字面量的大括号字符
{或},需要使用连续的双大括号{{和}}进行转义。 - 引号嵌套规则:在 Python 3.12 之前,f-string 内部表达式使用的引号不能与外部定界引号相同;从 Python 3.12(PEP 701)开始,这一限制已被彻底解除,允许在表达式内自由嵌套相同引号与换行反斜杠。
- 避免在 f-string 中内嵌过长复杂的业务逻辑:虽然语法允许
f"{','.join([str(x) for x in get_items() if x > 0])}"这样书写,但会极大破坏代码的可读性。对于复杂运算,应当先在上方赋值给明确的语义化变量,再代入 f-string 中。
六、技术方案速查与综合总结
为了让团队规范和技术评审有章可循,下面给出了四种技术方案的综合横向速查矩阵:
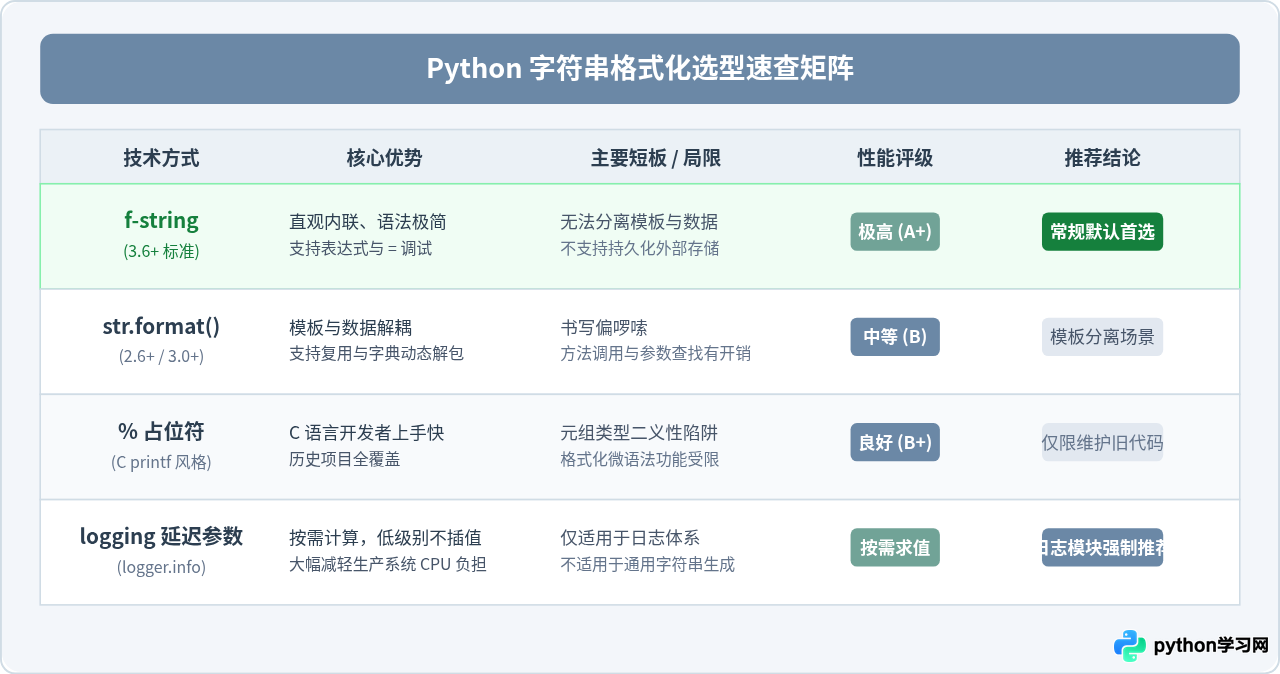
总而言之,在当今 Python 3.8+ 已经全面普及的环境下,不需要在 %、format() 与 f-string 之间犹疑不决。将 f-string 作为肌肉记忆中的第一选择,不仅能让代码更短、执行更快,还能让后期的维护和阅读变得轻松清晰;同时在 日志输出 和 动态外部模板 场景中守住边界,便能写出既地道又健壮的现代 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















