


Python f-string、format()与%格式化输出对比

% 格式化操作符、Python 2.6 引入的 str.format() 方法,以及 Python 3.6 推出的 f-string(格式化字符串字面值)。对于现代 Python 开发,常规业务代码中首选 f-string,兼具最优的可读性与最快的运行速度;处理非硬编码的外部动态模板时,str.format() 是标准解决方案;而 % 语法主要作为兼容机制存在,除 logging 模块特定延迟求值场景外,新代码中已不再推荐使用。
一、三种格式化方式的演进与语法结构
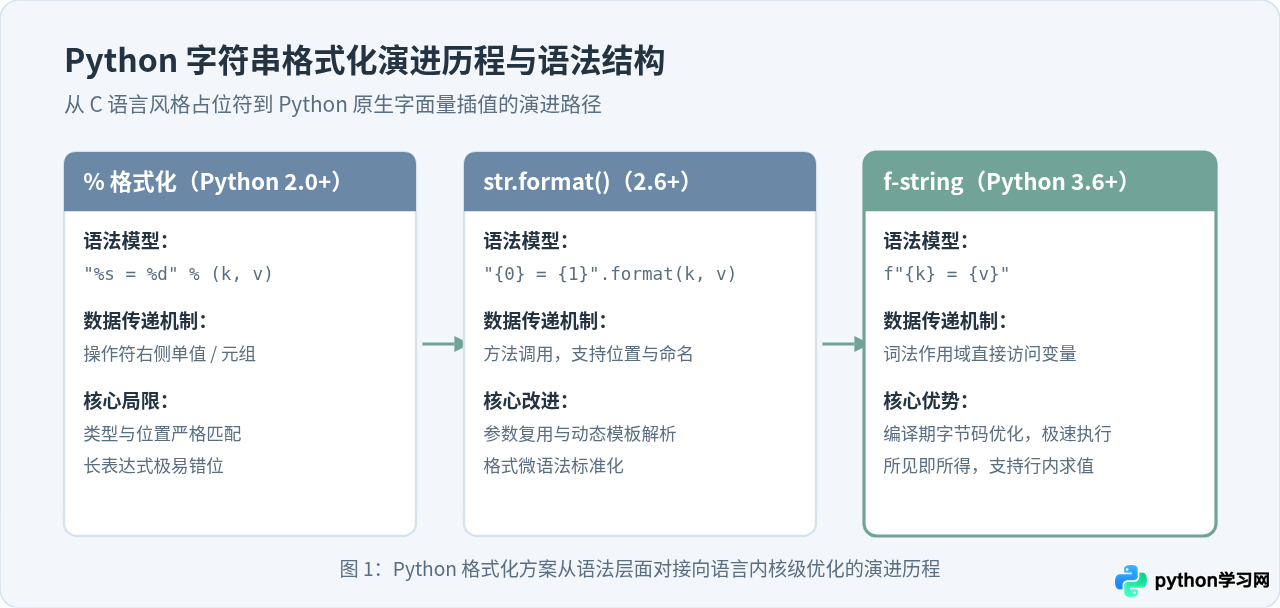
Python 字符串格式化的演变过程,本质上是开发团队在“可读性”、“运行性能”和“动态表达力”之间不断寻求更优解的过程。三种语法在声明形式和参数传递上存在明显差异。
1. % 操作符(printf 风格)
% 操作符是 Python 最早期的格式化方案,沿袭了 C 语言中 printf 函数的占位符思想。它通过在字符串内部嵌入 %s、%d、%f 等格式说明符,并在字符串后跟随 % 操作符及待插入的数据。
name = "Alice"
score = 95.5
message = "学生: %s, 成绩: %.1f" % (name, score)
print(message)
当参数只有单个变量时可以直接传值,但多个变量时必须显式打包为元组。这种语法的核心问题在于:当参数较多时,模板字符串与末尾的元组距离较远,阅读时需要反复比对占位符顺序;如果传参遗漏或元组元素顺序错位,极易引发 TypeError。
2. str.format() 方法
为了解决 % 语法在长参数场景下难以维护的问题,Python 2.6 和 3.0 引入了 str.format() 方法。它使用花括号 {} 作为占位符,支持按位置索引、参数名称以及属性查找传递数据。
name = "Bob"
item = "笔记本"
# 支持位置索引与命名参数
text_pos = "用户 {0} 购买了 {1},请确认 {0} 的收货地址。".format(name, item)
text_kw = "用户 {n} 购买了 {i}。".format(n=name, i=item)
print(text_pos)
print(text_kw)用户 Bob 购买了 笔记本,请确认 Bob 的收货地址。
用户 Bob 购买了 笔记本。
str.format() 摆脱了 C 风格类型字符的繁琐约束,支持同一个参数在字符串中多次复用,并建立了一套灵活的“格式规范迷你语言”(Format Specification Mini-Language)。
3. f-string(格式化字符串字面值)
Python 3.6(PEP 498)引入了 f-string。只需在字符串前缀加上 f 或 F,花括号内部就可以直接填入当前作用域中生效的变量名甚至任意合法的 Python 表达式。
user = "Charlie"
points = 120
notice = f"欢迎用户 {user},您当前的加权积分为 {points * 1.5:.1f}。"
print(notice)
f-string 将数据的引用直接内嵌在排版文本中,消除了“模板”与“数据源”的分离状态,代码逻辑一目了然。
二、核心维度深度横向对比
1. 可读性与维护成本
在涉及 3 个以上变量的拼接中,差异尤为明显。对比以下相同业务逻辑的代码:
# 1. % 操作符:变量完全脱离上下文
query_1 = "SELECT %s, %s FROM %s WHERE %s = %d AND %s = '%s';" % (c1, c2, tbl, f1, v1, f2, v2)

# 2. str.format():索引或者显式命名缓解了错位,但仍然冗长
query_2 = "SELECT {c1}, {c2} FROM {tbl} WHERE {f1} = {v1} AND {f2} = '{v2}';".format(
    c1=c1, c2=c2, tbl=tbl, f1=f1, v1=v1, f2=f2, v2=v2
)

# 3. f-string:字段直接在 SQL 骨架中原地就位
query_3 = f"SELECT {c1}, {c2} FROM {tbl} WHERE {f1} = {v1} AND {f2} = '{v2}';"
f-string 的代码长度通常比 format() 短 30% 到 50%,阅读时眼睛无需在模板和参数列表之间来回跳跃,极大降低了日常维护的心智负担。
2. 底层运行性能与字节码对比
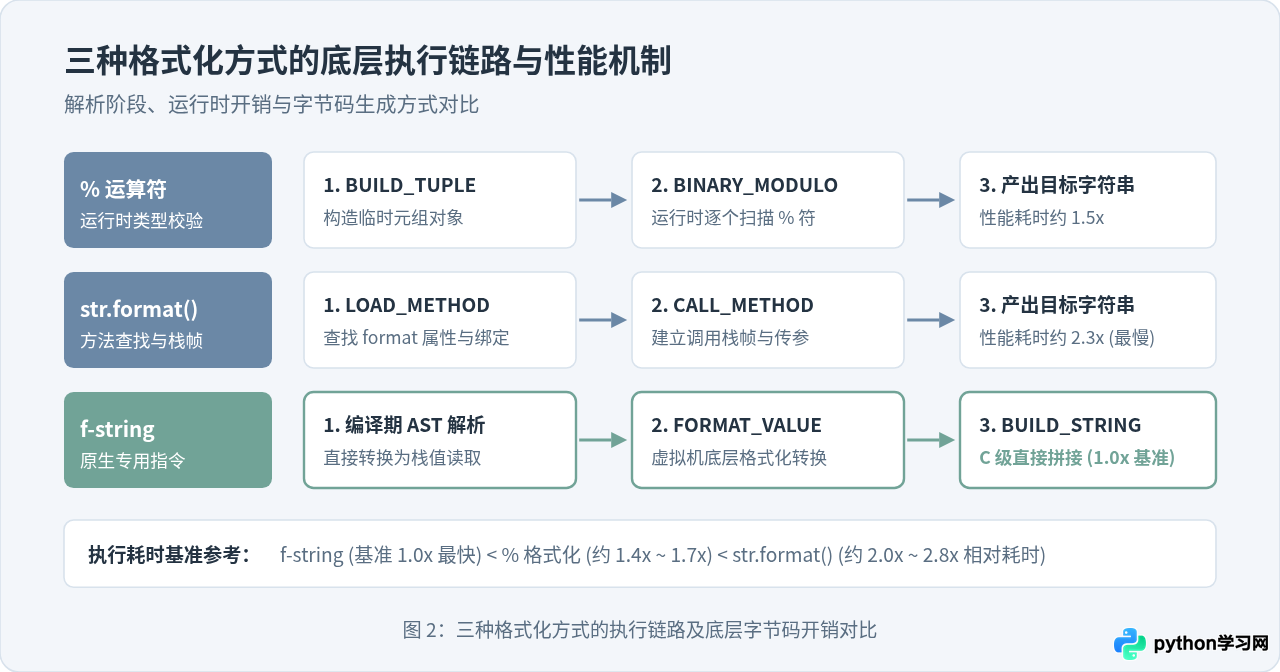
许多开发者误以为三种方式在底层原理上差不多,但通过 Python 的 dis 模块反编译字节码,可以发现本质区别:
- % 操作符:首先需要在栈上构建元组对象(执行
BUILD_TUPLE指令),然后调用底层的BINARY_MODULO操作码。这一步涉及额外的元组内存分配与类型检查。 - str.format():需要先在字符串对象上查找
format属性(LOAD_METHOD),随后发起函数调用(CALL_METHOD)。创建方法栈帧的开销使得它在三者中运行最慢。 - f-string:在语法解析(AST)阶段就被识别为格式化表达式。Python 编译器会直接为每个表达式发射
FORMAT_VALUE指令,最后由专门优化的BUILD_STRING指令在 C 层面直接将栈上的多个字符串片段快速拼合。没有任何方法调用或临时容器分配开销。
3. 表达能力与新特性
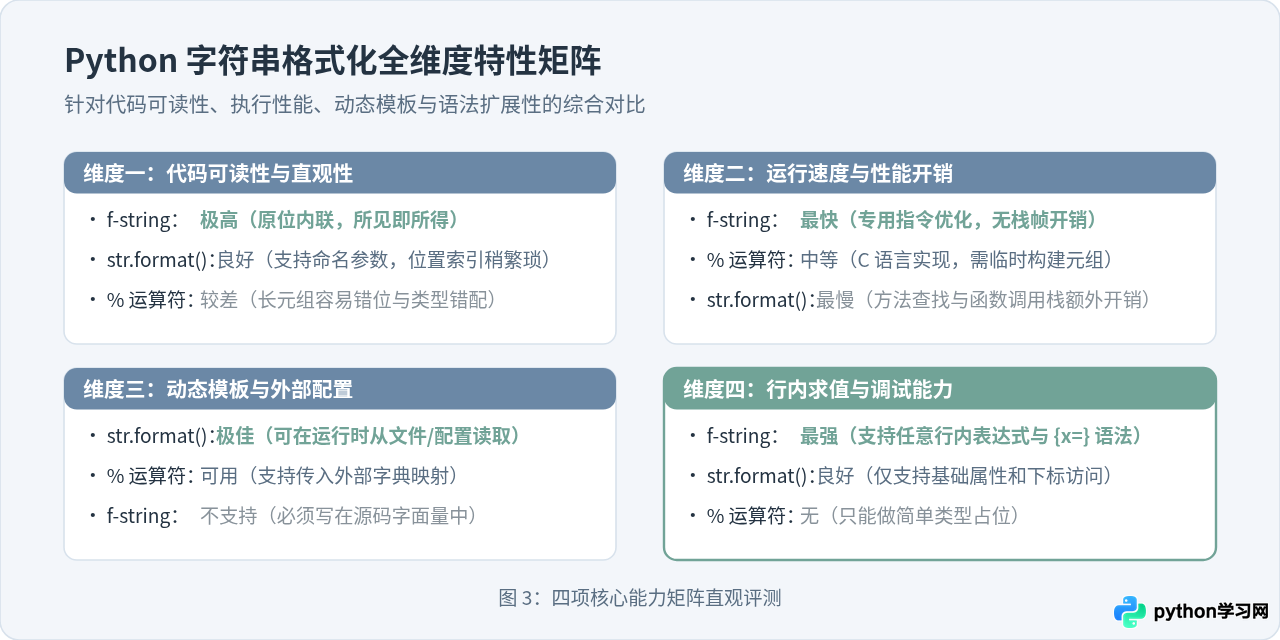
f-string 的强大之处还在于它对行内表达式的全面支持:
- 行内运算与方法调用:可以直接写
f"{name.lower():>10}"或f"{len(items) * 2}"。 - 调试输出(Python 3.8+):在变量名后添加等号
=,即可同时输出表达式本身与计算结果,例如f"{x=}"会直接输出x=10,非常便于快速调试。 - 引号与反斜杠优化(Python 3.12+):根据 PEP 701,Python 3.12 彻底移除了 f-string 内部引号不能重用的限制,甚至允许在花括号内编写反斜杠和多行注释。
4. 综合对比参数表
| 特性指标 | % 格式化 | str.format() | f-string |
|---|---|---|---|
| 引入版本 | Python 2.0 之前 | Python 2.6 / 3.0 | Python 3.6+ |
| 语法风格 | C 语言 printf 语法 | 面向对象方法调用 | 语言原生字面量插值 |
| 执行速度 | 中等(有元组打包开销) | 较慢(有方法查找与调用开销) | 最快(编译器直译字节码) |
| 支持行内表达式 | 否 | 否(仅支持属性和索引) | 是(支持任意 Python 表达式) |
| 自解释调试输出 | 不支持 | 不支持 | 支持 {var=}(3.8+) |
| 动态外部模板 | 支持(字典传参) | 原生支持且灵活性最好 | 不支持(必须是源码字面量) |
| 现代开发推荐度 | 低(仅维护或 logging) | 中(专用于外部模板) | 极高(默认首选) |
三、典型应用场景与代码实践
1. 格式规约:对齐、填充与数值精度
str.format() 和 f-string 共享同一套格式规范迷你语言,语法为 :[fill][align][sign][#][0][width][,][.precision][type],比 % 更为统一直观:
val = 42
pi = 3.1415926

# f-string 对齐与精度控制
print(f"|{val:<6}|")      # 左对齐,宽度 6 -> '|42    |'
print(f"|{val:>6}|")      # 右对齐,宽度 6 -> '|    42|'
print(f"|{val:^6}|")      # 居中对齐,宽度 6 -> '|  42  |'
print(f"|{val:*^8}|")     # 以星号填充居中 -> '|***42***|'
print(f"圆周率保留两位: {pi:.2f}")  # 保留 2 位小数 -> '3.14'
print(f"金额千分位: {1234567890:,}") # 千分位分隔 -> '1,234,567,890'|42 |
| 42|
| 42 |
|***42***|
圆周率保留两位: 3.14
金额千分位: 1,234,567,890
2. 对象属性与字典数据读取
在结构化数据渲染中,三者写法差异显著:
data = {"host": "127.0.0.1", "port": 8080}

# % 格式化需要使用字典键名映射,语法繁琐
s1 = "连接到 %(host)s:%(port)d" % data

# str.format() 允许解包字典
s2 = "连接到 {host}:{port}".format(**data)

# f-string 可直接索引字典键名
s3 = f"连接到 {data['host']}:{data['port']}"
3. logging 模块中的特殊考量
在日常业务中尽管强烈推荐 f-string,但在使用 Python 标准库 logging 记录日志时,推荐继续使用 % 占位符风格,例如 logging.info("请求处理完成: id=%s", user_id)。
原因在于惰性求值(Lazy Evaluation):如果当前配置的日志级别是 WARNING,那么 INFO 级别的日志不会被真正输出。若使用 f-string,字符串拼接在传入函数前就已经完成了计算;而使用 logger.info("...", arg),拼接操作只在日志级别被激活时才会在 logging 内部执行,从而避免不必要的 CPU 和内存损耗。
四、常见陷阱与避坑指南
- 花括号本身的转义:在
str.format()和f-string中,若想输出字面量的大括号,必须使用双括号转义。例如f"{{'status': {val}}}"最终输出为{'status': 42}。 - 引号嵌套冲突:在 Python 3.12 之前,
f-string外部若使用双引号,花括号内部的字典键名就必须使用单引号,如f"{d['key']}",否则会报错。Python 3.12 虽放宽了限制,但保持内外引号区分仍是良好的编码规范。 - 外部不可信模板的安全风险:永远不要让用户输入的不可信字符串直接作为
format()的模板,因为攻击者可以通过"{user.__class__.__init__.__globals__}"访问内部属性泄露数据;此场景应改用标准库中的string.Template。
五、工程技术选型决策
为了在实际开发中快速抉择,可以遵循如下决策流向:
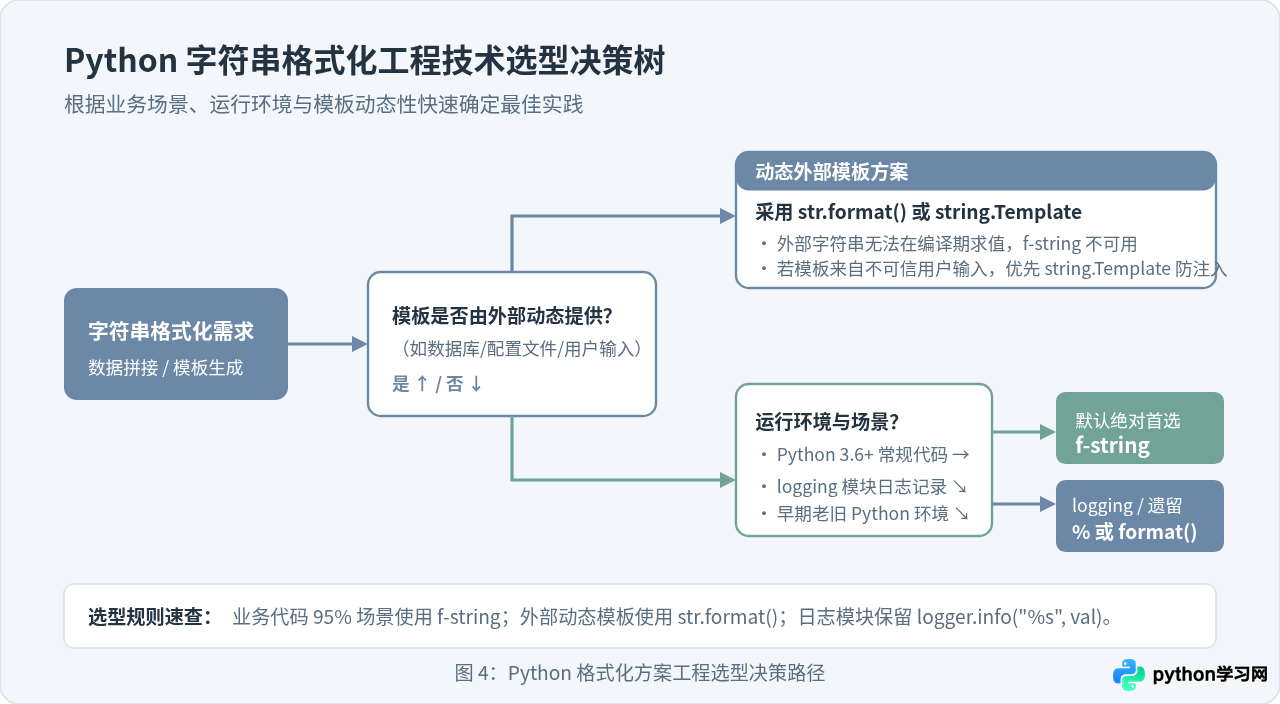
总体而言,f-string 已经成为现代 Python 的格式化事实标准。在日常业务逻辑编写、数据清洗与排版中,建议无条件优先采用 f-string;在遇到动态配置文件或国际化文案时,使用 str.format();而在标准日志输出时,保留 % 操作符的惰性传参形态。清晰界定各自的边界,能够让 Python 代码在兼顾清晰优雅的同时获得最优的运行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















