


Python办公自动化:批量处理Excel与PDF的实用小工具开发
日常办公中,大量重复的表格数据汇总结算与多页文档整理往往耗费大量人力。本文将通过原生 Python 脚本与核心第三方库,构建一个轻量级、模块化的批处理小工具。全文围绕 Excel 多表结构化合并与 PDF 批量抽取合并两项高频任务展开,提供完整的工程化代码、运行流程解析与常见异常规避方案。
一、整体架构与批处理工作流设计
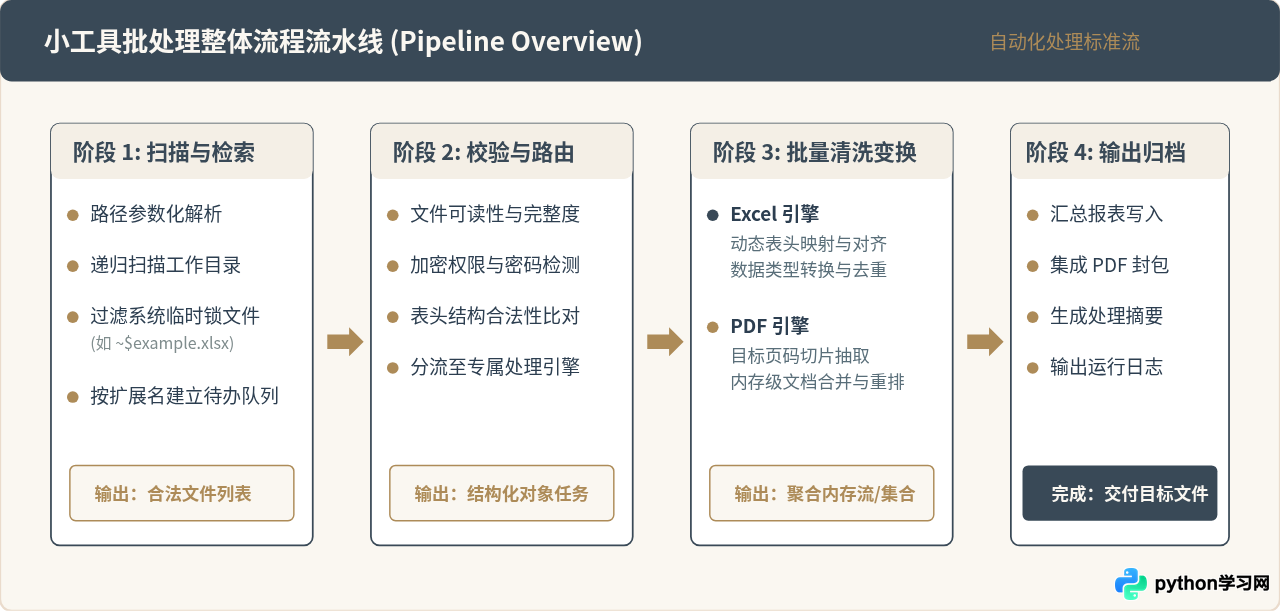
开发办公自动化脚本,核心在于降低使用门槛并确保执行稳定性。如果每次处理数据都需要进入代码修改路径或参数,工具的实用性就会大打折扣。一个设计良好的批处理小工具应当具备明确的职责划分:入口层负责参数解析与任务调度,文件引擎负责遍历与格式校验,业务层负责具体的数据变形与文档操作,最后由日志与报告模块反馈执行结果。
在设计该工具时,我们采用解耦的设计思路,将整个处理生命周期拆解为四个关键阶段:文件检索与筛选、格式识别与规则路由、业务流水线变换、最终产物聚合输出。以下为小工具的完整工作流图示:
二、开发准备与技术依赖选型
在 Python 生态中,针对办公文件的处理库较多。构建实用工具时,选型的关键在于轻量、稳定以及对常见 Office / PDF 版本的兼容性:
| 处理对象 | 选用库 | 核心优势 | 职责范围 |
|---|---|---|---|
| Excel 表格 | pandas + openpyxl |
pandas 适合大规模数据结构的矢量化拼接与列对其;openpyxl 支持无损读写 .xlsx 格式底层单元格。 |
数据抽取、字段名规范化清洗、多表纵向合并、报表样式导出。 |
| PDF 文档 | pypdf |
纯 Python 实现,无需安装系统级 C++ 依赖(如 poppler),跨平台运行稳定。 | 文档页面分割、多文档有序串联、元数据保留与合并写入。 |
| 命令行入口 | argparse (标准库) |
无需额外安装依赖,原生支持清晰的帮助信息、参数校验与可选标志。 | 解析工作目录、过滤条件、操作模式(Excel/PDF/全部)。 |
在命令行终端中,通过 pip 命令安装所需依赖:
pip install pandas openpyxl pypdf三、核心模块一:Excel 多表格批量汇总与字段自适应合并
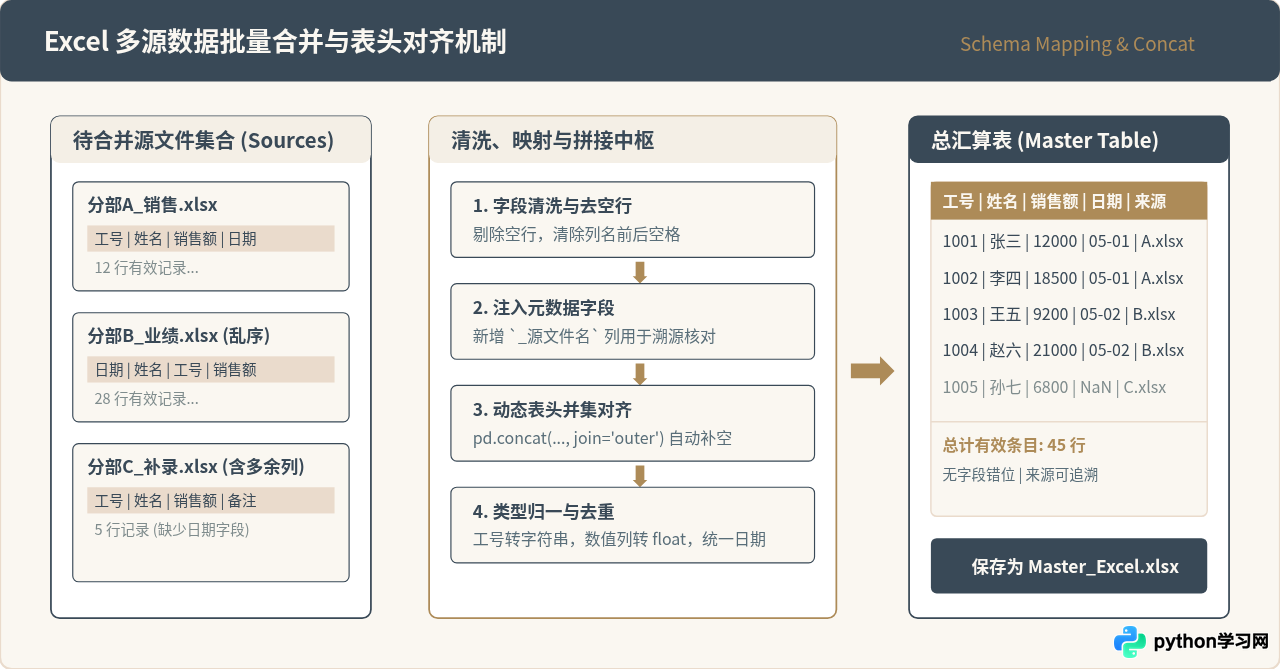
日常汇总各部门上报的数据时,常见的问题包括:各表列顺序不一致、部分表格存在多余字段、存在空白行、或者文件名携带了提交者信息。如果直接使用简单循环复制,极易发生字段错位。
处理该问题的可靠策略是:以 DataFrame 作为中间态,提取各表时将源文件名追加为“数据来源”列,通过列名匹配实现并集对齐,最后统一重置索引并保存。下图展示了多源表到统一汇总表的清洗与对齐逻辑:
以下为实现该逻辑的独立模块函数 merge_excel_files。该函数接受输入目录路径与输出路径,并自动过滤临时文件与隐藏表:
import os
import glob
import logging
from typing import List, Optional
import pandas as pd

logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")

def merge_excel_files(input_dir: str, output_file: str, sheet_name: Optional[str] = None) -> int:
    """
    扫描 input_dir 下所有 .xlsx 与 .xls 文件,按列名自动对其并合并输出至 output_file。
    返回成功合并的文件数量。
    """
    if not os.path.exists(input_dir):
        raise FileNotFoundError(f"指定的输入目录不存在: {input_dir}")

    # 检索所有 Excel 文件,严格排除临时锁文件 (~$ 开头)
    search_pattern = os.path.join(input_dir, "**", "*.xlsx")
    candidate_files = glob.glob(search_pattern, recursive=True)
    valid_files = [f for f in candidate_files if not os.path.basename(f).startswith("~$")]

    if not valid_files:
        logging.warning("未检索到任何有效的 Excel 工作簿文件。")
        return 0

    data_frames: List[pd.DataFrame] = []

    for file_path in valid_files:
        try:
            # 读取工作表,若未指定 sheet_name 则默认读取首个 Sheet
            target_sheet = sheet_name if sheet_name else 0
            df = pd.read_excel(file_path, sheet_name=target_sheet, engine="openpyxl")

            # 基础数据清洗:剔除完全为空的行和列
            df.dropna(how="all", inplace=True)
            if df.empty:
                logging.info(f"跳过空文件: {os.path.basename(file_path)}")
                continue

            # 去除列头多余的空格
            df.columns = [str(col).strip() for col in df.columns]

            # 追加来源标记列,便于溯源核查
            df["_源文件名"] = os.path.basename(file_path)
            data_frames.append(df)
            logging.info(f"成功读取: {os.path.basename(file_path)} (行数: {len(df)})")
        except Exception as e:
            logging.error(f"读取文件 {file_path} 失败: {str(e)},已跳过。")

    if not data_frames:
        logging.error("没有成功提取到任何表格数据。")
        return 0

    # 纵向拼接,通过 outer join 自动容纳不同表格的非重叠字段
    merged_df = pd.concat(data_frames, axis=0, ignore_index=True, sort=False)

    # 确保输出目录存在
    output_dir = os.path.dirname(os.path.abspath(output_file))
    os.makedirs(output_dir, exist_ok=True)

    # 导出整合结果
    merged_df.to_excel(output_file, index=False, engine="openpyxl")
    logging.info(f"合并完成!总条目: {len(merged_df)} 行,已保存至: {output_file}")
    return len(valid_files)
四、核心模块二:PDF 批量抽取、切片与有序合并
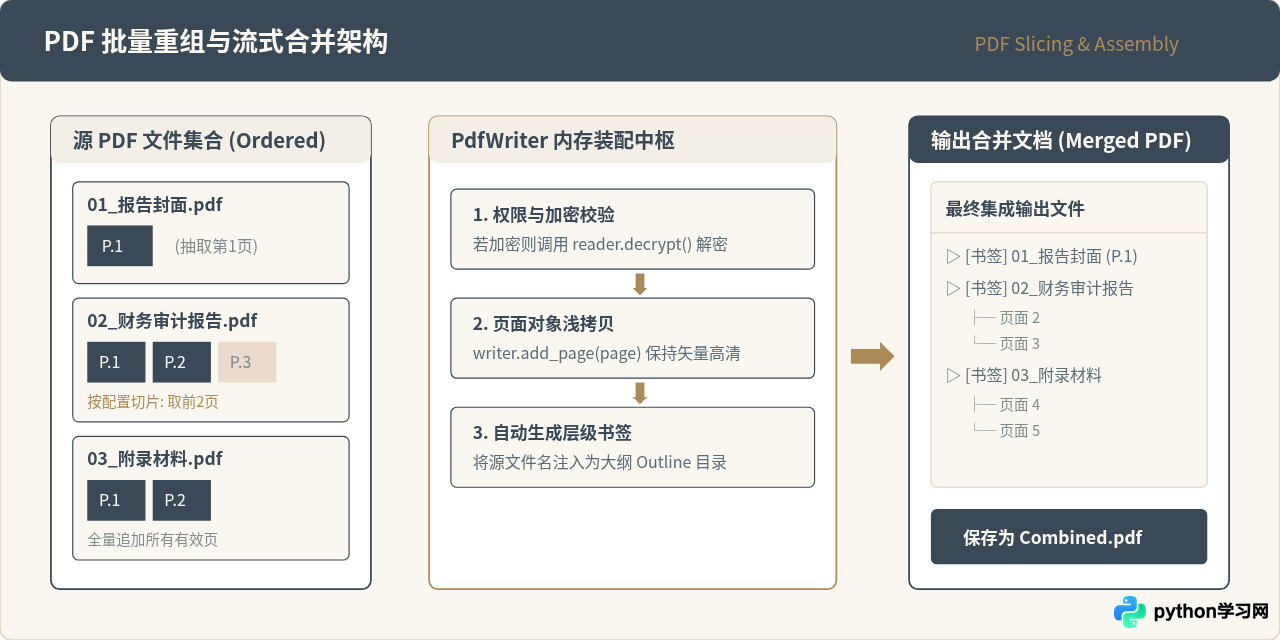
在涉及凭证扫描件、合同汇编或报告整理的工作中,通常需要将分散的单页或多页 PDF 按照一定顺序串联为一个完整的大文件,或者剔除封面与废页。使用 pypdf 库可以在内存层快速重组页面对象,免去了对庞大办公软件的依赖。
PDF 处理的核心考量点在于页面引用的生命周期管理与排序确定性。直接依赖操作系统的文件遍历返回的顺序通常是不可控的,必须通过自然排序或前缀规则显式排序。下图详细梳理了 PDF 文件的提取与合并架构:
以下为 merge_pdf_files 的具体代码实现。该函数不仅实现了多文件的串联,还会根据源文件名自动创建 PDF 层级大纲(书签),便于阅读:
import os
import glob
import logging
from typing import List, Optional
from pypdf import PdfReader, PdfWriter

def merge_pdf_files(input_dir: str, output_file: str, max_pages_per_file: Optional[int] = None) -> int:
    """
    扫描 input_dir 下所有 .pdf 文件,按文件名自然序合并为单一 PDF。
    支持自动生成文件名大纲书签;若设置 max_pages_per_file,则对单文件抽取前 N 页。
    返回成功合并的源 PDF 文件数量。
    """
    if not os.path.exists(input_dir):
        raise FileNotFoundError(f"输入路径不存在: {input_dir}")

    search_pattern = os.path.join(input_dir, "**", "*.pdf")
    pdf_files = sorted(glob.glob(search_pattern, recursive=True))

    if not pdf_files:
        logging.warning("未找到任何 PDF 文件。")
        return 0

    writer = PdfWriter()
    processed_count = 0
    current_page_index = 0

    for file_path in pdf_files:
        filename = os.path.basename(file_path)
        try:
            reader = PdfReader(file_path)

            # 检测文档是否被加密
            if reader.is_encrypted:
                try:
                    # 尝试空密码解密(部分文档仅设限制性口令而无打开密码)
                    reader.decrypt("")
                except Exception:
                    logging.warning(f"文件受密码保护且无法解密,已跳过: {filename}")
                    continue

            total_pages = len(reader.pages)
            if total_pages == 0:
                continue

            # 决定当前文件截取的页数范围
            extract_limit = min(total_pages, max_pages_per_file) if max_pages_per_file else total_pages

            # 添加书签(以文件名为标题,指向该文件首页在合并文档中的位置)
            writer.add_outline_item(title=os.path.splitext(filename)[0], page_number=current_page_index)

            # 逐页装配
            for page_idx in range(extract_limit):
                page = reader.pages[page_idx]
                writer.add_page(page)
                current_page_index += 1

            processed_count += 1
            logging.info(f"已装配 PDF: {filename} (提取 {extract_limit}/{total_pages} 页)")

        except Exception as e:
            logging.error(f"处理 PDF 失败 {filename}: {str(e)}")

    if processed_count == 0:
        logging.error("未能成功追加任何 PDF 页面。")
        return 0

    # 确保输出目录就绪并写入最终产物
    os.makedirs(os.path.dirname(os.path.abspath(output_file)), exist_ok=True)
    with open(output_file, "wb") as f_out:
        writer.write(f_out)

    logging.info(f"PDF 合并完毕!共并入 {processed_count} 个文件、{current_page_index} 页,输出至: {output_file}")
    return processed_count
五、统一整合:打造开箱即用的命令行小工具
为了让该脚本真正成为团队或个人可以随时调用的自动化工具,我们将上述模块整合到一个主入口脚本中。使用标准库 argparse,支持用户通过命令行参数指定待处理的文件夹、输出目标以及作业模式(单选 Excel、单选 PDF 或两者同时处理)。
以下为完整的综合脚本 batch_office_tool.py:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
实用办公自动化小工具:批量处理 Excel 与 PDF
支持模式:
  1. excel: 批量读取合并多张工作表,自动表头并集对齐
  2. pdf:   批量按序合并 PDF 文档,并自动注入对应大纲书签
  3. all:   同时执行 Excel 与 PDF 批量合并
"""

import sys
import argparse
import logging
from datetime import datetime

# 引入前文封装好的功能函数
# from excel_processor import merge_excel_files
# from pdf_processor import merge_pdf_files

def parse_arguments():
    parser = argparse.ArgumentParser(
        description="Python 办公自动化工具:批量处理 Excel 报表与 PDF 文档"
    )
    parser.add_argument(
        "--mode",
        choices=["excel", "pdf", "all"],
        default="all",
        help="处理模式: 'excel' 汇总表格, 'pdf' 合并文档, 'all' 全部执行 (默认: all)"
    )
    parser.add_argument(
        "--input-dir",
        required=True,
        help="待处理文件所在的输入文件夹路径"
    )
    parser.add_argument(
        "--excel-output",
        default="./output/merged_summary.xlsx",
        help="Excel 汇总结果输出路径 (默认: ./output/merged_summary.xlsx)"
    )
    parser.add_argument(
        "--pdf-output",
        default="./output/merged_document.pdf",
        help="PDF 合并结果输出路径 (默认: ./output/merged_document.pdf)"
    )
    parser.add_argument(
        "--pdf-max-pages",
        type=int,
        default=None,
        help="每个 PDF 仅提取前 N 页 (默认提取完整文档)"
    )
    return parser.parse_args()

def main():
    args = parse_arguments()
    start_time = datetime.now()
    logging.info("==========================================")
    logging.info(" 办公自动化小工具开始执行 ")
    logging.info(f" 当前模式: {args.mode} | 目标路径: {args.input_dir}")
    logging.info("==========================================")

    excel_success = 0
    pdf_success = 0

    try:
        # 处理 Excel
        if args.mode in ("excel", "all"):
            logging.info("[任务 1/2] 开始批量扫描与合并 Excel 报表...")
            excel_success = merge_excel_files(
                input_dir=args.input_dir,
                output_file=args.excel_output
            )

        # 处理 PDF
        if args.mode in ("pdf", "all"):
            logging.info("[任务 2/2] 开始批量扫描与合并 PDF 文档...")
            pdf_success = merge_pdf_files(
                input_dir=args.input_dir,
                output_file=args.pdf_output,
                max_pages_per_file=args.pdf_max_pages
            )

    except Exception as exc:
        logging.error(f"执行过程中发生未捕获异常: {exc}", exc_info=True)
        sys.exit(1)

    elapsed_seconds = (datetime.now() - start_time).total_seconds()
    logging.info("==========================================")
    logging.info(" 处理完成总结 ")
    logging.info(f" Excel 处理成功数: {excel_success}")
    logging.info(f" PDF   处理成功数: {pdf_success}")
    logging.info(f" 总耗时: {elapsed_seconds:.2f} 秒")
    logging.info("==========================================")

if __name__ == "__main__":
    main()
执行示例说明:
假设你有一个名为 monthly_data 的文件夹,里面存放了各部门本月的汇报 Excel 以及说明 PDF,只需执行以下命令即可一键完成全流程:
python batch_office_tool.py --input-dir ./monthly_data --mode all
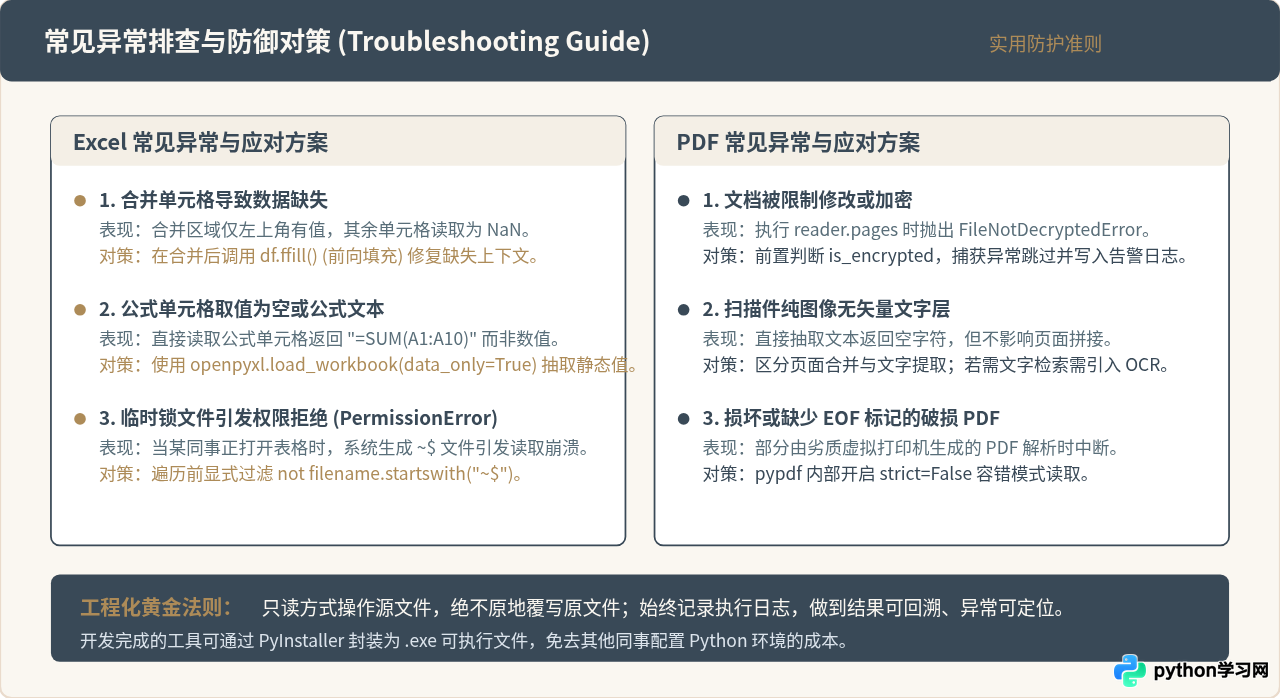
六、生产环境常见问题与避坑排错指南
在实际办公场景中,用户提交的文件往往存在大量非标准格式或特殊状态。提前在代码中加入防御性逻辑,是工具能否长期稳定运行的关键:
七、总结与后续扩展建议
通过本文的实践,我们构建了一个兼顾 Excel 与 PDF 批量处理的实用工具。回顾核心设计:
- 结构化汇总:通过 Pandas 的
concat配合外连接对齐,优雅解决了多表字段乱序与缺失问题,同时保留源文件名作为追溯凭据。 - 内存级拼装:利用
pypdf的流式页面拷贝与书签注入,实现了高质量、带目录索引的文档聚合,避免了第三方重型组件的捆绑。 - 模块化调度:入口脚本与业务处理分离,支持命令行直接传参,既能单机手动运行,也能轻松接入系统的定时任务(如 Linux crontab 或 Windows 任务计划程序)。
如果希望进一步降低非技术人员的使用门槛,后续可以使用 tkinter 或 PyQt 封装一个极简的文件拖拽选择图形界面;或者使用 pyinstaller -F batch_office_tool.py 生成单文件二进制程序,实现即点即用的办公生产力升级。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















