


Python遍历字典列表:基础for循环与键值访问示例
在Python日常编程与后端数据接口处理中,“字典列表”(包含多个字典的列表结构)是最普遍的数据承载形式之一。遍历该结构的核心逻辑是:通过外层标准的 for 循环依次取出每一个字典元素,再通过键名检索对应的值。本文通过完整可运行的示例代码,演示基础循环结构、键值读取技巧,并重点对比直接下标访问与 .get() 方法在健壮性上的关键差异。
一、认识字典列表的数据结构
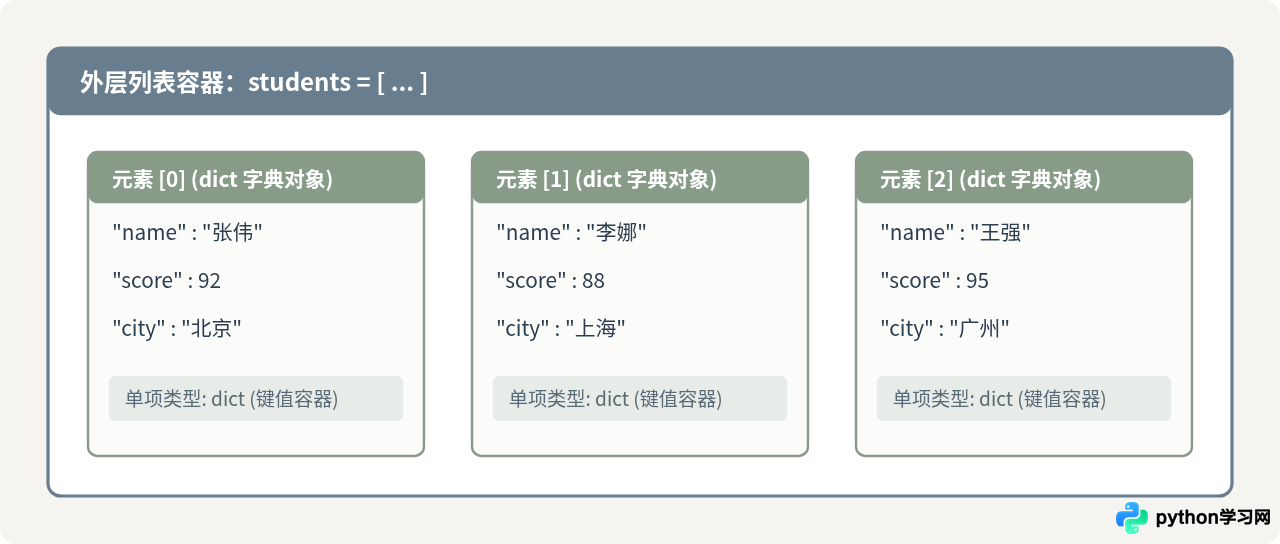
字典列表在物理形式上是一个标准的Python列表(list),其中的每个元素都是一个独立的键值对容器(dict)。这种结构常见于关系数据库查询结果、RESTful API返回的JSON数组,或是本地记录的批处理数据集。
例如,一个包含多名学生基本信息的列表可以声明如下:
students = [
    {"name": "张伟", "score": 92, "city": "北京"},
    {"name": "李娜", "score": 88, "city": "上海"},
    {"name": "王强", "score": 95, "city": "广州"}
]
在此结构中,外层列表维持了数据的顺序,内层字典则通过语义化字符串(如 "name"、"score")来组织和标记具体的字段内容。
二、基础for循环的单层遍历与键值读取
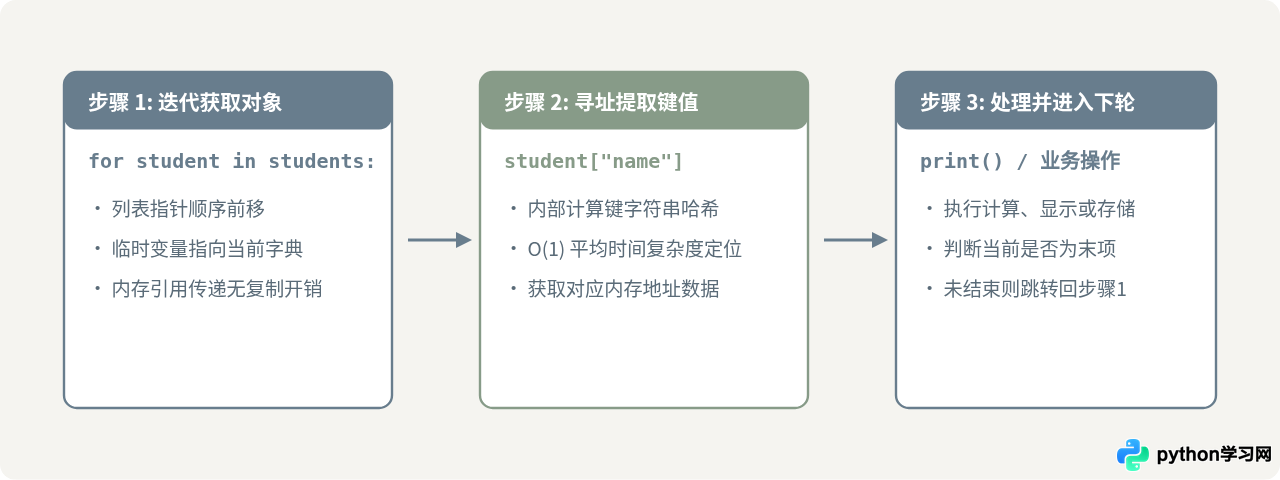
在Python中,对列表执行遍历的最直接方式是使用 for item in list 语法。当列表中的元素为字典时,循环变量 item 在每一轮迭代中都会自动绑定到当前位置的字典对象。
1. 基础代码示例:直接下标访问
在循环体内,可以直接使用方括号语法 item["key"] 读取字段值:
students = [
    {"name": "张伟", "score": 92, "city": "北京"},
    {"name": "李娜", "score": 88, "city": "上海"},
    {"name": "王强", "score": 95, "city": "广州"}
]

# 使用基础for循环逐一读取字段
for student in students:
    name = student["name"]
    score = student["score"]
    city = student["city"]
print(f"学员: {name} | 成绩: {score} | 城市: {city}")学员: 李娜 | 成绩: 88 | 城市: 上海
学员: 王强 | 成绩: 95 | 城市: 广州
这段代码的执行顺序十分直观:Python解释器在第1轮循环中将 student 赋值为 {"name": "张伟", ...},完成读取并打印;随后自动前进至下一个元素,直至整个列表处理完毕。
三、关键对比:直接下标与 .get() 方法的差异
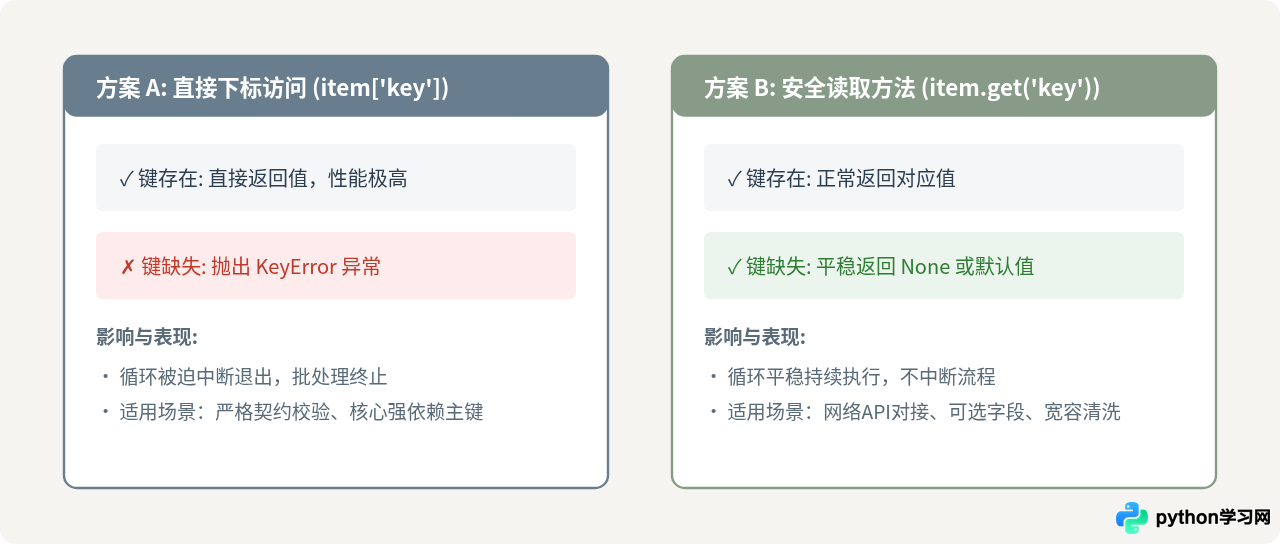
在遍历实际业务中的字典列表时,数据质量往往参差不齐。根据访问方式的不同,程序对“缺失键”的表现具有决定性区别。
1. 相同场景下的不同行为
假设列表包含一个字段不完整的记录(缺少 "city" 键):
records = [
    {"name": "张伟", "city": "北京"},
    {"name": "未知者"},  # 注意:该字典没有 "city" 键
    {"name": "王强", "city": "广州"}
]
做法 A:使用直接下标访问 item["city"]
# 做法 A:直接下标
for item in records:
    # 遍历到第二条时将直接抛出异常并中断程序
    city = item["city"]
print(item["name"], city)Traceback (most recent call last):
File "demo.py", line 7, in <module>
city = item["city"]
KeyError: 'city'
做法 B:使用 .get() 安全访问方法
# 做法 B:使用 .get() 方法并设定缺省值
for item in records:
    city = item.get("city", "未填")
print(f"姓名: {item['name']} | 所在城市: {city}")姓名: 未知者 | 所在城市: 未填
姓名: 王强 | 所在城市: 广州
2. 差异为什么重要
在批处理10万条数据的任务中,如果仅仅因为某一条记录缺少一个非关键键,直接下标访问会导致整个任务在第5万条时因 KeyError 崩溃抛出,前期处理的数据可能需要重新推倒。
- 直接下标
item[key]:属于“严格校验契约”。它的优势在于语义直接、解析速度比方法调用略快一筹,并且当某个核心业务字段绝对不应缺失时,能够尽早暴露上游脏数据。 - 安全方法
item.get(key, default):属于“宽容防守模式”。当键不存在时默认返回None(或指定默认值),确保批量循环在面对结构不规整的数据时具备容错韧性。
四、实际应用中的常见扩展技巧
1. 同时获取序号:配合 enumerate() 循环
在生成编号报表或需要记录错误条目的行数时,可以使用 enumerate() 函数为每一轮迭代附加递增的索引序号:
students = [
    {"name": "张伟", "score": 92},
    {"name": "李娜", "score": 88},
    {"name": "王强", "score": 95}
]

# start=1 表示索引从 1 开始计数
for index, student in enumerate(students, start=1):
    print(f"序号 [{index}]: 姓名={student['name']}, 得分={student['score']}")
2. 在循环中执行条件过滤
经常需要在遍历的同时提取满足特定条件的记录,例如筛选及格或高分记录:
high_scorers = []

for student in students:
    # 提取 score 字段并进行数值判断
    if student.get("score", 0) >= 90:
        high_scorers.append(student["name"])

print(f"高分学员名单: {high_scorers}")for 循环体内部直接对正在遍历的 students 列表执行 remove() 或 pop() 等删除操作。因为列表长度动态缩减会导致内部指针偏移,造成跳过后续元素的隐蔽逻辑错误。
五、遍历与访问决策总结
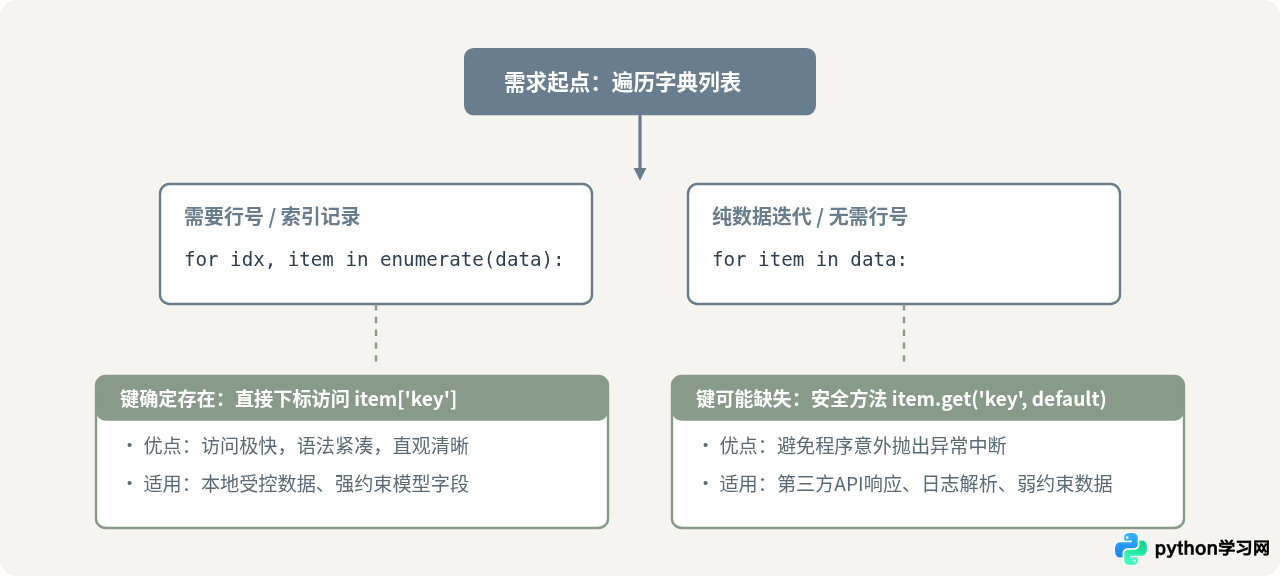
遍历字典列表是Python数据清洗与分析的基础动作。在设计循环逻辑时,可以根据数据的来源与可靠性,按如下路径选择最适宜的代码方案:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















