


Python类(Class)基础教程:定义、实例化与self参数详解
在 Python 中,类(Class)是组织代码、封装数据与行为的核心机制,也是掌握面向对象编程(OOP)的基石。很多初学者在刚接触类时,往往能机械地写出结构,却对“类与实例在内存中究竟是什么关系”、“为什么方法总要带着 self 形参”以及“调用方法时 self 是如何自动绑定的”感到模糊。本文直接切入核心,系统拆解类的定义语法、对象实例化的底层执行过程,并深入剖析 self 参数的设计原理与易混淆细节,帮助读者建立清晰准确的面向对象思维模型。
一、类的基本定义语法与结构
类是创建对象的“蓝图”或“模板”。在 Python 中,定义一个类使用 class 关键字,后跟类名和冒号。类名通常遵循大驼峰命名规范(CapWords,即每个单词首字母大写)。类体中主要包含两种元素:属性(用于存储数据)与方法(用于执行操作的函数)。
一个标准的类定义通常包含类属性、初始化方法 __init__ 以及若干普通实例方法:
class UserAccount:
    # 类属性:属于类本身,所有实例共享该字段
    platform_name = "GlobalBank"

    # 初始化方法(构造函数):在创建新对象时自动被调用
    def __init__(self, owner, initial_balance=0.0):
        # 实例属性:属于具体实例专属的数据
        self.owner = owner
        self.balance = float(initial_balance)

    # 实例方法:定义在类内部的操作行为,首位形参必须为 self
    def deposit(self, amount):
        if amount > 0:
            self.balance += amount
            return f"成功存入 {amount} 元,当前余额为 {self.balance} 元"
        return "存入金额必须大于 0"

    def get_info(self):
        return f"[{self.platform_name}] 账户所有者: {self.owner}, 账户余额: {self.balance}"
在上述代码中:
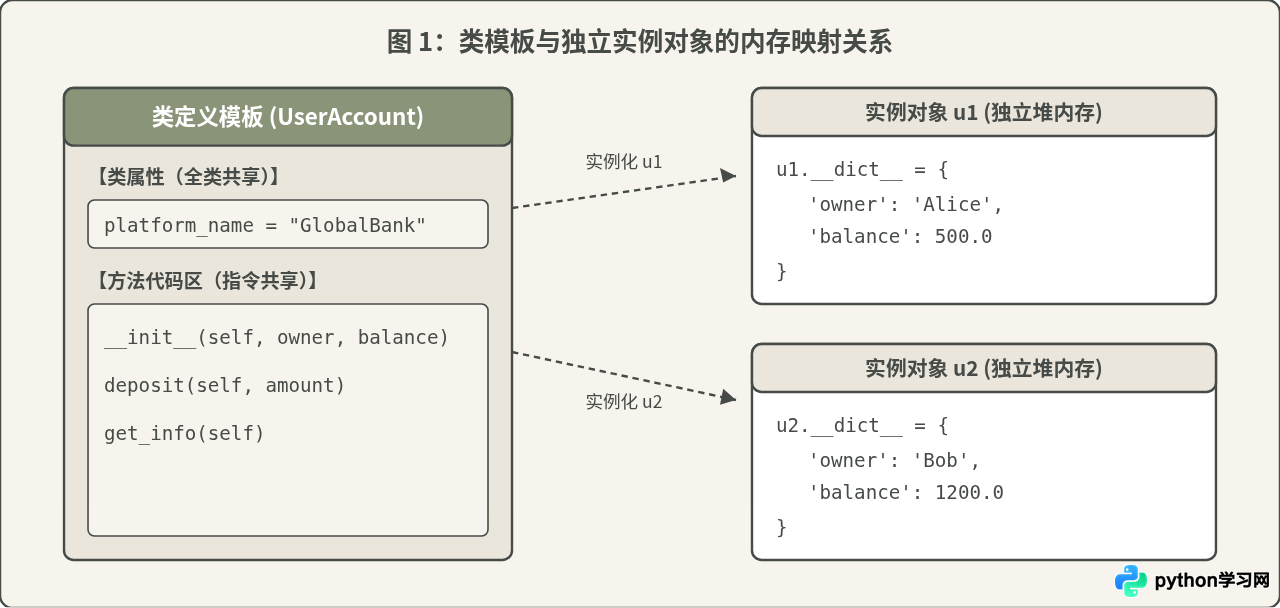
platform_name是直接写在类体内的变量,称为类属性,它被所有该类的实例共享。__init__是 Python 的特殊内置方法(双下划线方法)。它的职责不是凭空“创建”对象,而是在底层创建好空对象后,对其进行属性初始化赋值。owner和balance是挂载在self上的变量,称为实例属性。每个通过该类生成的对象,都各自持有一份独立的变量副本。
二、对象的实例化过程与内存生命周期
定义类只是在内存中注册了模板逻辑,程序运行并不会自动产生具体的业务数据实体。要把模板转化为可用对象,必须执行实例化(Instantiation)。
1. 实例化的标准语法
在 Python 中,实例化对象的语法如同调用一个普通函数:写出类名并在圆括号中传入 __init__ 接收的初始实参(注意不要传入 self 参数):
# 实例化两个完全独立的对象
u1 = UserAccount("Alice", 500.0)
u2 = UserAccount("Bob", 1200.0)

print(u1.get_info())
print(u2.get_info())

# 验证实例在内存中的独立性
print("u1 的内存地址 id:", id(u1))
print("u2 的内存地址 id:", id(u2))
print("两者是否为同一对象:", u1 is u2)[GlobalBank] 账户所有者: Bob, 账户余额: 1200.0
u1 的内存地址 id: 140361284918400
u2 的内存地址 id: 140361284918592
两者是否为同一对象: False
2. 实例化执行的底层四步流程
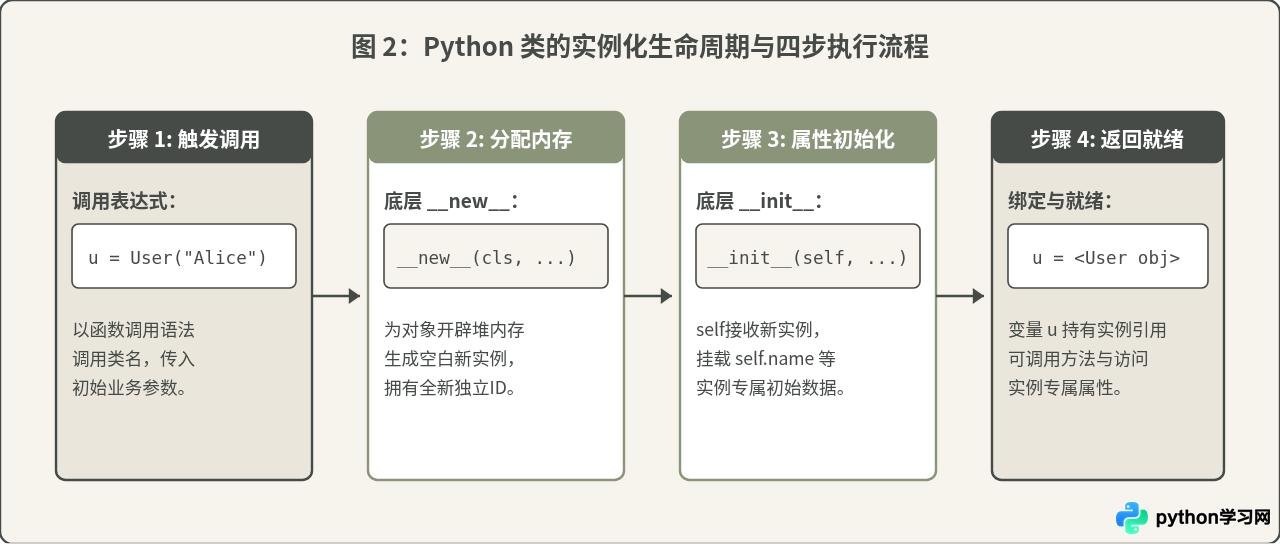
表面上 u = UserAccount("Alice") 是一行简洁的赋值代码,但 Python 解释器在底层实际顺序完成了以下四个阶段:
- 调用触发:解释器捕获到对类对象的调用表达式
UserAccount(...)。 - 内存开辟(
__new__):首先调用类的静态构造器__new__(cls, *args, **kwargs)。该方法向操作系统申请堆内存,生成一个干净的、尚未填充数据的空白实例对象。 - 属性挂载(
__init__):解释器将刚刚由__new__生成的空白实例作为第一个参数(即self),与用户传入的其余参数一起传递给__init__(self, ...)。在此阶段,属性被正式写入该实例的__dict__字典中。 - 引用返回:实例对象初始化完毕后被自动返回,赋给左侧的变量
u。
三、self 参数深度剖析与绑定原理
在类的所有语法规则中,self 是引发初学者疑问最多的概念:为什么定义方法时第一个参数一定要写 self?为什么在实例调用时却不需要传入它?
1. self 的本质:当前实例的指针引用
从底层机制看,定义在类中的所有方法本质上都只是普通的 Python 函数。为了节约内存,无论你通过 UserAccount 实例化了 10 个还是 10 万个对象,deposit 方法的代码都只在内存中保存了一份。
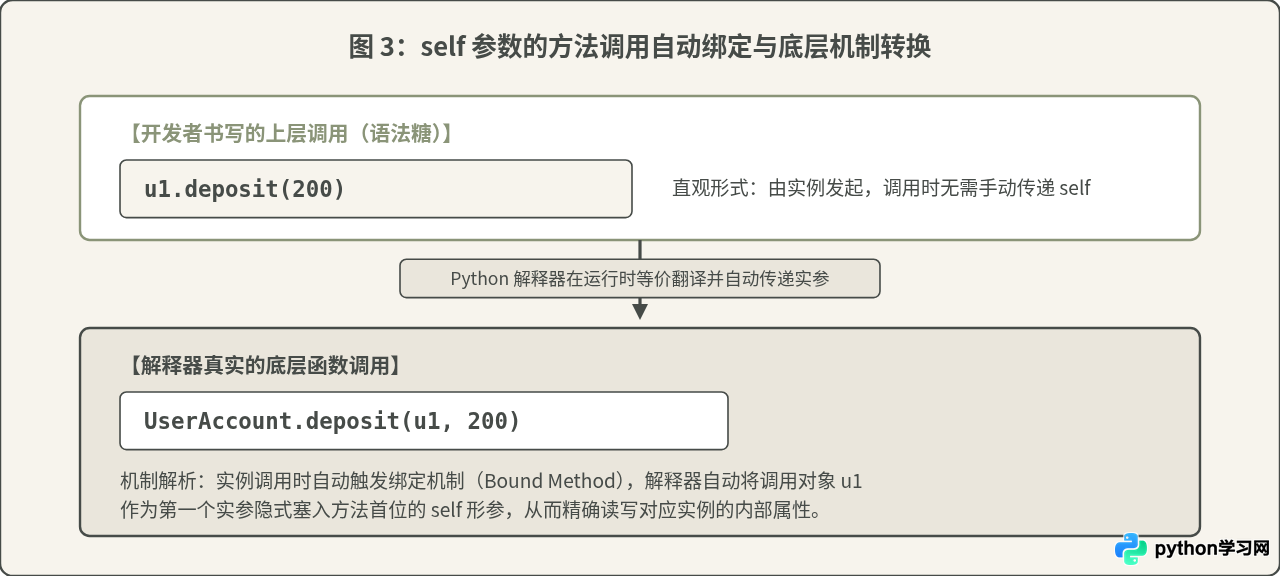
当执行 u1.deposit(200) 时,方法必须知道“究竟应该给哪个账户增加余额”。self 形参的作用,正是用来接收正在发起调用的那个具体实例对象的内存地址。
2. 语法糖与底层转换关系
我们平时书写的 u1.deposit(200) 实际上是 Python 提供的语法糖。在底层,解释器会自动将其转换为通过类对象调用的完整函数形式:
# 开发者写的上层语法糖:
u1.deposit(200)

# Python 解释器底层的实际等价执行:
UserAccount.deposit(u1, 200)
下面这段代码可以清晰证明两者的完全等价性:
user = UserAccount("Charlie", 100.0)

# 方式 A:通过实例调用(常规写法)
res_a = user.deposit(50.0)

# 方式 B:通过类显式传入实例作为 self(底层真实形式)
res_b = UserAccount.deposit(user, 50.0)

print(res_a)
print(res_b)
print("最终余额:", user.balance)成功存入 50.0 元,当前余额为 200.0 元
最终余额: 200.0
3. 关于 self 的常见误解与辩析
辩析一:self 是不是 Python 的语法保留关键字?
不是。在 Python 关键字列表(keyword.kwlist)中根本没有 self。从语法角度看,将首位形参写成 this、obj 甚至任何合法标识符,程序都能正常运行。但是,PEP 8 官方代码规范强烈建议并约定必须使用 self。使用其他名称不仅会破坏 IDE 代码补全提示,还会给团队协作带来严重困扰。
辩析二:方法内不加 self 的变量与加 self 的变量有什么区别?
在方法内部,如果只写 var = 10,这仅仅是当前方法作用域下的局部变量,方法执行结束该变量立即被销毁,无法在其他方法中跨作用域访问。只有写成 self.var = 10,数据才会被绑定到该实例对应的字典中,只要对象存在,其值就持续有效且能在任何实例方法中读取。
四、综合应用:学生成绩管理实践
为了加深理解,我们编写一个贴合实际业务场景的完整示例:构建一个学生成绩管理类 StudentRecord,体现定义、实例化以及通过 self 维护实例独立状态的全过程。
class StudentRecord:
    # 类属性:及格线阈值
    pass_mark = 60

    def __init__(self, student_id, name):
        # 实例属性
        self.student_id = student_id
        self.name = name
        self.scores = {}

    def add_score(self, subject, score):
        """记录指定科目的成绩"""
        if 0 <= score <= 100:
            self.scores[subject] = score
            return True
        return False

    def calculate_average(self):
        """计算平均分"""
        if not self.scores:
            return 0.0
        return sum(self.scores.values()) / len(self.scores)

    def get_report(self):
        """生成成绩报告单"""
        avg = self.calculate_average()
        details = ", ".join([f"{sub}: {sc}" for sub, sc in self.scores.items()])
        is_passed = all(sc >= self.pass_mark for sc in self.scores.values())
        status = "全部及格" if is_passed else "存在不及格科目"
        return f"学号: {self.student_id} | 姓名: {self.name} | 平均分: {avg:.1f} | 状态: {status} | 明细: [{details}]"

# 实例化两个学生对象
s1 = StudentRecord("S202601", "李明")
s2 = StudentRecord("S202602", "张华")

# 分别录入数据(每个对象各自维护独立的 scores 字典)
s1.add_score("Python编程", 88)
s1.add_score("高等数学", 92)

s2.add_score("Python编程", 55)
s2.add_score("高等数学", 78)

print(s1.get_report())
print(s2.get_report())学号: S202602 | 姓名: 张华 | 平均分: 66.5 | 状态: 存在不及格科目 | 明细: [Python编程: 55, 高等数学: 78]
五、核心知识全景总结与避坑要点
在日常开发中,初学者常常因为遗漏 self 或混淆属性类型而引发程序异常。下表总结了最易犯的错误场景与标准排查修复手段:
| 常见错误表现 | 引发原因 | 典型报错提示 | 标准修复方式 |
|---|---|---|---|
定义实例方法时漏写 self |
函数无法接收底层自动传来的实例实参 | TypeError: method() takes 0 positional arguments but 1 was given |
在方法形参列表首位补上 self |
方法内引用实例属性漏加 self. |
解释器将属性名误认为局部变量或全局变量 | NameError: name 'xxx' is not defined |
访问本实例属性或调用方法时一律加上 self. 前缀 |
| 将可变类型(如列表、字典)误定义为类属性 | 所有实例操作同一内存引用,数据相互串改污染 | 逻辑异常(A 实例添加数据,B 实例莫名同步出现) | 将每个实例独有的可变数据移至 __init__ 中定义为实例属性 |
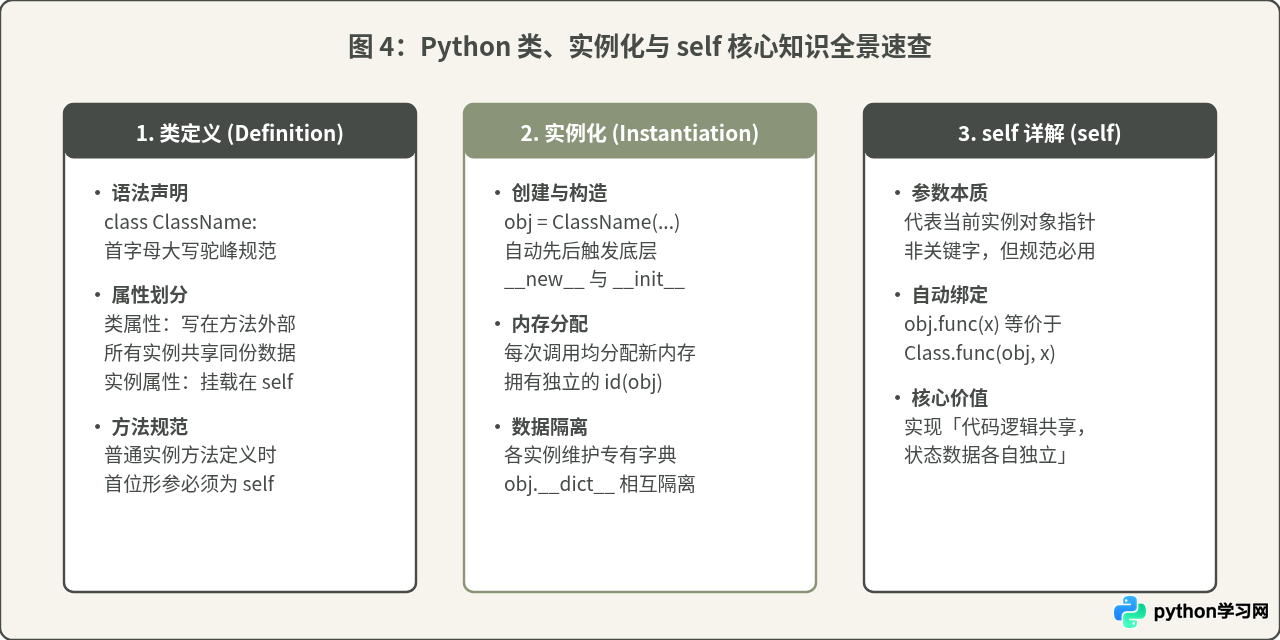
理解类、实例化与 self 的关系,本质上是理解面向对象设计中“代码复用与状态隔离”的权衡艺术。掌握了底层绑定转换机制,无论是面对后续的继承多态、私有属性还是类方法与静态方法装饰器,都能做到举一反三,写出结构稳健规范的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















