


何时适合使用Python构建微服务集群?典型应用场景分析
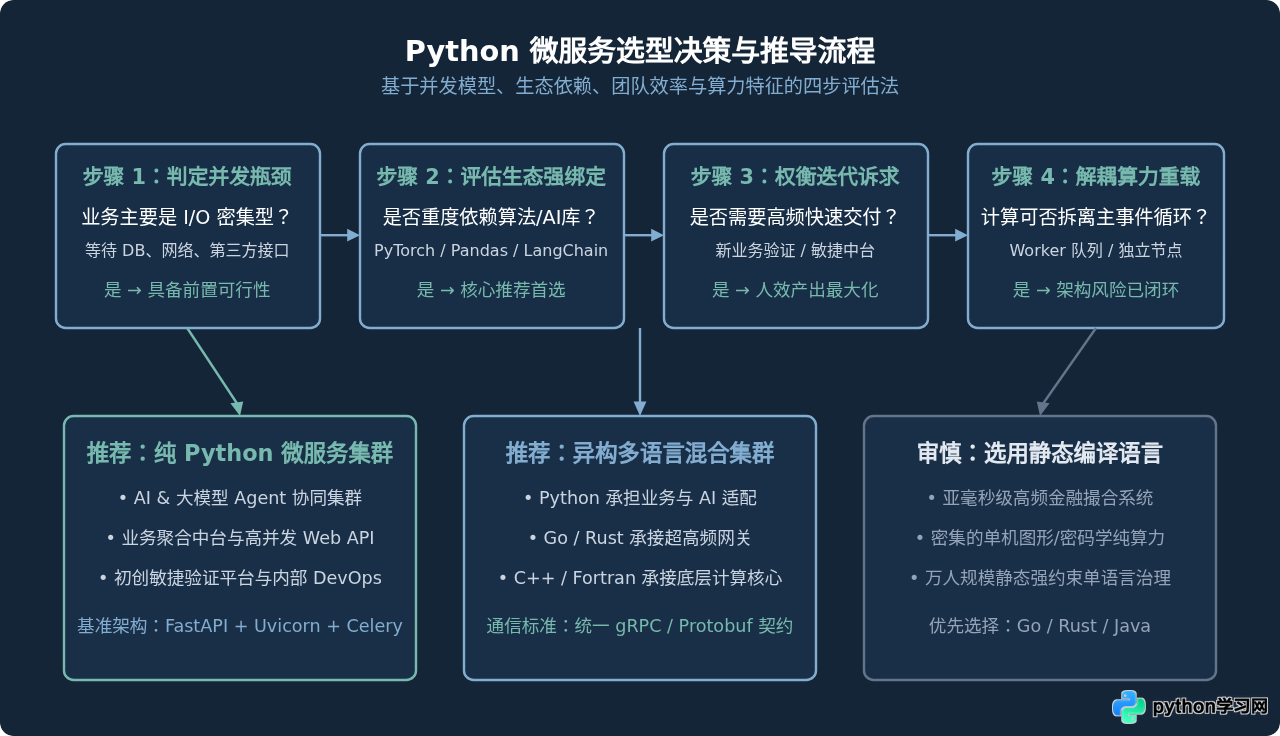
判断何时适合使用 Python 构建微服务集群,核心依据在于系统的并发瓶颈形态与技术生态依赖:当业务系统以 I/O 密集型接口、AI 与机器学习算法工程化、高敏捷迭代探索为主要诉求,且团队具备深厚 Python 积累时,采用现代异步 Python 框架构建微服务集群是最具性价比的选择;而当核心瓶颈落在极低延迟的 CPU 密集型计算或对类型契约有极端严苛约束时,则应审慎评估或选用异构混合方案。本文将深入剖析 Python 在微服务领域的真实边界、关键架构特征及四大典型落地场景。
一、Python 构建微服务集群的技术底色与物理边界
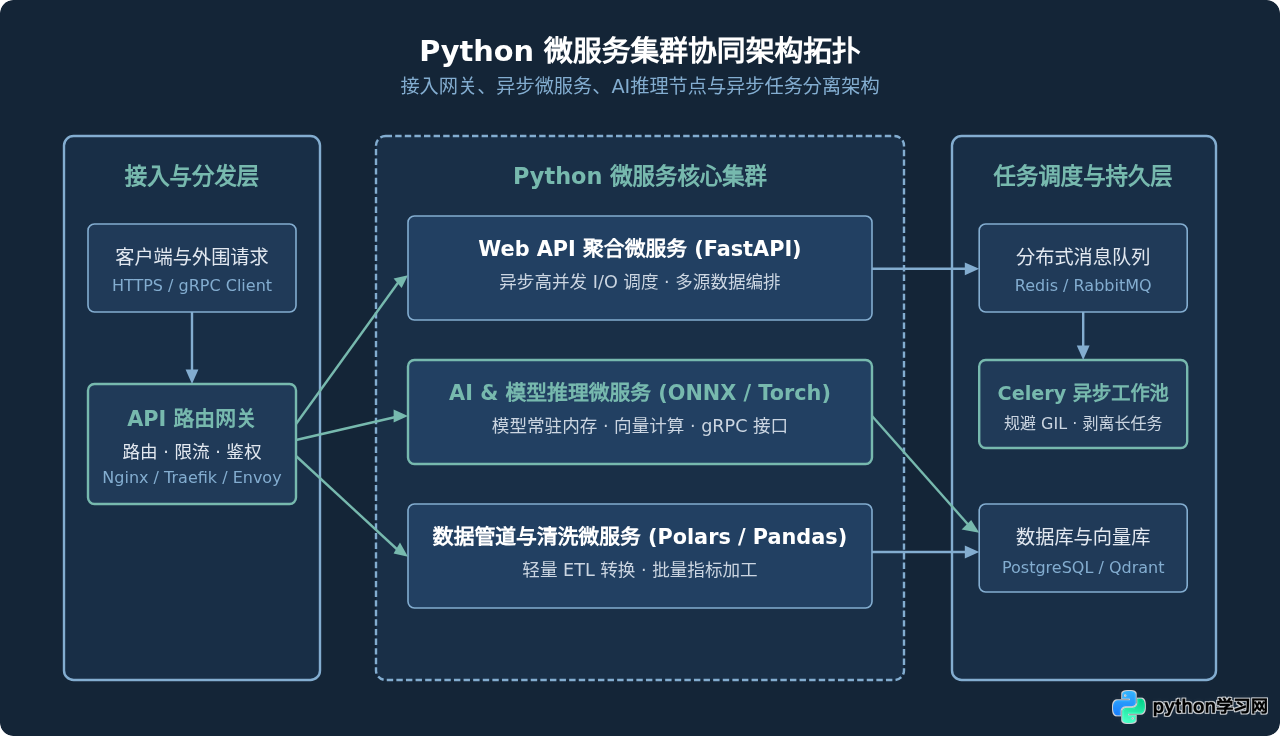
在讨论具体业务场景前,必须先厘清 Python 在构建现代微服务集群时所处的真实技术底色。长久以来,关于“Python 存在全局解释器锁(GIL)导致无法利用多核”的刻板印象,常常让部分架构师对其进入微服务领域产生疑虑。然而现代微服务运行形态已经发生了根本性重构:
- I/O 密集型并发模型的成熟:基于
asyncio与底层高性能事件循环uvloop,配合FastAPI、Sanic等现代 ASGI 框架,单进程在等待网络请求、缓存读写和数据库查询时能够保持极高的吞吐能力。现代 Python 服务的 QPS 瓶颈通常不在语言本身,而在于下游依赖资源的响应效率。 - 多进程容器化运行模型的演进:在 Kubernetes 和 Docker 盛行的云原生环境下,规避单进程单核限制早已不再依赖语言层面的多线程,而是直接采用“
Gunicorn主进程管理多个UvicornWorker 进程”或通过“单个 Pod 单 Worker 结合 Kubernetes HPA 自动水平弹性伸缩”的架构标准。 - 轻量级契约与生态集成:利用
Pydantic实现严格运行时类型验证,结合gRPC与 Protobuf 提供的跨服务二进制通信契约,使得 Python 能够完全融入规范的大型微服务集群。
二、典型适用场景深度剖析
在清晰认识了 Python 的运行特征后,以下四个领域是业界广泛验证最适合采用 Python 构建微服务集群的典型应用场景:
场景一:AI、大模型应用与数据科学工程化服务
这是当前 Python 构建微服务集群最无可替代的核心场景。人工智能和机器学习领域的几乎所有主流框架(如 PyTorch、TensorFlow、Hugging Face Transformers、vLLM、LangChain 等)其核心 SDK 首发且完善度最高的环境皆为 Python。
若强行使用 Go 或 Java 开发微服务,去远程调用 Python 脚本或进程间管道,不仅徒增通信序列化开销,还会造成极其脆弱的维护链路。将模型包装为一个独立的 Python 微服务(例如利用 FastAPI 或 Triton Server 导出 gRPC 接口),由 Python 微服务直接常驻内存管理显存与模型权重,对外提供结构化推理 API,是目前业界最标准、最高效的工程实践。
场景二:I/O 密集型的高并发 Web API 与业务聚合层
在典型的微服务中台或前端 BFF(Backend For Frontend)架构中,很多服务本身并不承担重型数学计算,其核心工作是“接收请求 -> 并行调用 3 个外部微服务 -> 查询 Redis 缓存 -> 组装 JSON 返回给客户端”。
在这类纯 I/O 密集型业务中,基于异步特性的 Python 服务能够展现出极其优异的性价比。借助 asyncio.gather 可以用几行清晰优雅的代码实现多个下游依赖的真正异步并行发起与汇总;而借助 Python 动态类型与字典处理能力,在处理异构数据聚合时的开发效率远超静态编译型语言。
场景三:业务探索期与快速验证的原型敏捷服务
当团队处于新业务上线验证期、商业模式尚在探索阶段时,“代码交付与需求变更速度”是系统的首要生命线。此时若过早引入具有高语法开销的静态编译架构,过多的类型定义、编译调试和冗长工程结构会显著延缓迭代节奏。
Python 极简的表达能力、丰富的开源库生态让开发者能在数小时内搭建起一套具备数据库交互、身份验证、第三方对接的完整微服务模块。更关键的是,依托 FastAPI 的 Pydantic 注解,在保证极高开发速度的同时,还能自动生成严格的 OpenAPI(Swagger)契约文档,为后续平滑迁移或跨团队协作打下良好基础。
场景四:自动化运维、DevOps 平台与基础设施工具链服务化
在现代企业基础设施建设中,许多内部运维自动化工具、CI/CD 自动化流水线调度平台、多云资源编排服务天然以 Python 为第一脚本语言。随着自动化逻辑的复杂度增加,零散的脚本往往需要演变为具备高可用、权限隔离和任务分发能力的微服务集群。
将原有运维逻辑与自动化脚本直接微服务化(封装为 FastAPI/Flask 微服务,配合 Celery 执行异地节点指令与资产巡检),无需重写底层调用模块,即可将脚本资产直接升级为企业级 API 平台。
三、何时不适合使用 Python 构建微服务?
工程技术选型从来不是单向的赞美,明确技术边界更能体现架构严谨性。以下三种场景应明确避开纯 Python 微服务架构:
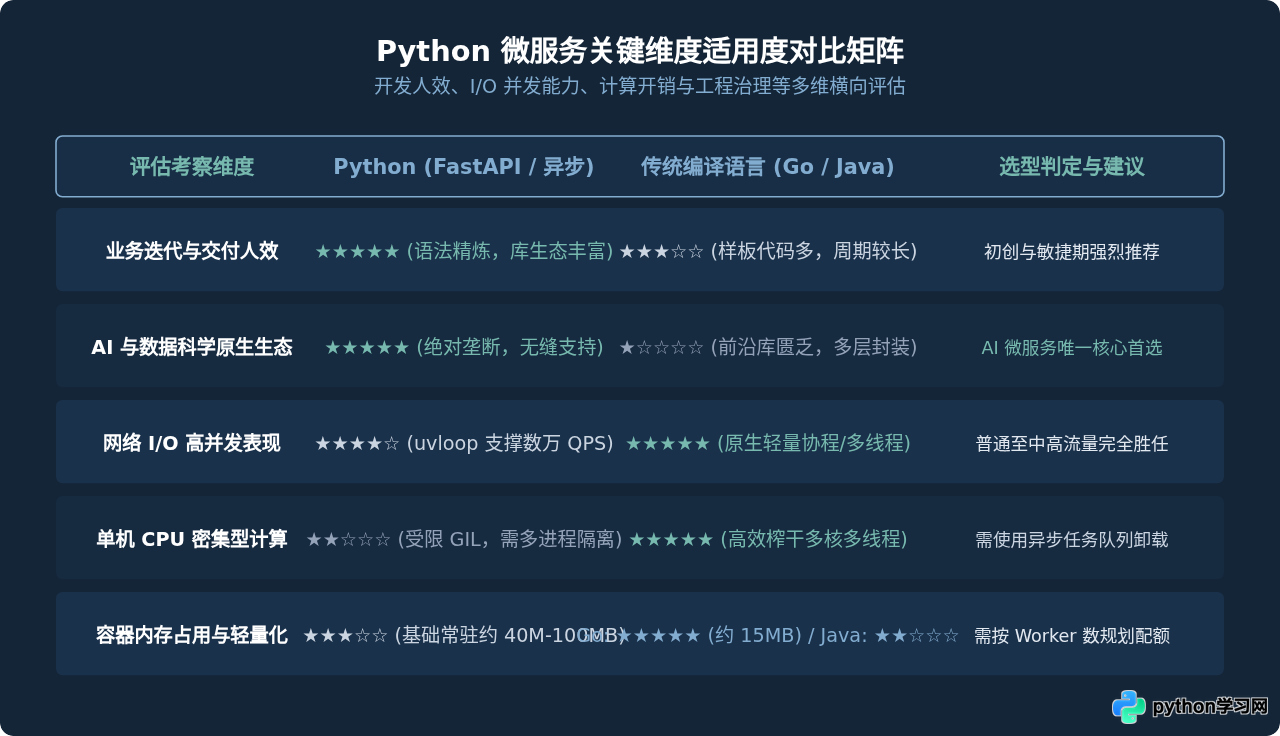
- 严苛的亚毫秒级低延迟与高频交易系统:虽然
asyncio极大优化了网络吞吐,但由于解释型运行特征与自动垃圾回收机制(GC),单次请求的耗时下限与稳定性无法媲美没有 GC 暂停的 Rust 或 C++。当系统 SLA 严苛要求 P99 响应耗时低于 1 毫秒时,Python 的运行时损耗无法被忽视。 - 单机纯 CPU 密集型的长计算任务:如果在 API 处理流程中需要直接进行巨型图片编解码、复杂的纯数学矩阵迭代运算,且不能调用底层封装良好的 C 语言加速库,单核 CPU 会瞬间被跑满并阻塞该进程的事件循环。在此类场景下,若不将计算拆入队列,直接使用 Python 构建微服务不仅吞吐低下,还会导致严重的健康检查超时。
- 超大规模跨部门协作且极度依赖静态编译期契约的巨型集群:在由成百上千名研发人员共同维护、微服务接口数万的巨型组织中,缺乏编译期强制约束的动态语言往往需要付出极高的单元测试覆盖率成本来防范拼写或字段变更隐患。此时 Java 或 Go 的强类型编译检查和严格契约管控更具管理确定性。
四、落地实践:架构设计与规避误区
决定采用 Python 构建微服务集群后,必须在工程实践中遵循以下三个核心原则,以避免常见的性能与稳定性隐患:
1. 运行时采用“Gunicorn 进程管理 + Uvicorn 异步 Worker”模型
生产环境中切忌直接以单进程模式运行 uvicorn app:app。推荐标准部署形态如下:
# 启动指令示例:根据 CPU 核心数启动对应数量的独立 Worker 进程
gunicorn -w 4 -k uvicorn.workers.UvicornWorker -b 0.0.0.0:8000 main:app --timeout 60
通过多 Worker 架构,每个 Worker 独享一个独立的 Python 解释器实例,能够充分榨干服务器的多核计算能力,同时某个 Worker 遇到意外崩溃时,Master 进程能够立即完成自愈重启。
2. 严防在异步主事件循环中混入同步阻塞调用
这是导致 Python 异步微服务性能雪崩最常见的原因。在 async def 定义的路由中,严禁调用未经异步封装的文件读写、标准 time.sleep() 或传统阻塞式 HTTP 客户端(如同步模式的 requests):
# 错误示例:阻塞整个 Worker 的事件循环,导致该进程其它所有请求挂起
@app.get("/bad-endpoint")
async def bad_case():
    time.sleep(2)  # 致命阻塞
    return {"status": "ok"}

# 正确示例:使用原生异步库,或将阻塞操作扔入线程池
@app.get("/good-endpoint")
async def good_case():
    await asyncio.sleep(2)  # 正确让渡执行权
    # 或者对于不可避免的传统阻塞 SDK:
    result = await asyncio.to_thread(sync_heavy_sdk_call)
    return {"status": "ok", "result": result}
3. 严格践行契约优先与全面类型注解
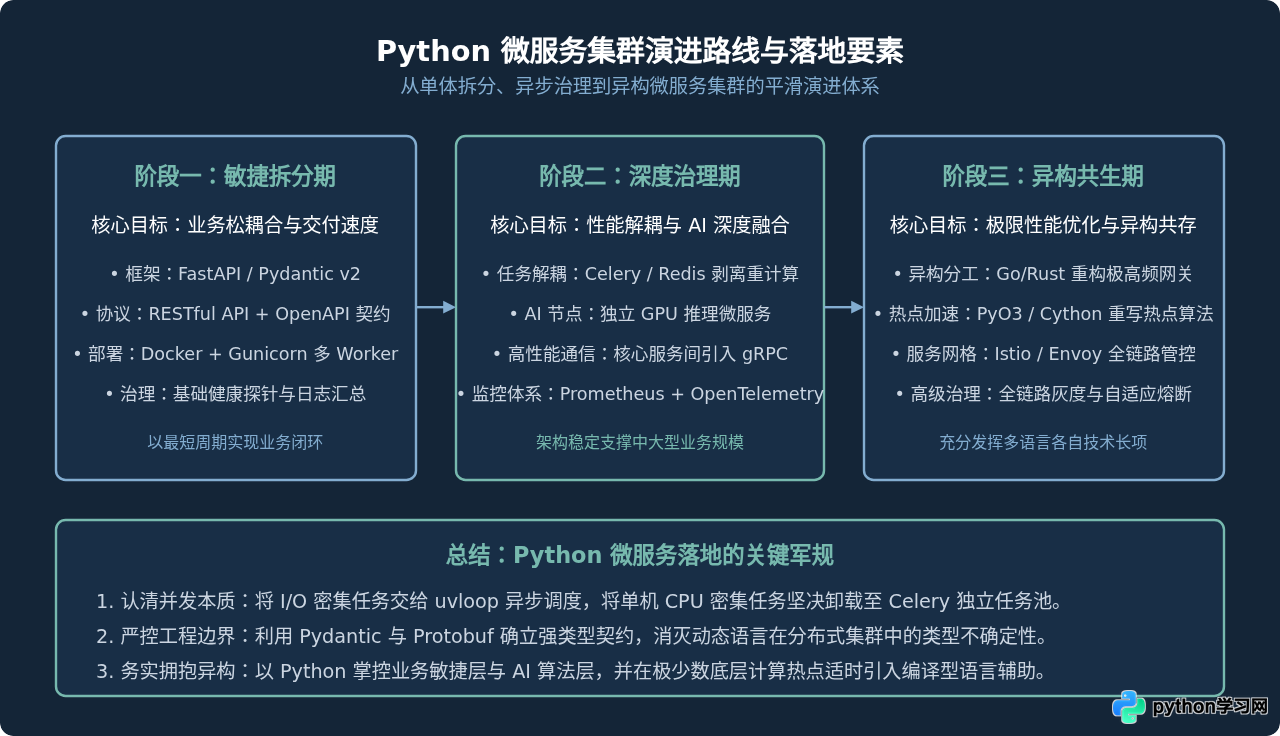
针对微服务间通信,应在团队内部强制开启 Python 3.10+ 类型标注。通过 Pydantic v2(底层采用 Rust 重构,校验性能较 v1 提升数倍)明确入参和出参的严格格式,或在微服务之间直接采用 gRPC / Protobuf 进行严格的二进制契约交互,从根本上解决动态语言在大型微服务协同中的类型不确定性。
五、总结
现代架构选型早已告别了单纯针对单机跑分测试的语言之争。软件工程最稀缺的往往不是几毫秒的极限 CPU 周期,而是开发团队将业务构想转化为稳定线上系统的交付速度与演进韧性。
只要系统满足“以 I/O 等待为主或强依赖 Python AI/数据生态”这一前提,充分利用现代 ASGI 异步框架与多进程容器调度,采用 Python 构建微服务集群不仅完全能够扛起高并发业务大梁,更能为企业在快速变化的技术竞争中提供无与伦比的人效优势与生态红利。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















