


Python中使用下划线忽略解包值的技巧
在 Python 中,解包(Unpacking)是一种将元组、列表或生成器中的元素一次性分配给多个独立变量的高效语法。然而在实际开发中,数据源往往包含许多冗余信息,比如函数返回的三元组中只关心首尾两项,或者遍历字典时只需要键而不需要值。如果给每一个不需要的元素都定义一个具体变量名,不仅会增加阅读负担,还会触发静态分析工具(如 Flake8、Pylint)的“未使用的局部变量”警告。使用单下划线 _ 或带星号的下划线 *_ 占位并显式忽略无用值,是 Python 社区约定俗成的标准解法。
一、单下划线 `_` 的基础单值忽略技巧
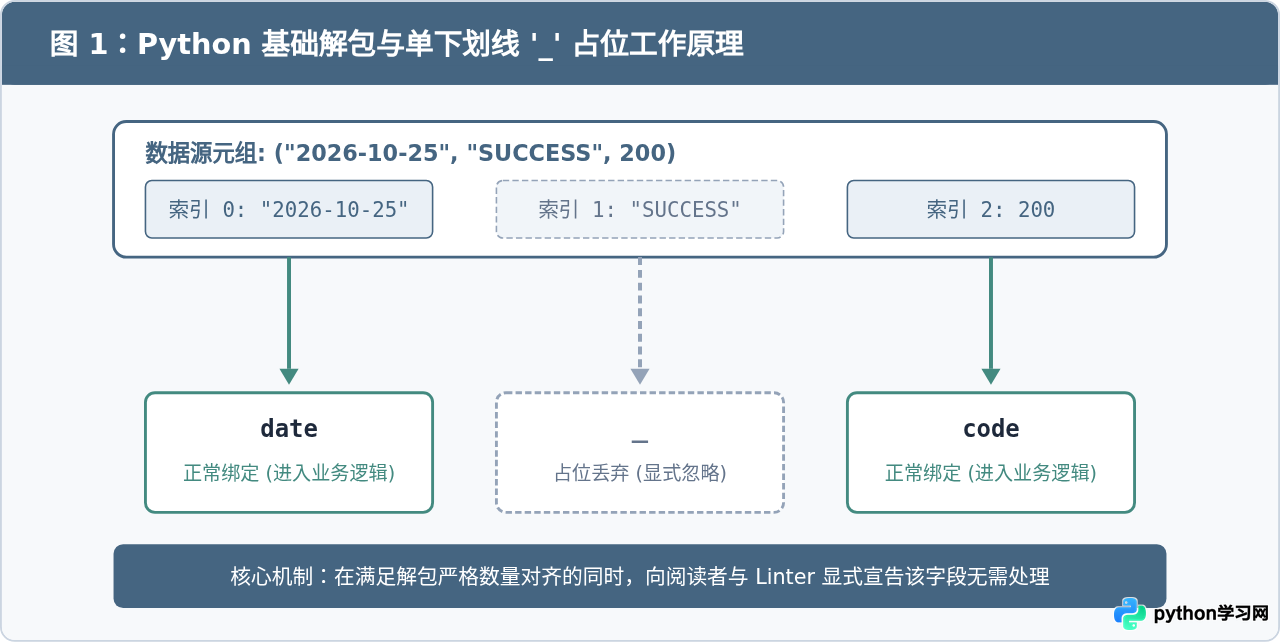
在 Python 语法定义中,单下划线 _ 是一个合法的标识符。这意味着从解释器的底层机制来看,_ 与常规变量名没有任何差异,它仍然会被分配引用并指向对应的对象。但在工程规范中,单下划线被赋予了专门的语义:“我知道这里有一个值,但我特意不使用它”。
1. 固定长度元组或列表的局部忽略
当可迭代对象的元素数量已知且固定时,变量名与元素必须一一对应。如果中间某个位置的数据不需要,可以使用 _ 顶替变量位置:
# 示例:获取数据记录,只关心日期和状态码,忽略中间的处理信息
record = ("2026-10-25", "SUCCESS", 200)
date, _, code = record

print(f"执行日期: {date}, 状态码: {code}")
# 示例输出:
# 执行日期: 2026-10-25, 状态码: 200
2. 函数与内置方法多返回值的针对性提取
许多标准库函数返回多元组,但在特定场景下调用方仅关心其中一项:
import os

# os.path.split 返回 (路径目录, 文件名)
# 场景:只需要文件名,丢弃父级路径
_, filename = os.path.split("/var/log/application/error.log")
print(f"目标文件: {filename}")
# 示例输出:
# 目标文件: error.log

# divmod 返回 (商, 余数)
# 场景:只需要确认是否能整除,即仅需要余数
_, remainder = divmod(105, 10)
print(f"余数: {remainder}")
# 示例输出:
# 余数: 5
3. 遍历循环中的键值与索引过滤
在 for 循环中,结合 enumerate() 或字典的 items() 方法时,使用下划线能清晰传达循环的处理维度:
# 仅需要索引计数,不需要元素本身
tasks = ["数据清洗", "特征工程", "模型训练"]
for index, _ in enumerate(tasks, start=1):
    print(f"正在准备第 {index} 个任务阶段...")

# 仅需要字典的键,虽然可用 .keys(),但在统一解包逻辑下使用 _ 同样清晰
settings = {"host": "127.0.0.1", "port": 8080, "timeout": 30}
for key, _ in settings.items():
    print(f"配置项名: {key}")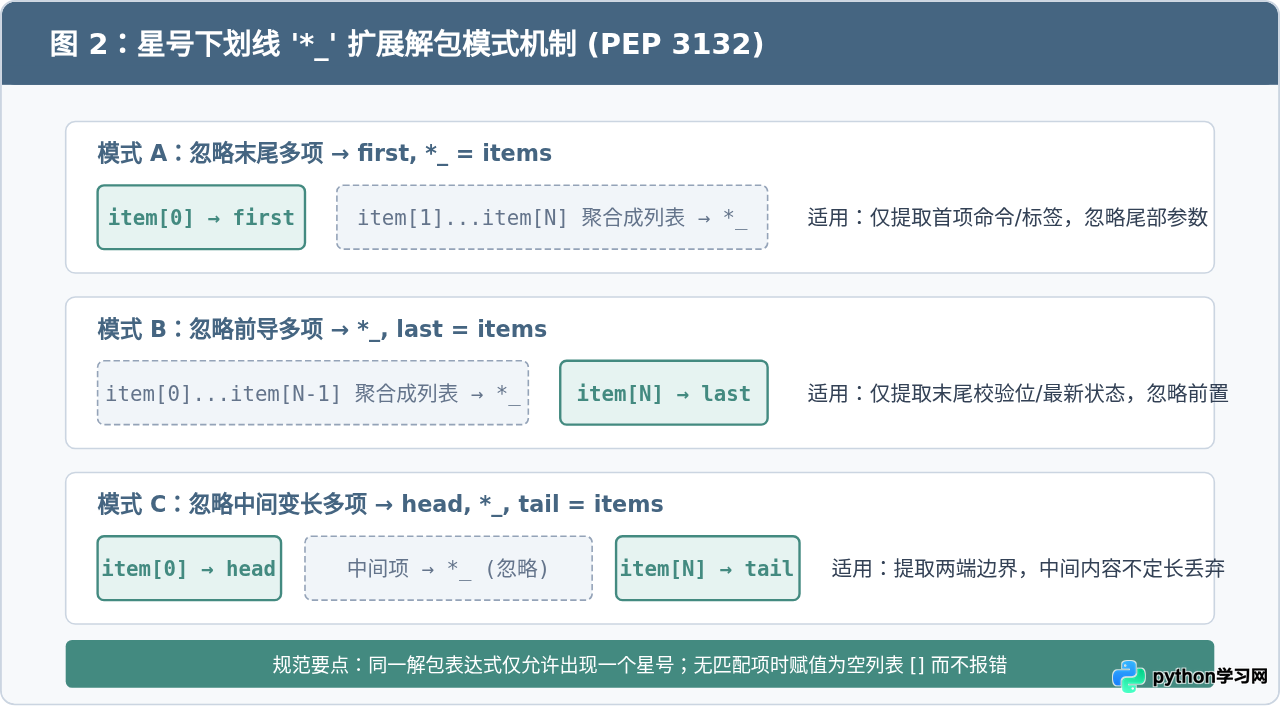
二、星号下划线 `*_` 的批量与变长忽略技巧
当解包序列的长度不确定,或者需要丢弃的元素不止一个时,使用单个 _ 就无法满足数量对齐的要求。Python 3 引入了 PEP 3132(扩展可迭代对象解包),允许在变量前添加星号 *。将星号与下划线结合为 *_,即可实现对任意数量剩余元素的贪婪收集与丢弃。
1. 批量忽略尾部元素(提取前缀)
在解析结构化日志、CSV 文本或命令行输入时,通常只需要前面的关键指令或首列字段:
line = "GET /api/v1/users HTTP/1.1 200 4096 0.024"
method, path, *_ = line.split()

print(f"请求方法: {method}")
print(f"请求路径: {path}")
# 示例输出:
# 请求方法: GET
# 请求路径: /api/v1/users
即使尾部有 3 个、5 个或更多字段,*_ 都会自动将它们聚合成一个列表并完成静默丢弃。
2. 批量忽略前导元素(提取后缀)
若需要从一段长序列中精准捕获最后几项,可以将 *_ 放置在最前面:
# 获取审计日志中的最新执行结果与操作人
log_tokens = ["2026-10-25", "17:40:00", "cluster-01", "worker-node", "op_backup", "SUCCESS", "admin"]
*_, status, operator = log_tokens

print(f"最终状态: {status}, 操作人员: {operator}")
# 示例输出:
# 最终状态: SUCCESS, 操作人员: admin
3. 忽略中间不定长内容(保留首尾边界)
当首尾结构确定但中间跨度未知时,将 *_ 放置在中间:
# 提取表格行的行头与校验尾项
table_row = ["ID_8091", "DataA", "DataB", "DataC", "CHECKSUM_OK"]
row_id, *_, checksum = table_row

print(f"行编号: {row_id}, 校验和: {checksum}")
# 示例输出:
# 行编号: ID_8091, 校验和: CHECKSUM_OK1. 当被解包的序列长度恰好等于非星号变量数量时,*_ 会成功匹配并绑定为空列表 [],不会抛出异常。
2. 同一个解包赋值语句中严禁出现两个及以上星号表达式(例如 a, *_, b, *_ = data),否则 Python 解释器在编译期会直接报出 SyntaxError: two starred expressions in assignment。
3. 如果序列总长度小于固定变量的需求量,仍会报出 ValueError: not enough values to unpack。
三、嵌套结构与高阶解包技巧
1. 嵌套元组与复合列表解包中的多层忽略
在复杂的领域模型或数据库 ORM 查询结果中,数据往往以树状或嵌套元组的形式存在。Python 允许在解包时使用括号保持结构对齐,下划线同样可以精确嵌入到子结构中:
# 用户数据结构:(用户ID, (姓名, 年龄, 部门), 注册时间)
user_payload = (1001, ("Alice", 28, "架构研发部"), "2026-10-01")

# 业务需求:只要 用户ID、姓名、部门,忽略 年龄 和 注册时间
uid, (name, _, dept), _ = user_payload

print(f"员工编号: {uid}, 姓名: {name}, 部门: {dept}")
# 示例输出:
# 员工编号: 1001, 姓名: Alice, 部门: 架构研发部
2. 嵌套结构与星号表达式组合
如果子序列中包含变长内容,还可以在嵌套括号内部使用 *_:
# 批处理作业:(批次ID, [任务1, 任务2, ..., 任务N], 触发模式)
batch = ("B-9981", ["clean", "validate", "transform", "load"], "CRON")

# 需求:只保留批次ID、首个任务和触发模式,忽略其余所有中间子任务
batch_id, (first_task, *_), trigger = batch

print(f"批次 {batch_id} 首个任务为: {first_task}, 触发源: {trigger}")
# 示例输出:
# 批次 B-9981 首个任务为: clean, 触发源: CRON
3. Python 3.10+ 模式匹配(match-case)中的通配忽略
在结构化模式匹配中,_ 不仅是命名惯例,而是升级为了真正的语言级软关键字(Wildcard Pattern)。在此处使用 _ 不会创建任何变量绑定,也不会占用任何命名空间:
def parse_command(event):
    match event:
        case ["CLICK", x, y]:
            return f"点击坐标: ({x}, {y})"
        case ["KEY_PRESS", key, _]:  # 忽略第三个参数(如修饰键状态)
            return f"按键: {key}"
        case ["HOVER", *_, target]:  # 忽略中间所有滑动轨迹,只取最终目标
            return f"悬停于: {target}"
        case _:
            return "未知事件类型"
四、易错陷阱与工程最佳实践
1. 陷阱一:解包后尝试读取 `_` 的值
如果在解包表达式中多次使用 _(例如 a, _, b, _ = (1, 2, 3, 4)),Python 解释器会按照从左到右的顺序依次为 _ 赋值。这意味着 _ 的最终值永远是最后一个被丢弃的值(在上例中为 4,而 2 已经被彻底覆盖丢失)。因此,永远不要在后续代码中引用 _,否则不仅极易引发静默逻辑错误,还会被团队审查工具严厉拦截。
2. 陷阱二:国际化库 `gettext` 的命名覆盖
在 Django、Flask 等 Web 框架或多语言项目中,标准做法是将国际化翻译函数导入为单下划线:
from django.utils.translation import gettext as _

# 此时 _ 是一个用于翻译字符串的可调用函数
print(_("Welcome back"))
如果在该作用域的某个函数内部编写了解包代码 _, status = get_data(),那么局部的 _ 就会由“翻译函数”被重新绑定为普通对象。当后续再次调用 _("Save") 时,将直接引发运行时异常:
TypeError: 'str' object is not callable在使用了 gettext as _ 的模块中,对解包丢弃的值应明确使用 _unused、__(双下划线)或带具体语义的弃用名(如 _dummy),坚决杜绝使用裸单下划线 _ 作为赋值目标。
3. 陷阱三:交互式环境(REPL / Jupyter)的特殊状态保存
在 Python 原生 REPL、IPython 或 Jupyter Notebook 中,变量 _ 默认具有特殊功能:自动保存上一条未赋值表达式的返回结果。如果在交互式单元格中运行了 x, _ = pair,就会破坏 REPL 的历史追溯机制。虽然这不影响生产脚本的独立执行,但在数据探索或交互调试阶段需要注意这一细微副作用。
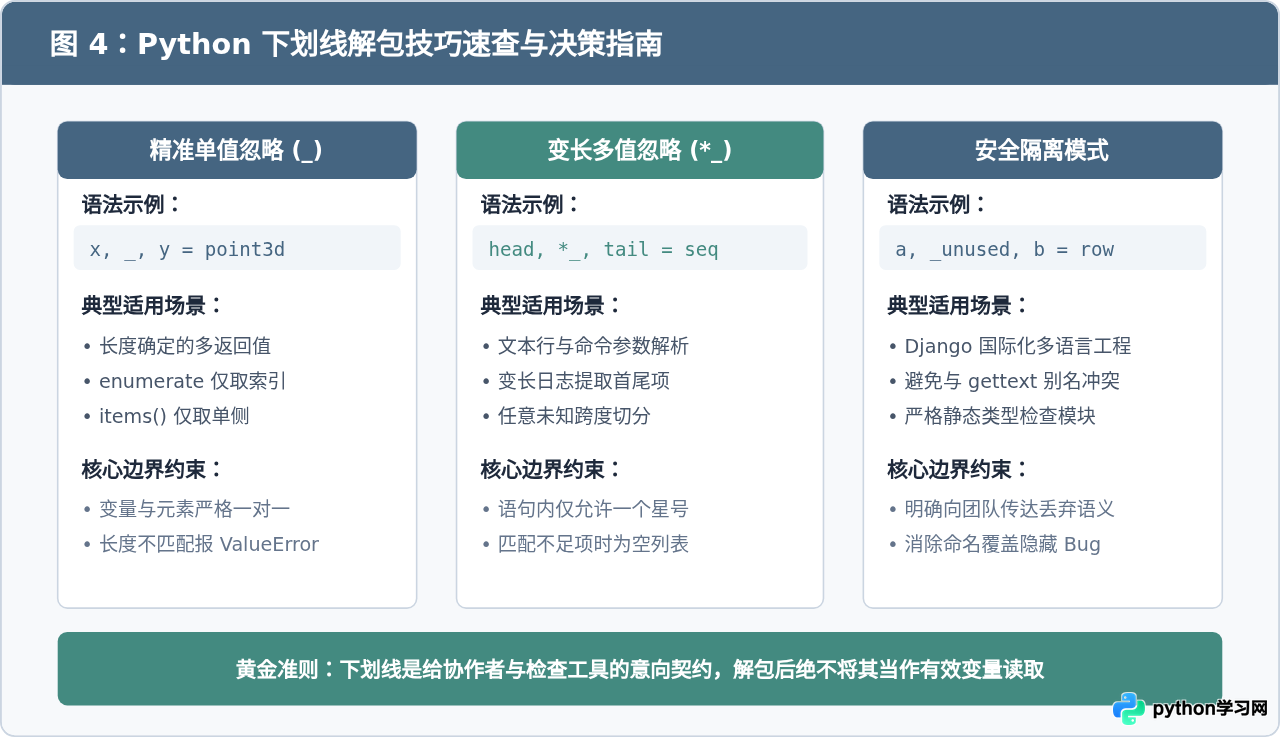
五、总结与编码规范推荐
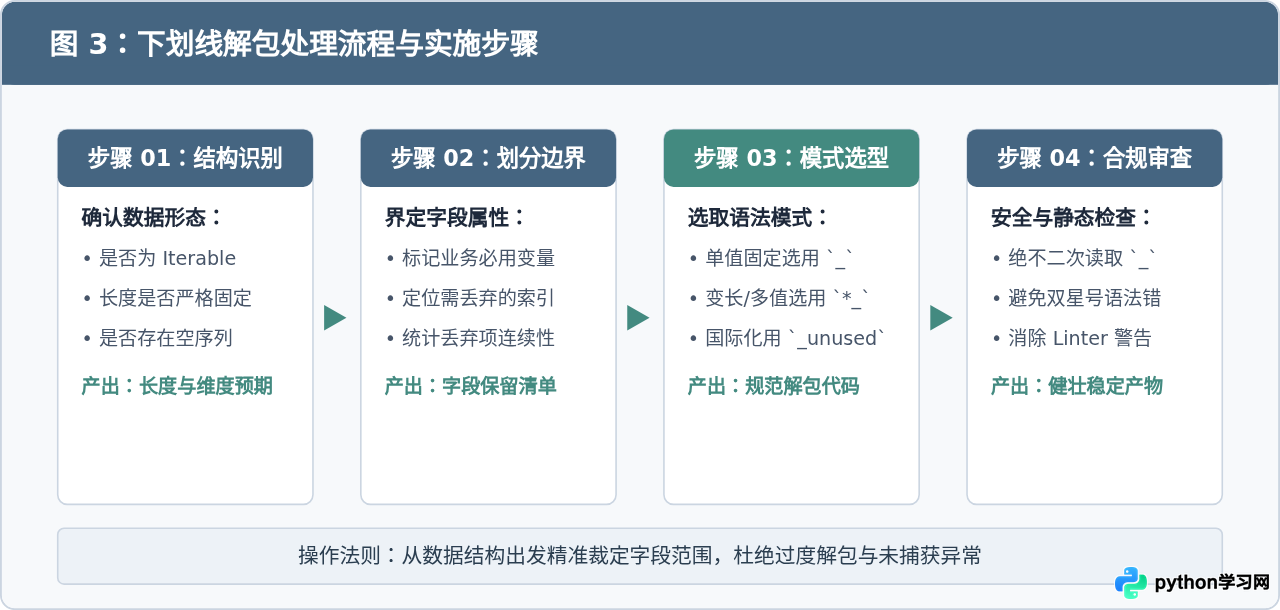
掌握下划线在解包中的用法,不仅能够大幅精简临时变量的声明,还能让代码的逻辑主干更为突出。在实际开发中,建议遵循以下工程原则:
| 场景类别 | 推荐写法 | 关键注意事项 |
|---|---|---|
| 已知数量的单一值丢弃 | first, _, third = tuple_data |
确保元素总数精确匹配,后续杜绝读取 _ |
| 变长序列或多元素丢弃 | head, *_, tail = list_data |
一个解包语句严禁出现多个星号表达式 |
| 国际化/多语言项目 | val, _unused = get_record() |
防止覆盖 gettext as _ 的全局翻译函数 |
| 多层嵌套结构提取 | id, (_, target), *_ = nested_data |
使用括号精确保持数据形态对齐,内部可嵌套使用 _ |
通过合理运用 _ 与 *_,你的 Python 代码不仅在执行层面高效可靠,在可维护性与规范性层面也将更具专业水准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















