


Python怎么对包含字典的列表按指定键排序
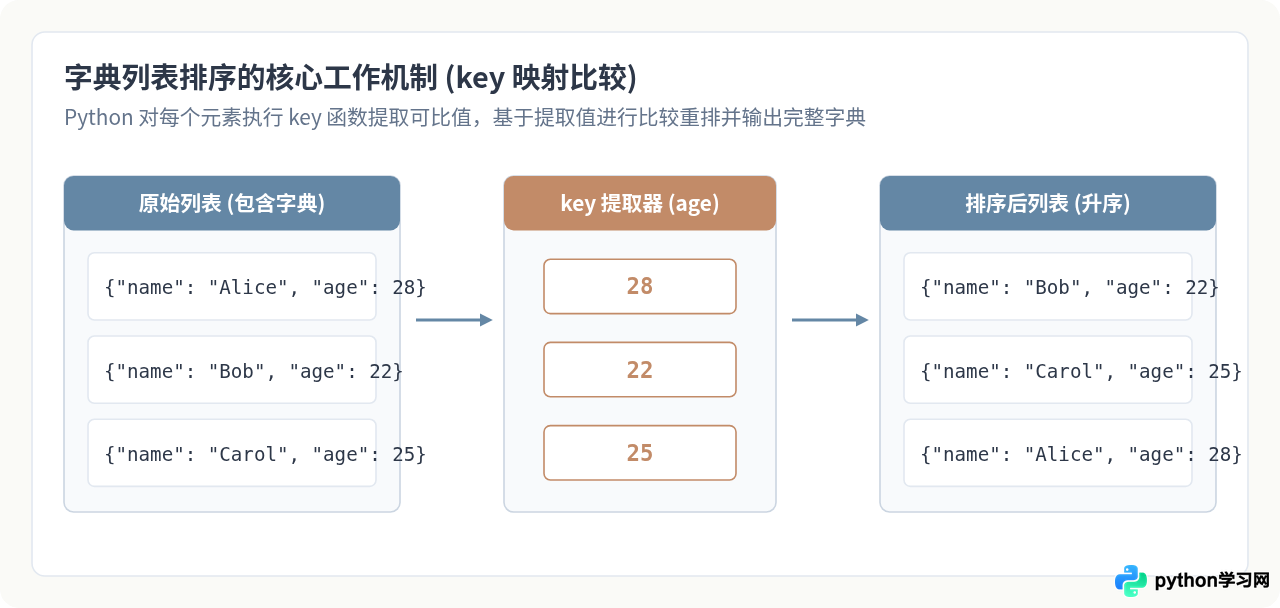
在 Python 开发中,我们经常使用列表嵌套字典的形式来组织成组的数据记录,例如从数据库、CSV 文件或 Web API 接口返回的多个对象。当需要对这些字典按某个属性进行排序时,最直接且标准的方法是利用 Python 内置的 sorted() 函数或列表对象的 sort() 方法,并传入 key 参数来指定提取排序依据的函数。掌握这一技巧能够高效、直观地处理日常数据清洗与业务呈现逻辑。
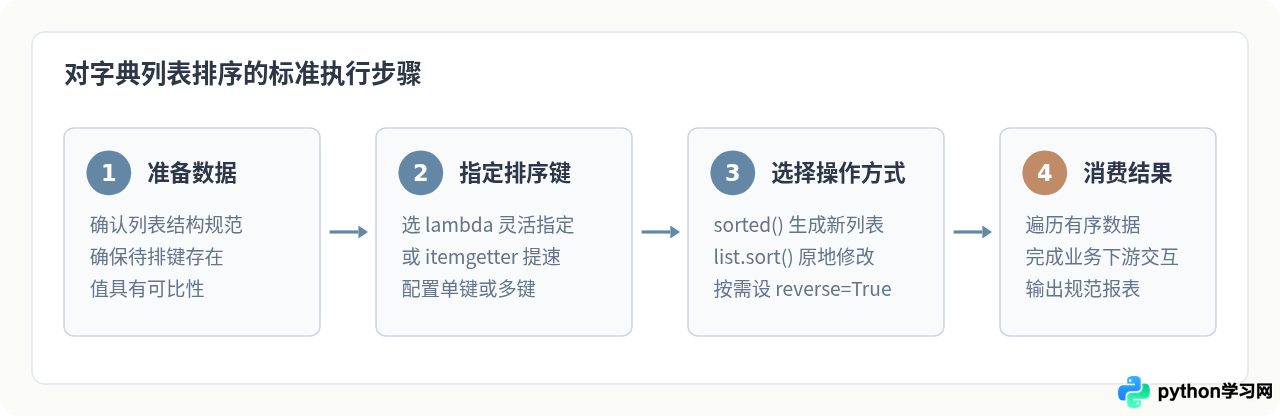
理解排序基石:sorted() 与 list.sort() 的区别
在编写排序代码前,首先需要确定是生成一个新的排序后列表,还是直接在原列表上进行修改:
sorted(iterable, key=..., reverse=...):内置函数,接收任何可迭代对象,返回一个全新的排序列表,原列表保持不变。适合需要保留原始数据顺序或对不可变序列排序的场景。list.sort(key=..., reverse=...):列表对象的成员方法,直接在原列表内部进行就地(in-place)排序,返回值为None。如果不需要保留原始列表,该方法能避免创建新列表,节约内存开销。
方法一:使用 lambda 表达式快速指定排序键
lambda 是 Python 的匿名函数,语法简练。在 key 参数中传入一个小型 lambda 函数,形如 lambda x: x['key_name'],即可指定以字典中的某个键作为排序比较的基准。
1. 单键升序排序(默认)
默认情况下,排序规则为从小到大升序排序。以下示例演示按学生的 score 字段进行排序:
students = [
    {"name": "张三", "score": 85},
    {"name": "李四", "score": 92},
    {"name": "王五", "score": 78}
]

# 使用 sorted() 返回新列表
sorted_students = sorted(students, key=lambda x: x["score"])

print("排序后结果:")
for s in sorted_students:
    print(s)
{'name': '王五', 'score': 78}
{'name': '张三', 'score': 85}
{'name': '李四', 'score': 92}
2. 单键降序排序(从大到小)
如果希望按从高到低排列(例如分数榜从高到低),只需在函数中额外设置 reverse=True 参数即可:
# 按 score 降序排列
desc_students = sorted(students, key=lambda x: x["score"], reverse=True)
方法二:使用 operator.itemgetter 高效排序
Python 标准库的 operator 模块提供了 itemgetter 函数。与 Python 解释器执行的 lambda 相比,itemgetter 在 C 语言层面上实现了字段提取,执行速度更快,且语法更为清晰,是生产环境中更推荐的做法。
1. 单键排序示例
from operator import itemgetter

products = [
    {"name": "键盘", "price": 299},
    {"name": "鼠标", "price": 99},
    {"name": "显示器", "price": 1299}
]

# 按价格从低到高排序
sorted_products = sorted(products, key=itemgetter("price"))

# 原地排序示例
products.sort(key=itemgetter("price"))
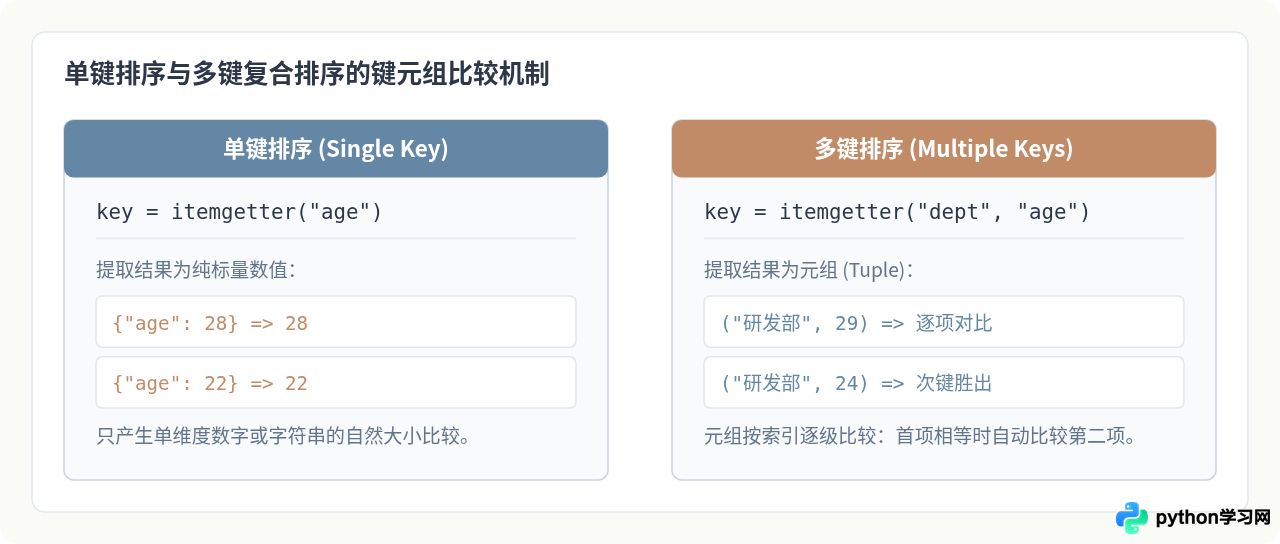
2. 多键复合排序(先按键A,再按键B)
当面临复杂业务时,例如“先按部门排序,同一部门内再按年龄排序”,itemgetter 可以直接接收多个参数:
from operator import itemgetter

staff = [
    {"dept": "研发部", "age": 29, "name": "王工"},
    {"dept": "市场部", "age": 25, "name": "李经理"},
    {"dept": "研发部", "age": 24, "name": "小赵"},
    {"dept": "市场部", "age": 30, "name": "周总监"}
]

# 先按 dept 升序,dept 相同的记录再按 age 升序
sorted_staff = sorted(staff, key=itemgetter("dept", "age"))

for s in sorted_staff:
    print(f"[{s['dept']}] {s['name']} - {s['age']}岁")
[市场部] 周总监 - 30岁
[研发部] 小赵 - 24岁
[研发部] 王工 - 29岁
常见问题与实用防御技巧
1. 字典中可能缺失排序键(KeyError 防御)
在真实业务数据中,某些字典可能缺少目标键。如果直接使用 x['key'] 或 itemgetter('key'),程序会抛出 KeyError 异常而中断。
此时应改用字典的 .get(key, default) 方法,并设定合理的缺省兜底值:
items = [
    {"name": "A", "priority": 10},
    {"name": "B"},  # 缺少 priority 键
    {"name": "C", "priority": 5}
]

# 缺失键时默认赋予极小值(排在最前)或极大值(排在最后)
safe_sorted = sorted(items, key=lambda x: x.get("priority", 0))
2. 多键排序时一个升序、一个降序
reverse=True 是对整个排序结果生效的,无法单独指定第一个键升序、第二个键降序。若其中某个键是数值类型(如年龄或价格),可以利用数值取反的小技巧达成差异化排序:
# 部门按字母/字典序升序,部门相同时薪资按降序(-x['salary'])排列
sorted_mix = sorted(staff, key=lambda x: (x["dept"], -x["salary"]))
注意: Python 的排序算法(Timsort)是稳定排序(Stable Sort)。这意味着如果两个字典在指定键上的值相同,排序后它们原有的相对先后次序百分之百保持不变。
总结与方案选型
针对“对包含字典的列表按指定键排序”这一问题,可根据项目具体需求选择最恰当的实现方案:
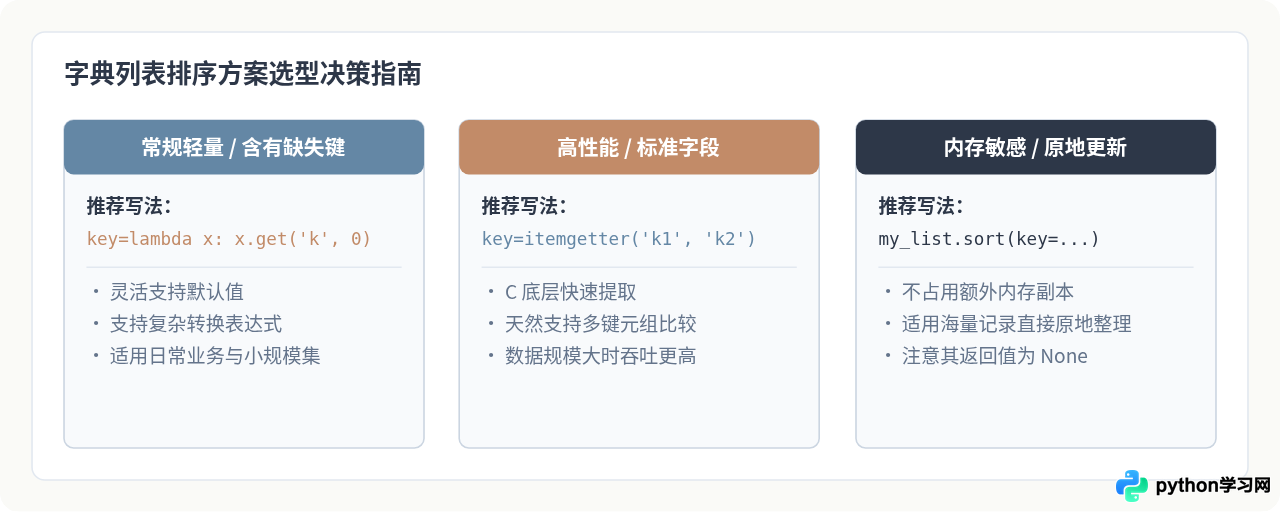
只要紧扣 key 参数的用法,并结合 reverse=True 与 itemgetter,即可优雅、高效地应对 Python 中各种包含字典的列表排序需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















