


Python代码封装基础:从函数、模块到包的层级设计
编写 Python 程序时,随着业务逻辑的扩充,单文件脚本往往会迅速膨胀,引发变量命名冲突、重复逻辑扩散以及定位 Bug 成本剧增等问题。代码封装的核心目标,是通过划分清晰的边界将实现细节隐藏在内部,仅对外暴露稳定一致的接口。在 Python 中,这一能力是通过“函数、模块、包”三个由低到高、由局部到系统的抽象层级实现的。本文将直接切入这三个层级的核心设计,从语法机制、组织模式到实际项目重构,系统说明如何搭建易维护、高内聚的 Python 代码架构。
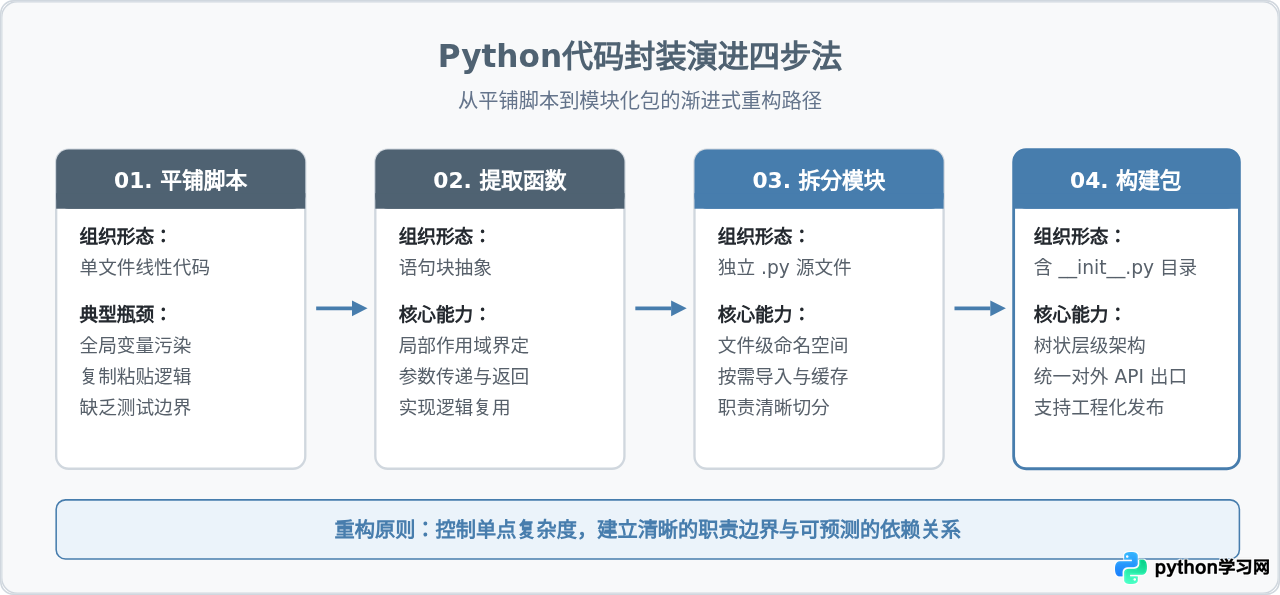
一、第一层级:函数封装——消除重复与界定单一职责
函数是 Python 代码组织的最基本砖瓦。将一组语句包裹在 def 语句块中,不仅消除了重复代码,更在程序运行时划定了一个隔离的局部作用域(Local Scope)。
1. 单一职责与可读性
设计良好的函数应当遵守单一职责原则(Single Responsibility Principle):一个函数只做一件事,且将其做到完整。当一个函数内部既包含文件读取、格式校验,又包含数据清洗和数据库写入时,任何一处需求变更都会带来不可预期的风险。将多步骤逻辑拆分成专注的小函数,能够大幅降低调试成本并提升可读性。
# 规范做法:将校验与清洗拆分为职责单一的函数
def validate_email(email: str) -> bool:
    """校验邮箱地址基础格式,仅返回布尔值结果"""
    if not email or "@" not in email:
        return False
    user, domain = email.split("@", 1)
    return bool(user) and "." in domain

def clean_user_data(raw_data: dict) -> dict:
    """清洗用户数据并输出结构化字典,依赖 validate_email 进行校验"""
    raw_email = raw_data.get("email", "").strip().lower()
    if not validate_email(raw_email):
        raise ValueError(f"邮箱格式无效: {raw_email}")
    return {
        "username": raw_data.get("username", "").strip(),
        "email": raw_email,
        "is_active": True
    }
2. 局部作用域与防范副作用
在函数内部赋值的变量默认被约束在函数生命周期内,函数调用完毕后即被销毁,避免了全局命名空间被临时变量污染。在处理列表、字典等可变对象作为入参时,必须警惕无意的原地修改(In-place Mutation)。推荐遵循“纯函数”思维:接收输入,产生新的输出对象并返回,不产生隐蔽的外部副作用。
3. 函数封装的局限性
当一个项目包含数十个函数,且不同功能分别服务于数据处理、网络通信与用户界面时,如果继续将它们塞在一个 .py 文件中,文件体积将迅速突破千行。此时函数之间的关联性会被稀释,寻找特定代码如同海底捞针。这就要求我们将代码上升至第二层级——模块。
二、第二层级:模块封装——文件维度的逻辑隔离与复用
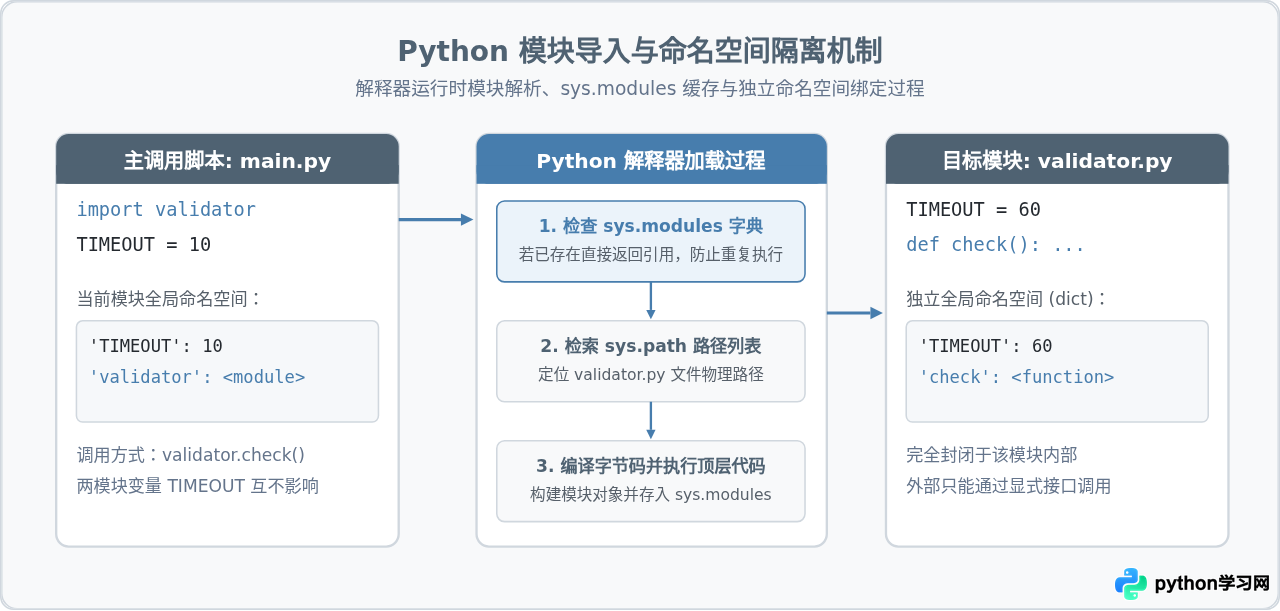
在 Python 中,每一个物理文件 *.py 都是一个独立的模块(Module)。模块不仅提供了物理层面的文件隔离,更在运行时提供了独立的全局命名空间(Global Namespace)。
1. 模块的命名空间与导入语法
每个模块都拥有独享的命名空间。即使两个模块中定义了完全同名的全局变量或函数(例如均声明了全局变量 TIMEOUT),只要通过模块名限定,就绝不会发生污染冲突。
Python 中常见的两种导入语法:
- 模块级导入:
import validator。使用时写为validator.clean_user_data()。这种方式明确标明了符号的归属,可读性高,能有效避免命名冲突,是工业级工程中推荐的默认写法。 - 符号级导入:
from validator import clean_user_data。直接将函数导入当前模块的作用域。调用更简洁,但如果导入大量同名符号容易引起覆盖,应谨慎使用。绝对禁止使用from validator import *,这种通配符导入会模糊符号来源并严重污染当前作用域。
2. 模块独立自测:if __name__ == '__main__':
模块既可以作为依赖库被其它文件 import,也可以直接作为脚本执行。Python 解释器在直接运行某文件时,会将该模块的内置变量 __name__ 赋值为 '__main__';而若该文件被导入,__name__ 则为该模块的实际名称。借助这一机制,可以在模块末尾放置该模块的独立执行与单元测试代码:
# 文件名: validator.py

def validate_phone(phone: str) -> bool:
    """校验国内手机号格式"""
    return len(phone) == 11 and phone.startswith("1") and phone.isdigit()

if __name__ == "__main__":
    # 当直接执行 python validator.py 时运行以下测试
    print("正在执行 validator.py 自检测试...")
    assert validate_phone("13800138000") is True
    assert validate_phone("99999") is False
    print("自检测试全部通过!")
当 main.py 导入 validator 时,上述测试逻辑会自动跳过,保证了库代码的高效与纯粹。
三、第三层级:包的设计——目录维度的体系化架构
当系统进一步复杂化,拆分出几十个 .py 文件时,如果全部并列存放在项目根目录中,文件系统就会变得混乱。包(Package)是 Python 组织多模块树状结构的核心机制。
1. 包与 __init__.py 的核心职责
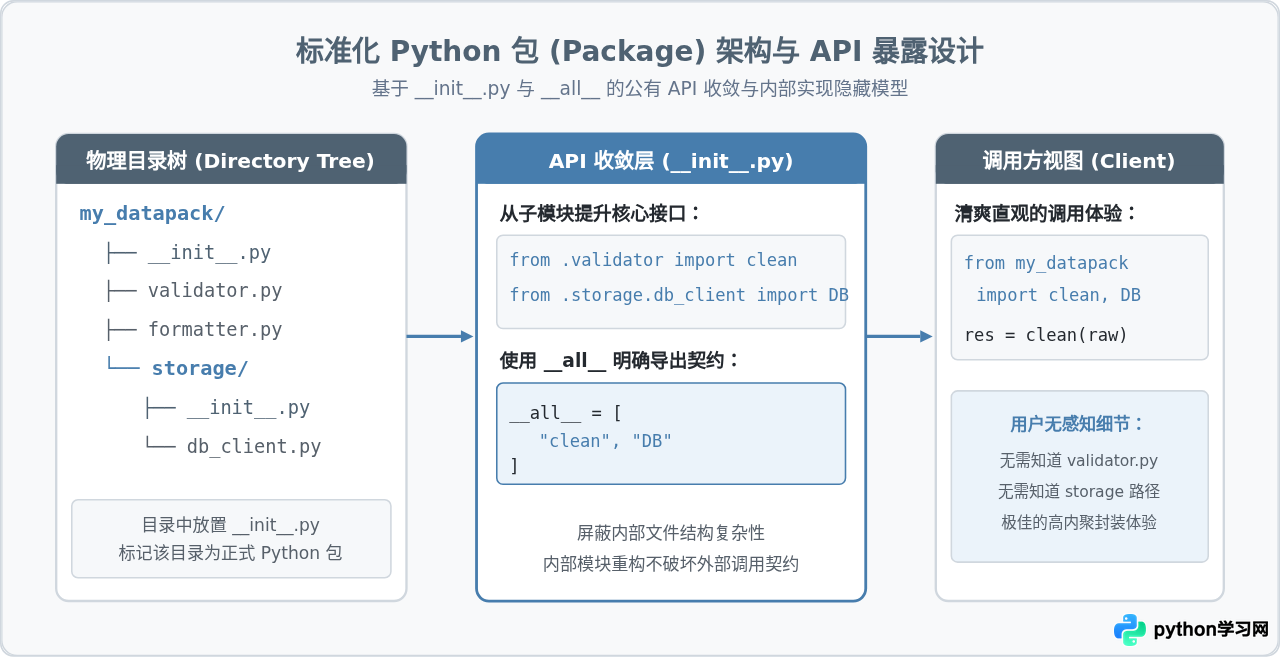
在物理文件系统中,只要一个文件夹下包含 __init__.py 文件,Python 就会将其识别为一个正规包(Regular Package)。当执行 import my_datapack 时,该目录下的 __init__.py 将首先被解释执行。
在现代 Python 工程规范中,__init__.py 应当保持轻量,切忌堆砌业务实现。其主要职责为:
- 聚合与向上提升公共 API:通过相对导入,将深层子模块中零散的类与函数提升到顶层包命名空间,降低调用者的心智负担。
- 维护
__all__白名单:显式声明包支持外部访问的接口。不在__all__中的内部辅助函数或私有类,向使用者传递出“请勿外部依赖内部实现”的清晰信号。
# my_datapack/__init__.py 的规范实现
from .validator import clean_user_data, validate_email
from .storage.db_client import DatabaseClient

# 明确导出契约
__all__ = [
    "clean_user_data",
    "validate_email",
    "DatabaseClient",
]
2. 相对导入与绝对导入的抉择
在包的内部各模块相互依赖时,有两种导入路径方案:
- 绝对导入(Absolute Import):从项目顶级搜索路径(sys.path)写出完整模块路径,例如
from my_datapack.validator import validate_email。路径直观清晰,全局全局检索容易,是官方推荐的导入方式。 - 相对导入(Relative Import):以当前模块位置为基准,使用单个点
.表示当前目录,双点..表示上层父目录。例如在formatter.py中编写from .validator import clean_user_data。相对导入在包名更名或整体搬迁时更加灵活。
python my_datapack/formatter.py 执行!因为独立执行脚本时,Python 会将该文件视为主模块 __main__,丢失了其所属的包上下文环境,进而触发 ImportError: attempted relative import with no known parent package。正确的运行方式是在项目根目录下通过模块模式运行:python -m my_datapack.formatter。
四、封装层级特性对比与设计选型
在日常开发中,究竟应当在何时抽取函数、何时建立模块、何时打包成目录?下表对三者的核心特征进行了系统梳理:
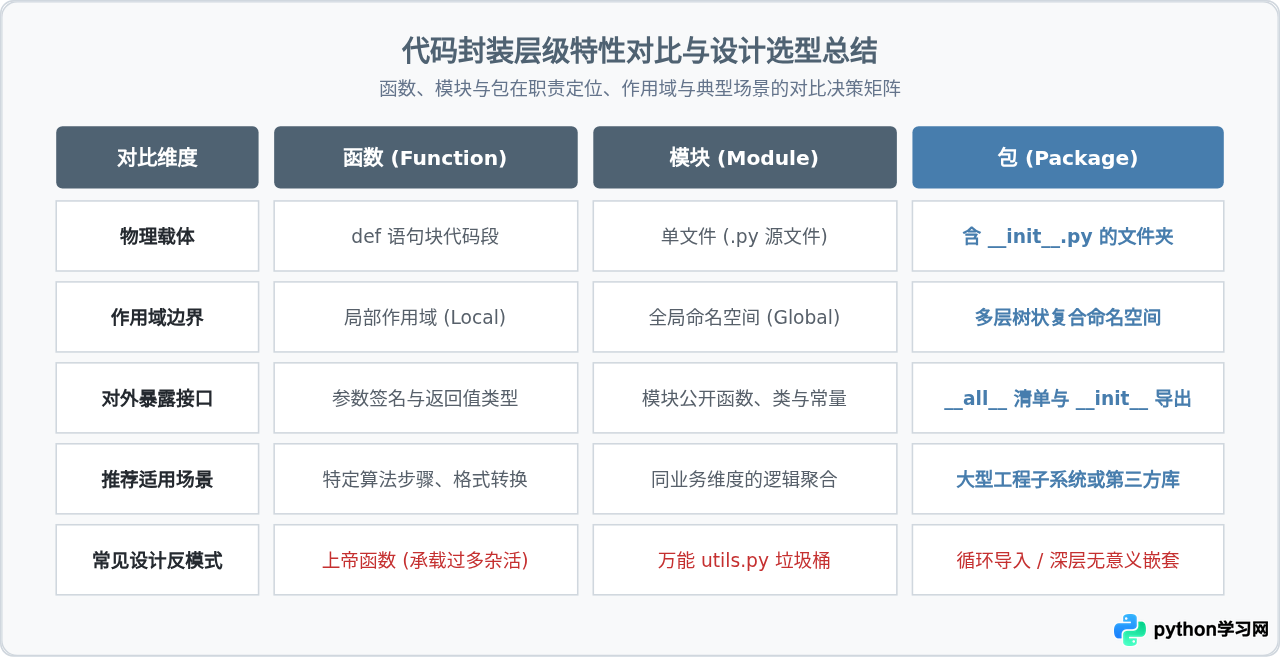
1. 渐进式重构实践准则
- 拒绝过早过度封装:在项目刚起步时,不要盲目创建繁琐的深层子包。遵循“先写成函数,再按聚类拆成模块,规模扩大后再归类入包”的自然演进过程。
- 警惕
utils.py陷阱:开发者常常习惯于建立一个名为utils.py的模块,将所有无处安放的函数都塞进去,最终使其沦为臃肿失控的“代码垃圾场”。更规范的做法是按功能语义命名拆分,例如string_tools.py、datetime_helpers.py。
2. 彻底终结循环导入(Circular Import)
当模块 A 在顶层写了 from module_b import func_b,而模块 B 的顶层又写了 from module_a import func_a 时,Python 在初始化加载未完成的模块对象时就会抛出 ImportError: cannot import name ...。消除循环导入的标准工程方案包括:
- 抽取公共底层依赖:识别引起循环依赖的核心数据结构或常量,将其剥离下沉至更底层的
types.py或constants.py中,使依赖拓扑图呈现健康的单向有向无环图(DAG)。 - 延迟导入(Lazy Import):仅在特定函数的执行体内部执行
from module_b import func_b,避开模块初始化阶段的相互等待。虽然这是有效救急手段,但从长远来看,重构依赖关系才是根本之道。
五、常见问题排查与总结
在日常管理包和模块时,最频繁遇到的错误是 ModuleNotFoundError: No module named 'xxx'。排查该问题的关键在于理解 Python 解释器的检索原理:
- Python 是根据
sys.path包含的路径列表按先后顺序查找模块的。执行脚本时,脚本所在目录会被自动加入sys.path[0]。 - 若脚本身处多层子目录下,直接执行往往找不到项目根目录下的同胞包。解决办法是在项目根目录下使用模块命令启动程序:
python -m my_datapack.validator,或在环境变量中设置PYTHONPATH=.。
总而言之,从函数对执行语句的抽象,到模块对文件全局命名空间的界定,再到包对工程目录与统一 API 的治理,Python 提供了严谨且极具弹性的代码分层设计能力。在实际开发中,保持边界意识,让每个层级各司其职,是写出优雅、稳定且易于演进的高质量工程项目的核心基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















