


Python字符串切片高频面试题合集:逻辑陷阱与最优解
在 Python 技术面试中,字符串切片语法 s[start:stop:step] 看起来基础,却因其特有的默认缺省值、开闭区间界定、正负步长方向反转以及底层内存拷贝机制,衍生出大量考察候选人逻辑严密性的陷阱题。本文直接围绕高频核心考点展开,剖析底层运行逻辑,指出容易失误的边界盲区,并给出生产环境下的规范解法与最优实践。
一、核心模型:三参数机制与开闭区间规则
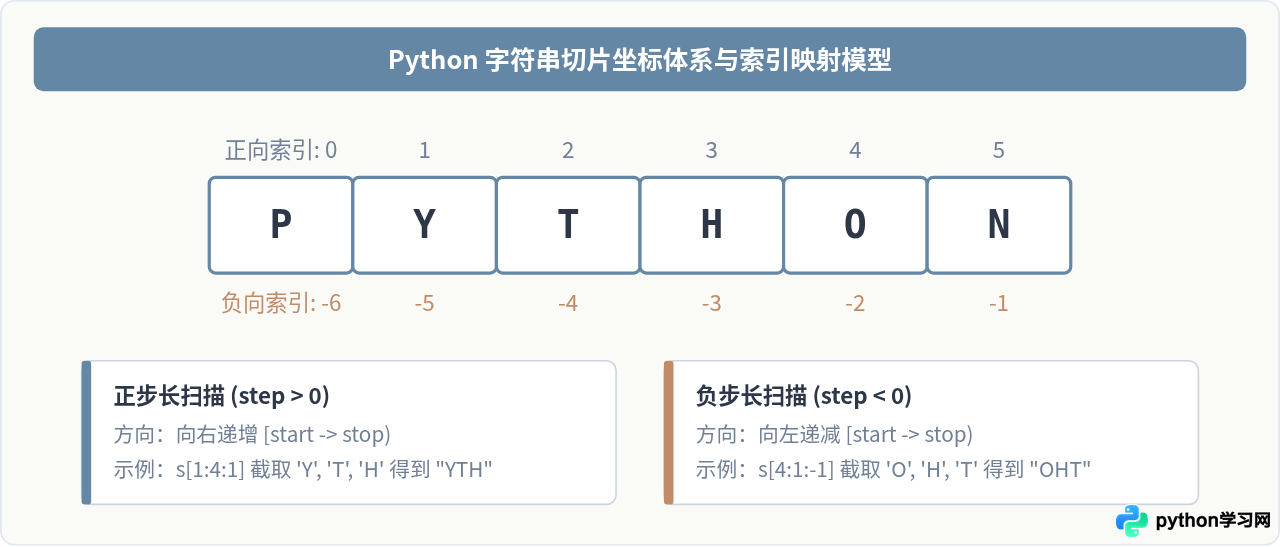
理解切片逻辑的起点在于明确 [start:stop:step] 内部的指针含义。切片始终遵循左闭右开区间(包含 start 对应的字符,但不包含 stop 对应的字符)。更为关键的是,步长 step 的正负号决定了遍历指针的位移方向:
- 当
step > 0时:遍历方向为从左向右(正向递增)。如果未显式提供start,默认指向索引0;如果未显式提供stop,默认延伸至序列末尾(包含最后一个字符)。 - 当
step < 0时:遍历方向为从右向左(反向递减)。此时如果未显式提供start,默认指向序列末尾最后一个元素;如果未显式提供stop,默认向左穿过索引0(包含首字符)。
在索引坐标系中,正向索引从 0 递增到 length - 1,负向索引从 -1 向左递减到 -length。切片操作将正负索引无缝融合,但在负步长下如果不重设开闭区间,极易导致切片输出为空。
二、高频题一:索引越界为什么不报 IndexError?
在面试中经常遇到这样一个经典对比提问:
s = "python"
print(s[100])      # 抛出 IndexError: string index out of range
print(s[10:100])    # 正常运行,输出空字符串 ""
print(s[:1000])     # 正常运行,输出完整字符串 "python"
1. 底层逻辑:单下标寻址与切片区间截断的区别
单下标索引 s[i] 的语义是精确获取指定位置的单个元素。Python 必须保证下标处于合法偏移量区间 [-len, len-1] 内,超出范围意味着存在逻辑错误,因此选择立即抛出 IndexError,防止错误数据悄无声息地流入下游逻辑。
而切片 s[start:stop] 的语义是提取指定范围内的所有存在元素。在 CPython 的底层实现中(参考源码中的 PySlice_GetIndicesEx 函数),切片边界计算遵循宽容的边界约束逻辑:
- 若
start >= length且步长为正,start会被强制收敛为length; - 若
stop > length,stop会被截断为length; - 若
start < -length,它会被规整为0; - 如果调整后的区间在扫描方向上满足
start >= stop(正步长)或start <= stop(负步长),循环无法执行,底层直接返回一个空序列。
text[:max_len],无需额外编写 if len(text) > max_len 判断。
三、高频题二:反转字符串的经典陷阱与负步长推导
考官通常会先询问 s[::-1] 的执行过程,随后给出一个具体区间陷阱题:s = "python",请问 s[4:1:-1] 与 s[1:4:-1] 分别返回什么?
1. 为什么 s[1:4:-1] 返回空字符串?
分析切片代码时,必须优先看 step 的符号,而不是先看 start 和 stop:
- 检测到
step = -1,确定遍历指针向左位移。 start = 1(对应字符'y'),stop = 4(对应字符'o')。- 向左移动时,指针索引只会越来越小(从 1 变成 0,再到负数),永远不可能抵达位于右侧的终止边界
stop = 4。 - 循环终止条件立即触发,切片过程一步未走,最终返回
""。
2. s[4:1:-1] 的执行推导步骤
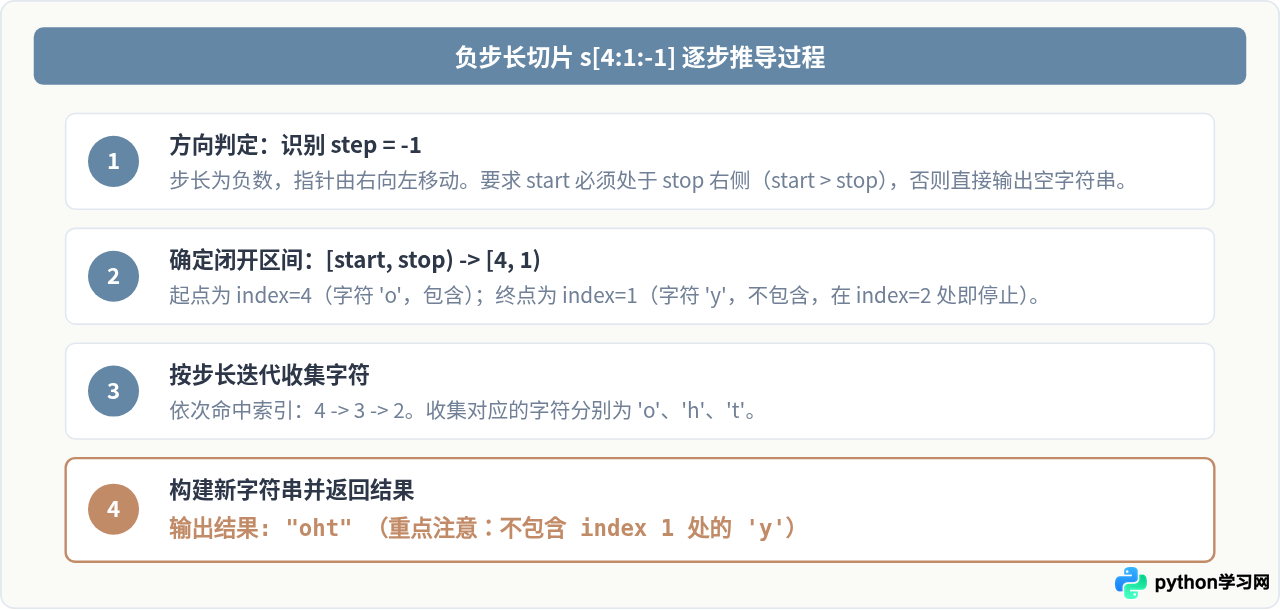
只有当 start > stop(在正向数值上)时,负步长才能截取到内容。以 s = "python", s[4:1:-1] 为例,其逐帧执行过程如下:
四、高频题三:硬编码切片 vs slice 命名对象的工程实践
许多初学者只知道 s[2:8] 的语法糖,但在处理结构化定长数据解析(例如银行对账文件、定长报文、硬件协议包)时,散落在代码各处的魔数切片会导致极差的可维护性。
1. 内置 slice 对象的使用
切片操作符 s[a:b:c] 在 Python 底层会被解析为 s.__getitem__(slice(a, b, c))。我们可以直接使用内置函数 slice(start, stop, step) 创建切片对象:
# 传统硬编码切片方式(反模式:魔数难以理解与维护)
record = "20261026USER_882991SUCCESS"
date_str = record[0:8]
user_id  = record[8:19]
status   = record[19:26]

# 最优工程解法:使用命名 slice 对象解耦
DATE_FIELD = slice(0, 8)
USER_FIELD = slice(8, 19)
STATUS_FIELD = slice(19, 26)

# 复用切片对象
date_str = record[DATE_FIELD]
user_id  = record[USER_FIELD]
status   = record[STATUS_FIELD]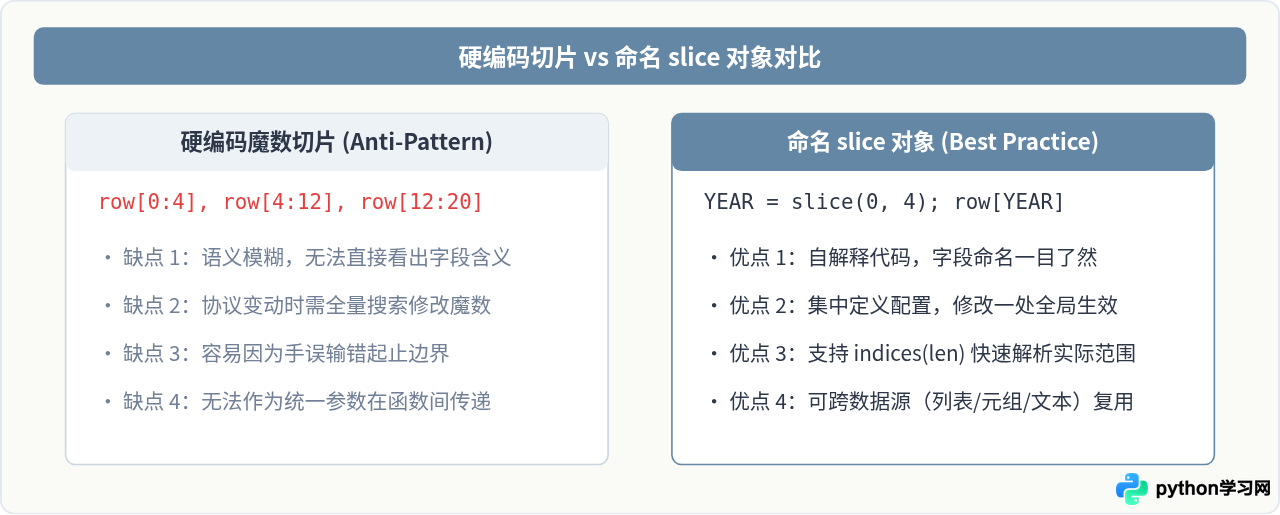
五、高频题四:切片内存机制与深浅拷贝陷阱
面试深度问题:“Python 字符串切片是浅拷贝吗?如果对一个 1GB 大小的字符串执行 s[:100],会占用多少额外内存?”
1. 字符串的不可变性与全新对象创建
在 Python 中,字符串属于不可变序列(immutable sequence)。当对字符串执行切片操作时:
- 切片操作会申请一块新的连续内存,将截取范围内的字符字节复制过去,并构建一个全新的
str对象返回。 - 因此,
s[:100]并不是原字符串的“引用视图”,而是真实的数据物理拷贝。即便在某些情况下发生小字符串驻留(interning),其语义本质仍为创建独立对象。 - 如果原始字符串大小为 1GB,而切片仅截取前 100 字节,新对象只会占用约 100 字节(加上 Python 对象头开销约 48 字节),不会复制完整的 1GB 数据。
2. 超大文本切片性能陷阱:避免循环内盲目切片
在字符串处理或网络封包解析场景中,如果在一个高频循环里反复执行 data = data[chunk_size:],虽然语义直观,但会导致严重的内存抖动和 $O(N^2)$ 的时间复杂度,因为每一次切片都会分配新内存并复制剩余的全部字符。
# 低效写法:每次循环都产生切片物理拷贝,耗时剧烈增长
def parse_chunks_slow(payload: str, chunk_size: int):
    while payload:
        chunk = payload[:chunk_size]
        process(chunk)
        payload = payload[chunk_size:]  # 每次复制剩余全部字符串!

# 最优解一:只移动索引指针(时间复杂度 O(N),零内存冗余)
def parse_chunks_fast(payload: str, chunk_size: int):
    total = len(payload)
    for start in range(0, total, chunk_size):
        chunk = payload[start:start + chunk_size]
        process(chunk)

# 最优解二:针对 bytes 二进制流使用 memoryview 零拷贝视图
def parse_binary_stream(raw_bytes: bytes, chunk_size: int):
    view = memoryview(raw_bytes)
    total = len(view)
    for start in range(0, total, chunk_size):
        chunk_view = view[start:start + chunk_size]
        process_view(chunk_view)  # 纯指针切片,无内存分配
六、总结:切片高频逻辑陷阱与面试自查速查表
综合以上分析,在面对切片相关的逻辑问答或上机编码时,可以按照以下四个关键点快速自查与定位问题:
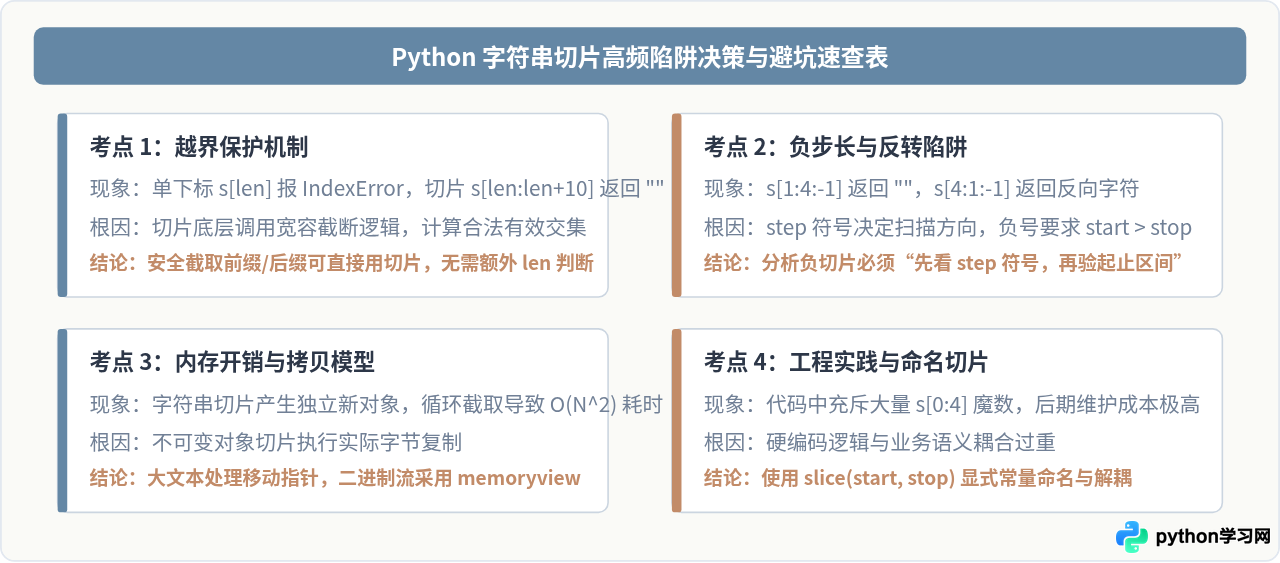
掌握以上切片三要素的内部制约规则、越界截断策略以及内存生命周期,不仅能从容应对技术面试中的各类边界陷阱题,更能编写出健壮、高效且具备高可读性的生产级 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















