


用Python进行数据分析入门:Pandas基础操作演示
在 Python 数据分析体系中,Pandas 是承载表格数据处理与转换的基石库。它将原本需要复杂循环和嵌套字典才能完成的数据筛选、缺失补齐、行列透视与分组统计,封装成了直观且高效的二维矩阵操作。掌握 Pandas 的核心不在于死记硬背数百个 API,而在于理解其底层的数据结构模型以及标准的处理流水线。本文以一份典型销售订单数据为操作对象,完整演示从环境搭建、结构探查、精准索引切片,到数据清洗与聚合导出的全套落地步骤。
一、运行环境与核心数据结构认知
Pandas 通常与数值计算库 NumPy 配合使用。在本地终端或 Jupyter Notebook 环境中,只需执行以下命令即可完成安装:
pip install pandas openpyxl安装完成后,行业通用的导入约定是将 Pandas 简写为 pd:
import pandas as pd在编写具体逻辑前,必须明确 Pandas 的两大数据容器:Series 与 DataFrame。
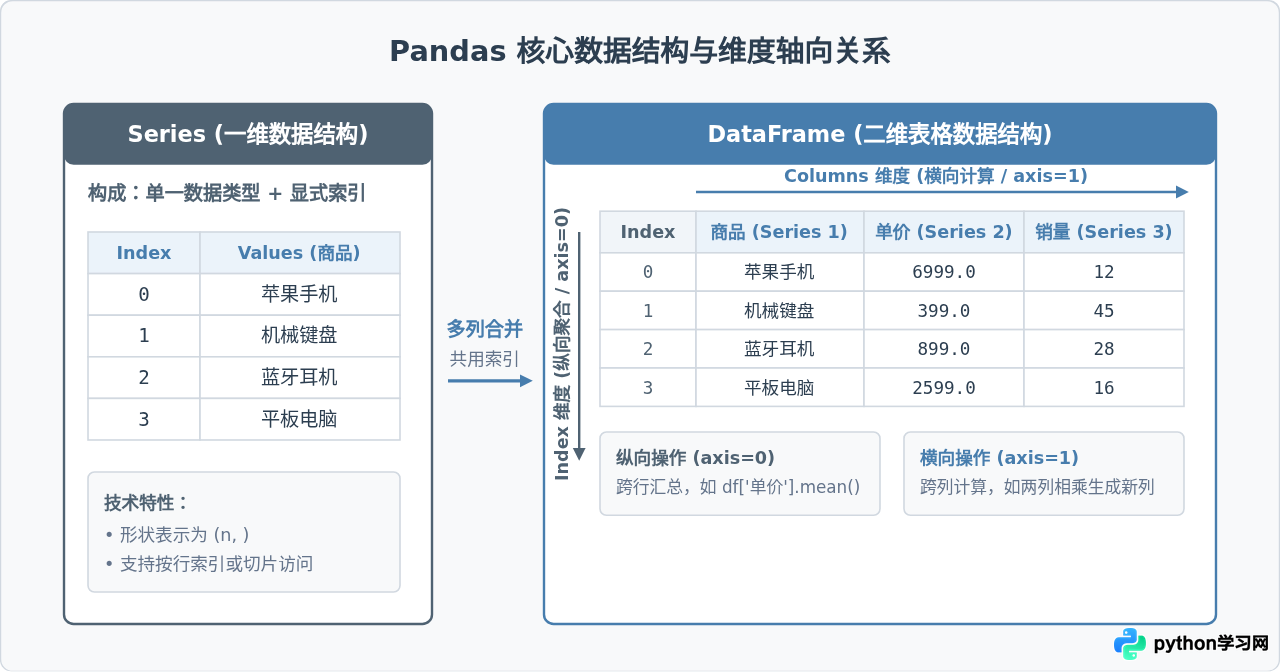
- Series(一维序列):带标签的一维同构数组。它由两个主要成分构成:实际存储数据的数值区(values)以及用于定位的索引标签(index)。你可以把它理解为具有固定行名的单列数据。
- DataFrame(二维表格):表格型复合数据结构。它拥有行索引(Index,即纵向坐标)和列名称(Columns,即横向坐标)。DataFrame 的每一列在物理与逻辑上都是一个独立的 Series,多个 Series 在共享同一行索引的前提下拼接构成了二维表格。
二、构建演示数据与结构快速探查
为确保所有示例均可直接在本地复现,我们使用 Python 原生字典构建一个涵盖分类、单价、销量以及缺失值的演示 DataFrame:
import pandas as pd
import numpy as np

# 构建示例销售订单数据
data = {
    'order_id': ['ORD-101', 'ORD-102', 'ORD-103', 'ORD-104', 'ORD-105', 'ORD-106'],
    'city': ['北京', '上海', '广州', '北京', '上海', '深圳'],
    'category': ['电子', '服装', '电子', '日用', '服装', '电子'],
    'unit_price': [1200.0, 350.0, 850.0, 45.0, 280.0, 2100.0],
    'quantity': [2, 4, 1, 15, np.nan, 3]  # 故意构造一处缺失值用于清洗演示
}

df = pd.DataFrame(data)
在真实业务中,数据多来源于本地磁盘文件,使用 pd.read_csv('sales.csv') 或 pd.read_excel('sales.xlsx') 即可直接载入。载入数据后的第一件事,永远是探查数据集的形态与质量,而不是直接开始计算。
1. 查看前部数据:head()
print(df.head(3))head(n) 默认返回前 5 行(此处指定为 3 行),用于核验字段名称是否解析正确,数据是否存在错位。
2. 检查字段类型与非空计数:info()
df.info()通过 info() 可以迅速捕捉两个致命隐患:一是字段类型是否符合预期(如本应为数值的金额是否被误读为 object 字符串);二是是否存在缺失值(6 行记录中 quantity 仅有 5 个非空值,说明存在 1 个缺失)。
3. 数值字段描述性统计:describe()
print(df.describe())describe() 会一次性输出均值、标准差、极值和分位数,帮助分析人员快速识别是否有负数单价、异常大销量等极端脏数据。
三、数据切片与定位:loc 与 iloc 的区别机制
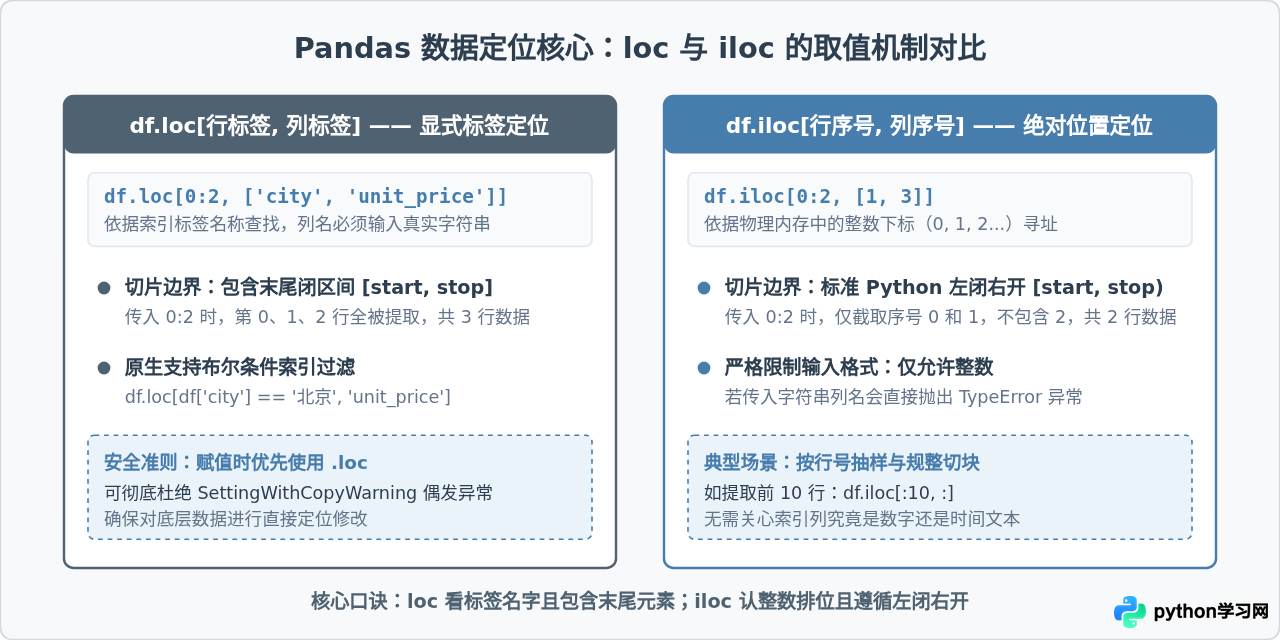
从表格中提取特定行和特定列是高频操作。初学者最容易混淆的莫过于 loc 与 iloc。二者的根本区别在于:loc 依靠显式标签定位,iloc 依靠从 0 开始的物理序号定位。
1. 单列与多列选取
# 提取单列(返回 Series)
city_series = df['city']

# 提取多列(传入列名列表,返回 DataFrame)
sub_df = df[['order_id', 'city', 'unit_price']]
print(sub_df.head(2))2. 布尔条件过滤
布尔索引是 Pandas 进行数据筛选的核心利器。当需要筛选“城市为北京且单价大于 100”的订单时,需要注意每一个独立判断条件都必须用圆括号包裹,且逻辑与操作使用 &,逻辑或使用 |,不能使用 Python 原生的 and 或 or:
# 多条件布尔筛选
condition = (df['city'] == '北京') & (df['unit_price'] > 100)
beijing_high = df[condition]
print(beijing_high)四、数据清洗与聚合统计全流程
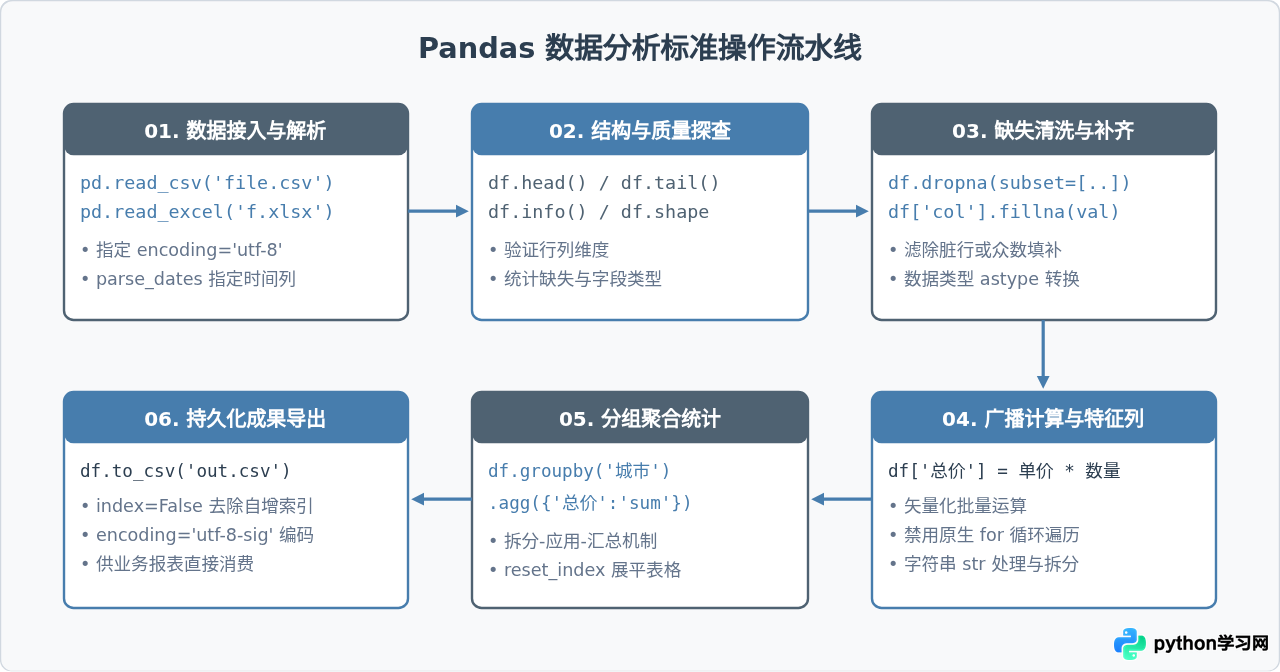
获得原始数据后,从探查到输出结果需要经历一条标准的操作流水线:缺失值清洗、特征工程(新增计算列)、分组聚合统计以及结果导出。
1. 缺失值识别与填充
在演示数据中,quantity 包含一个 NaN 缺失值。在进行算术运算之前必须处理缺失值,否则任何数值与 NaN 运算的结果都将依然是 NaN。
# 1. 查看各字段缺失统计
print(df.isnull().sum())

# 2. 缺失值填充:根据业务逻辑将缺失购买数量默认为 1 件
df['quantity'] = df['quantity'].fillna(1.0)

# 3. 将数量字段显式转换为整型
df['quantity'] = df['quantity'].astype(int)2. 向量化运算:新增派生字段
Pandas 基于 NumPy 实现底层的连续内存广播运算。为所有订单计算总金额(单价 × 数量),无需使用任何 for 循环:
# 向量化广播运算:生成总金额列
df['total_amount'] = df['unit_price'] * df['quantity']
print(df[['order_id', 'city', 'unit_price', 'quantity', 'total_amount']])3. 分组聚合统计:groupby 与 agg
分组聚合遵循经典的 Split-Apply-Combine(拆分-应用-合并) 模式。以下代码实现按城市分组,同时统计订单笔数、总销售额以及平均客单价:
# 按城市汇总核心业务指标
city_report = df.groupby('city').agg(
    order_count=('order_id', 'count'),
    total_revenue=('total_amount', 'sum'),
    average_order_value=('total_amount', 'mean')
).reset_index()

# 按总销售额降序排列
city_report = city_report.sort_values(by='total_revenue', ascending=False)
print(city_report)注意末尾调用的 .reset_index():分组聚合后的数据默认会将分组键 city 提升为新的行索引。调用 reset_index() 可以把 city 重新变为普通列,还原成平整的二维关系表。
4. 分析结果输出保存
分析完成后,使用 to_csv 将统计汇总报表导出。务必加上 index=False 参数,避免将 Pandas 自带的 0, 1, 2 自增行号作为无关数据写入文件;在包含中文字符的 Windows 环境下,推荐指定 encoding='utf-8-sig' 杜绝 Excel 打开时出现乱码:
# 将分析汇总数据保存为 CSV
city_report.to_csv('city_sales_summary.csv', index=False, encoding='utf-8-sig')
五、新手关键避坑指南与知识导图
初学者在编写 Pandas 代码时,常会遇到运行缓慢或报错警告的情况。理解以下三个典型隐患背后的机制,能够帮助规避绝大多数常见问题。
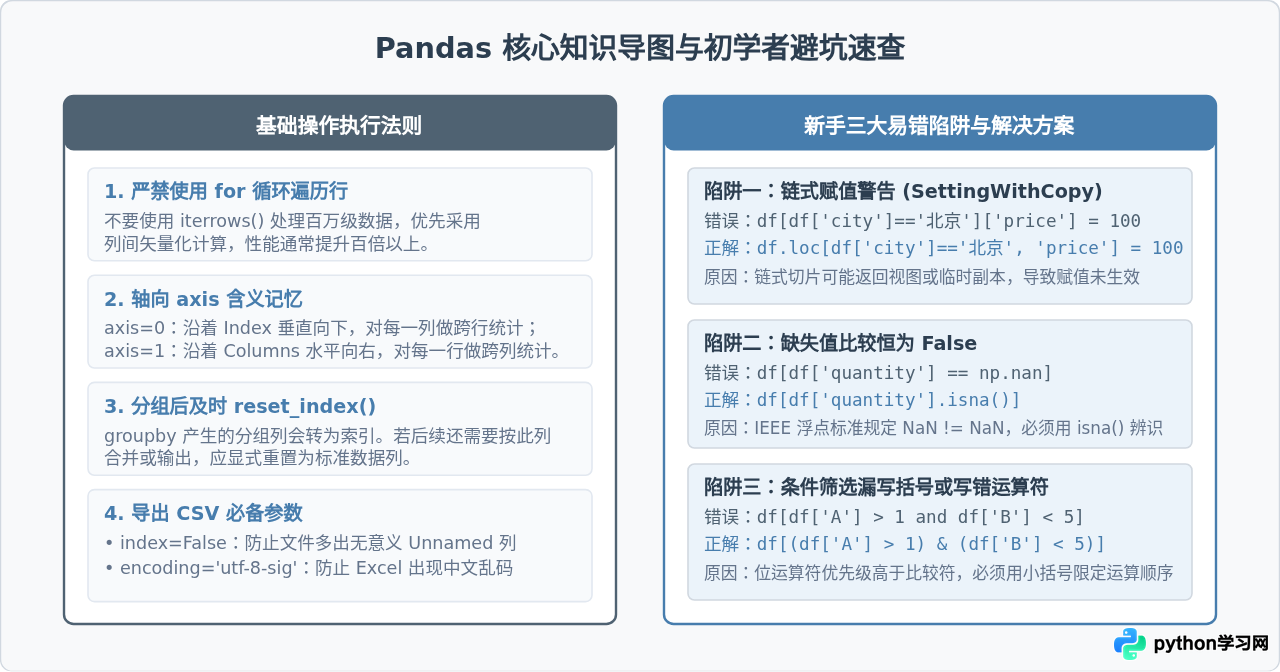
当对切片筛选出的子集进行再次筛选并赋值时(例如 sub_df = df[df['city'] == '北京']; sub_df['tag'] = 1),终端往往会抛出黄色警告。这是因为 Pandas 无法确定 sub_df 是原 DataFrame 的底层内存引用(View)还是全新内存复制品(Copy)。要彻底解决这一问题,如果打算修改子集,应在提取时显式调用 .copy():sub_df = df[df['city'] == '北京'].copy();如果是直接对原表赋值,请始终使用 df.loc[条件, 'tag'] = 1。
初学 Python 数据分析时,建立正确的操作认知比盲目刷题更重要。牢记 Series 与 DataFrame 的维度骨架,严格遵循“加载-探查-清洗-计算-导出”的标准流水线,熟练运用 loc 的显式切片并规避链式赋值,就能从容应对绝大部分日常结构化数据分析与自动化报表处理任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















