


Python os与subprocess模块实战:实现系统文件管理与命令执行自动化
深入讲解 Python 标准库中的 os 与 subprocess 模块,结合文件批量扫描、跨平台路径处理、外部命令安全调用与异常熔断机制,实现系统管理全流程自动化实战。
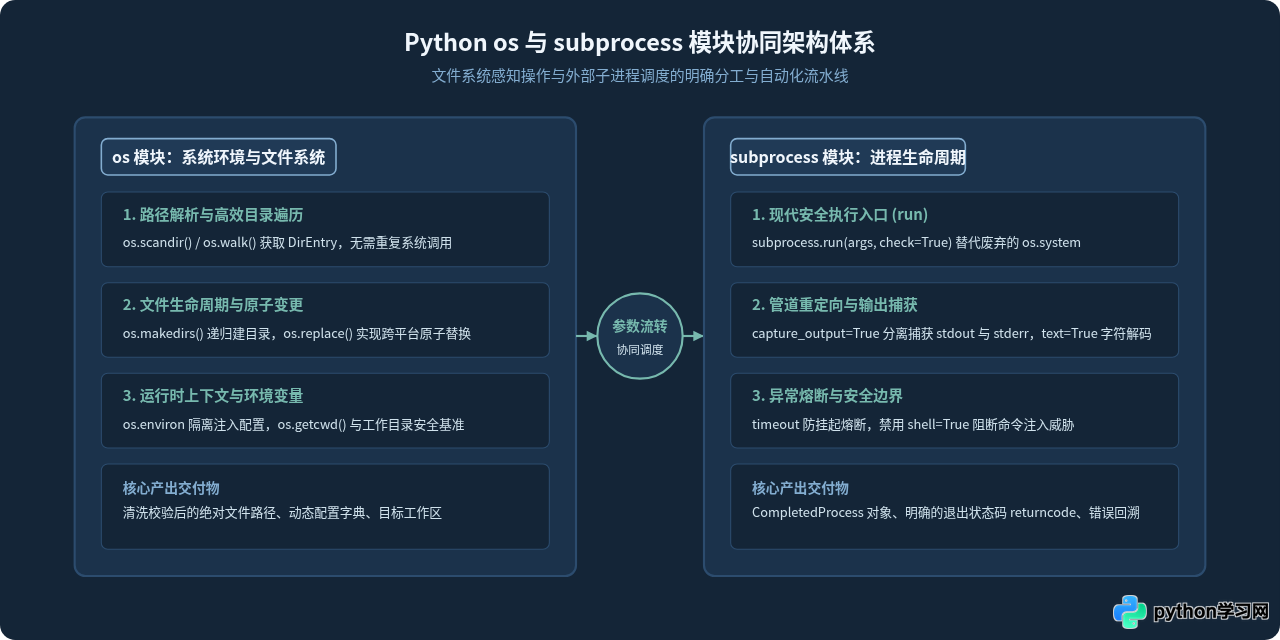
在日常运维、数据处理和自动化工程中,我们经常面临大量机械化的操作系统交互任务:定期扫描几万个日志文件并筛选归档、自动解压传输到达的数据包、调用系统底层的压缩工具进行打包,或者调度外部二进制程序处理任务。编写脚本时,许多开发者常常混淆系统底层文件交互与外部程序执行的边界。Python 标准库中的 os 模块与 subprocess 模块各司其职又紧密配合:os 负责感知和管理操作系统环境(如路径计算、目录扫描、文件状态判定与环境变量读写),而 subprocess 则专注于外部子进程的完整生命周期调度(包括命令传参、标准流重定向、超时截断与退出状态码检查)。掌握这两个模块的协同使用,是构建健壮自动化运维脚本的核心基石。
一、使用 os 模块进行现代高效的文件与环境管理
自动化脚本的第一步通常是了解“当前在哪里”、“有哪些文件需要处理”以及“如何安全地组织目标目录”。虽然很多入门教材依然在使用 os.listdir(),但在处理大规模文件时,理解不同接口的底层性能差异至关重要。
1. 跨平台路径解析与安全性
不同操作系统对路径分隔符的处理不同(Linux/macOS 使用 /,Windows 默认使用 \)。直接拼接字符串容易引发跨平台异常。始终使用 os.path.join() 或现代的 os.path.abspath(),能够确保脚本在不同平台下行为一致。
os.path.abspath(path):获取规范化的绝对路径,消除相对路径中.和..的歧义。os.path.exists(path)与os.path.isfile(path):用于前置校验目标是否存在且为常规文件。os.path.splitext(path):安全分离文件名与扩展名,避免文件名中含有多个点号时发生误切。
2. 大规模文件遍历首选:os.scandir()
在历史代码中,人们常用 os.listdir() 结合 os.path.isfile() 来过滤文件。但这种方式在面对成千上万个文件时效率低下,因为 os.listdir() 仅返回文件名列表,每次判断文件类型或获取大小时,系统都需要对每个文件单独发起一次额外的 stat 系统调用。而在 Python 3.5+ 中引入的 os.scandir() 返回迭代器,产生 os.DirEntry 对象,其内部在目录遍历阶段就缓存了文件类型和基本元数据,极大降低了 I/O 开销。
import os

def scan_text_files(base_dir):
    """
    高效扫描指定目录下的所有 .log 文件并返回元数据列表
    """
    target_files = []
    if not os.path.exists(base_dir):
        raise FileNotFoundError(f"目录不存在: {base_dir}")

    # 使用 os.scandir 获得迭代器,避免一次性在内存中载入全部文件名
    with os.scandir(base_dir) as entries:
        for entry in entries:
            # entry.is_file() 优先使用系统目录项缓存,通常不触发额外 stat 调用
            if entry.is_file() and entry.name.endswith(".log"):
                stat_info = entry.stat()
                target_files.append({
                    "name": entry.name,
                    "path": entry.path,
                    "size_bytes": stat_info.st_size,
                    "mtime": stat_info.st_mtime
                })
    return target_files

if __name__ == "__main__":
    # 模拟在当前工作区扫描
    results = scan_text_files(".")
print(f"找到符合条件的日志文件数量: {len(results)}")3. 文件目录的生命周期操作
在自动化任务中,创建输出目录和移动归档文件有特定的安全用法:
- 创建目录:使用
os.makedirs(output_dir, exist_ok=True)。设置exist_ok=True能够在目标目录已存在时静默跳过,避免多线程或重复运行抛出FileExistsError。 - 移动与重命名:优先使用
os.replace(src, dst)而不是os.rename(src, dst)。在 POSIX 系统中,os.replace具备原子性(Atomic),即如果目标文件已存在,会被原子替换而不会产生半写入状态;在 Windows 系统中,os.rename若遇到目标已存在会直接抛错,而os.replace则能正确覆盖。 - 安全删除:
os.remove(path)仅用于删除文件,遇到目录会报错;os.rmdir(path)仅用于删除空目录。
二、命令执行现代标准:subprocess 模块详解与最佳实践
很多 Python 脚本依然在使用老旧的 os.system("some_command")。必须明确指出:os.system 已经被官方淘汰。它无法捕获命令的标准输出和错误流,执行结果直接打印到控制台,且只能返回一个 16 位的状态掩码。更严重的是,它强制启动系统 Shell 解释器,极易遭受命令注入攻击。现代 Python 应当全面采用 subprocess.run()。
1. subprocess.run 的标准调用范式
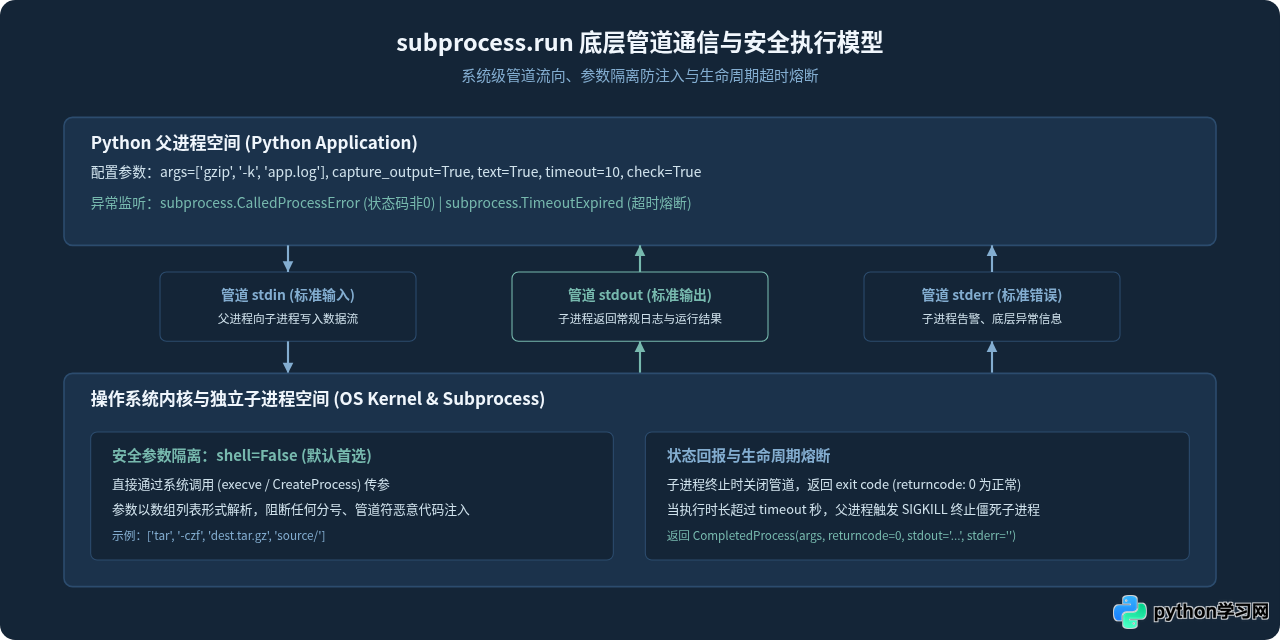
subprocess.run() 是 Python 3.5 引入并持续强化的官方推荐接口。编写系统自动化脚本时,建议统一开启以下四个关键参数:
capture_output=True:同时拦截stdout与stderr,避免子进程输出直接冲刷控制台污染日志。text=True(或encoding="utf-8"):自动将捕获的字节流(bytes)按照 UTF-8 解码为文本字符串,省去手动.decode("utf-8")。check=True:当子进程退出状态码非 0 时,自动在 Python 中抛出subprocess.CalledProcessError异常,强制要求开发者处理失败分支,避免静默失败。timeout=秒数:强制指定超时时间,防止外部命令因死锁、网络阻塞或等待用户交互而永远挂起。
import subprocess

def execute_system_command(cmd_args, timeout_sec=15):
    """
    通用、安全的命令执行封装函数
    :param cmd_args: 命令及其参数列表,例如 ['uptime'] 或 ['git', 'status']
    :param timeout_sec: 最大执行超时时间(秒)
    """
    try:
        # 执行外部命令,显式指定超时与输出拦截
        completed = subprocess.run(
            cmd_args,
            capture_output=True,
            text=True,
            check=True,
            timeout=timeout_sec
        )
        print(f"命令执行成功 [返回码: {completed.returncode}]")
        return completed.stdout.strip()

    except subprocess.CalledProcessError as err:
        # 命令本身返回非零错误码(例如命令参数错误或权限不足)
        print(f"命令执行失败,状态码: {err.returncode}")
        print(f"标准错误详情: {err.stderr.strip()}")
        raise

    except subprocess.TimeoutExpired as err:
        # 命令超时未能在规定时间内退出
        print(f"命令执行超时 (限制: {timeout_sec} 秒),子进程已强制终止")
        raise

if __name__ == "__main__":
    # 示例调用系统 python 查看版本号
    output = execute_system_command(["python3", "--version"])
print(f"获取到的版本输出: {output}")获取到的版本输出: Python 3.11.8
当设置
shell=True 时,Python 会启动系统默认的 Shell(如 /bin/sh 或 cmd.exe)来解析字符串。如果执行的命令中包含外部输入或动态文件名,攻击者只需在文件名中注入 ; rm -rf / 或 & calc.exe 即可实现任意代码执行。默认保持 shell=False,并将命令参数以 Python 列表传递,能从底层完全免疫此类命令注入攻击。如果必须从字符串解析复杂参数,可借助标准库 shlex.split("command --flag value") 拆分为安全列表。
三、实战案例:构建日志自动压缩与归档流水线
为了将 os 的文件系统管理能力与 subprocess 的系统进程调度能力融会贯通,我们通过一个高频工业场景进行综合演示:
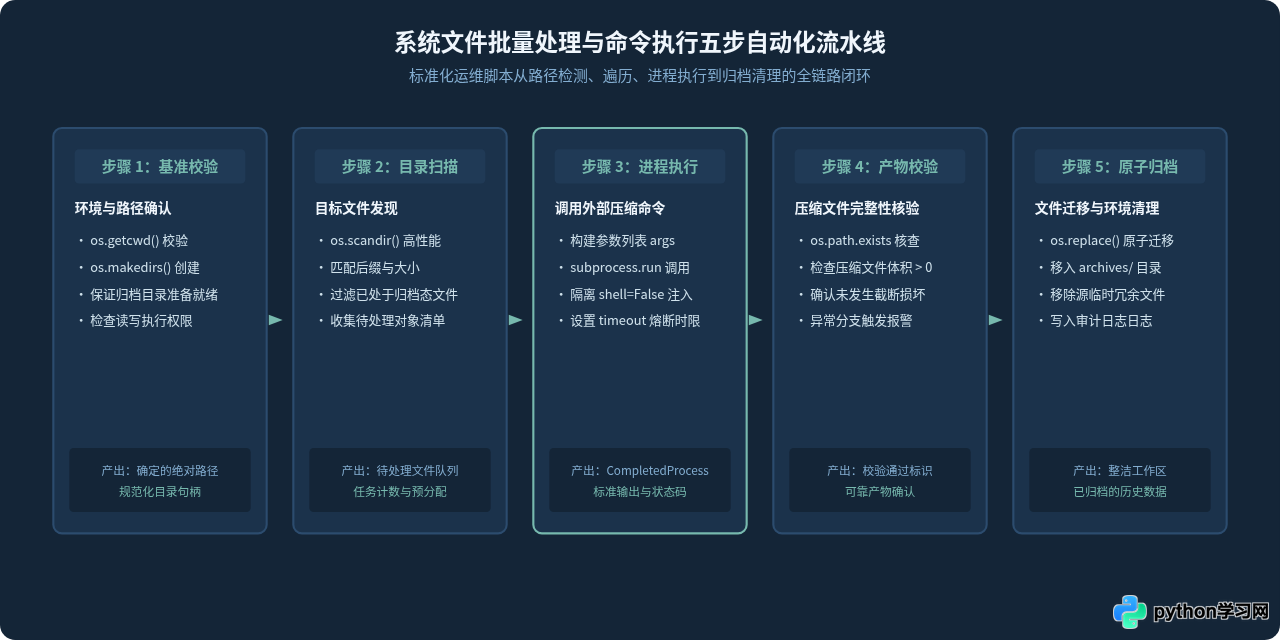
实战场景:某业务服务器会在指定工作目录下源源不断生成应用日志文件(*.log)。我们需要编写一个全自动脚本:首先利用 os 检测目录并扫描所有未压缩的日志;接着利用 subprocess 安全调用系统级压缩工具(如 gzip -k 或 tar)对其进行压缩;压缩验证通过后,将原日志文件原子迁移到归档目录 archives/ 中,并妥善处理异常与日志记录。
完整可执行流水线脚本
下面给出完整的自动化处理脚本。代码中严格遵循前文制定的规范:使用 os.scandir 高效检索、os.makedirs 幂等创建目标目录、通过参数列表安全调用 gzip、配置超时控制并在验证产物后执行 os.replace 原子归档。
import os
import subprocess
import sys

def run_archive_pipeline(source_dir=".", archive_dir="./archives"):
    """
    自动发现未压缩日志,调用 gzip 压缩并归档的自动化任务
    """
    # 步骤 1:规范化路径并准备目标目录
    abs_source = os.path.abspath(source_dir)
    abs_archive = os.path.abspath(archive_dir)
    os.makedirs(abs_archive, exist_ok=True)

    print(f"[*] 开始自动化巡检: 工作源目录 -> {abs_source}")
    print(f"[*] 归档目标存储目录 -> {abs_archive}")

    processed_count = 0
    failed_count = 0

    # 步骤 2:高效扫描待处理文件
    with os.scandir(abs_source) as entries:
        for entry in entries:
            # 仅处理根目录下的 .log 文件,忽略子目录与其它文件
            if entry.is_file() and entry.name.endswith(".log"):
                log_path = entry.path
                file_name = entry.name
                compressed_file = log_path + ".gz"
                archived_target = os.path.join(abs_archive, file_name + ".gz")

                print(f"\n[+] 发现待处理文件: {file_name} (体积: {entry.stat().st_size} 字节)")

                # 步骤 3:使用 subprocess 安全调用系统级 gzip 压缩工具
                # -k 保留原始文件以便核验,-f 强制覆盖同名临时文件
                cmd = ["gzip", "-k", "-f", log_path]

                try:
                    result = subprocess.run(
                        cmd,
                        capture_output=True,
                        text=True,
                        check=True,
                        timeout=30  # 单个文件压缩上限 30 秒
                    )

                    # 步骤 4:产物有效性校验
                    if os.path.exists(compressed_file) and os.path.getsize(compressed_file) > 0:
                        # 步骤 5:原子性迁移归档
                        os.replace(compressed_file, archived_target)
                        # 压缩成功归档后,安全清理源文本日志
                        os.remove(log_path)
                        print(f"    -> 成功压缩并归档至: {archived_target}")
                        processed_count += 1
                    else:
                        print(f"    [!] 压缩产物异常,保留原文件: {compressed_file}", file=sys.stderr)
                        failed_count += 1

                except subprocess.CalledProcessError as err:
                    print(f"    [!] 外部压缩命令执行失败: {err.stderr.strip()}", file=sys.stderr)
                    failed_count += 1
                except subprocess.TimeoutExpired:
                    print(f"    [!] 处理超时,已强制中断子进程", file=sys.stderr)
                    failed_count += 1
                except OSError as err:
                    print(f"    [!] 文件系统操作异常: {err}", file=sys.stderr)
                    failed_count += 1

    print("\n" + "=" * 50)
    print(f"[*] 自动化批处理任务结束: 成功归档 {processed_count} 个文件,失败 {failed_count} 个")

if __name__ == "__main__":
    # 执行流水线
run_archive_pipeline()[*] 归档目标存储目录 -> /data/logs/archives
[+] 发现待处理文件: access_20261024.log (体积: 4194304 字节)
-> 成功压缩并归档至: /data/logs/archives/access_20261024.log.gz
[+] 发现待处理文件: error_20261024.log (体积: 524288 字节)
-> 成功压缩并归档至: /data/logs/archives/error_20261024.log.gz
==================================================
[*] 自动化批处理任务结束: 成功归档 2 个文件,失败 0 个
四、进阶模式:多命令管道串联与环境隔离
在复杂的生产环境中,自动化往往不仅仅是执行单一命令,还需要在多个命令之间流式传递数据,或者在隔离的环境变量下运行外部程序。
1. 两个外部进程管道连接(流式处理避免大内存暂存)
当我们需要将前一个命令的输出作为后一个命令的输入时(例如将日志流式过滤再打包),如果先把数据全读到 Python 内存再写入第二个命令,面对数 GB 的大日志极易导致 OOM。通过 subprocess.Popen 与管道重定向,可以让操作系统内核在两个子进程之间建立管道缓冲区:
import subprocess

def stream_filter_and_compress(input_file, output_archive):
    """
    通过内核管道连接两个命令: cat input_file | grep ERROR | gzip > output_archive
    Python 父进程只负责协调,不占用大量内存
    """
    with open(output_archive, "wb") as out_f:
        # 第一个进程:读取源文件并筛选带有 ERROR 标识的行
        p1 = subprocess.Popen(
            ["grep", "ERROR", input_file],
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE
        )
        # 第二个进程:直接接收 p1 的输出管道作为 stdin
        p2 = subprocess.Popen(
            ["gzip"],
            stdin=p1.stdout,
            stdout=out_f,
            stderr=subprocess.PIPE
        )
        # 允许 p1 在 p2 退出时接收 SIGPIPE
        if p1.stdout:
            p1.stdout.close()

        # 等待最终进程执行完毕
        _, p2_err = p2.communicate()
        p1.wait()

        if p2.returncode != 0:
            raise RuntimeError(f"压缩管道异常: {p2_err.decode('utf-8')}")
        print(f"流式过滤压缩完成: {output_archive}")
2. 环境变量隔离注入
在自动化调用外部命令时,直接修改 os.environ 会污染整个 Python 进程的主环境变量。更安全的做法是基于当前环境浅拷贝一份字典,在其上做修改后通过 subprocess.run(..., env=custom_env) 传递给子进程:
import os
import subprocess

def run_isolated_task():
    # 拷贝一份只属于本次子进程的隔离环境变量字典
    custom_env = os.environ.copy()
    custom_env["APP_ENV"] = "production"
    custom_env["LC_ALL"] = "C.UTF-8"
    # 追加专有可执行文件搜索路径
    custom_env["PATH"] = f"/opt/custom/bin:{custom_env.get('PATH', '')}"

    result = subprocess.run(
        ["env"],
        capture_output=True,
        text=True,
        check=True,
        env=custom_env
    )
    print("已在隔离环境中完成外部进程调度")
五、实战选型与防御性编程避坑全景
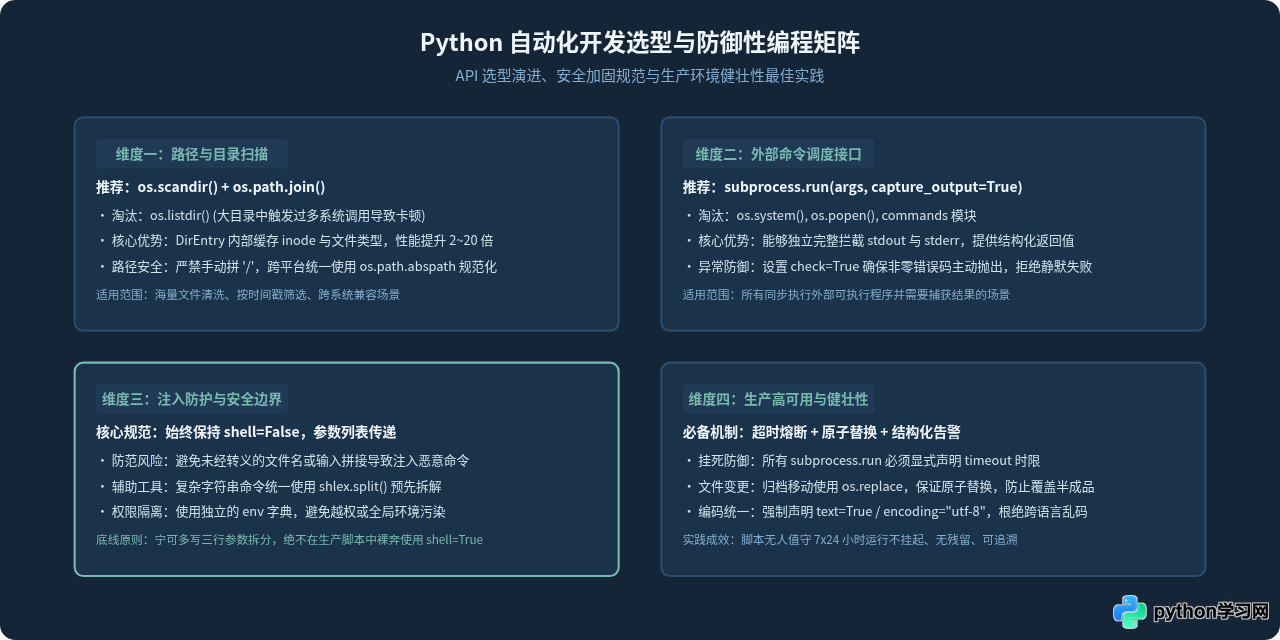
为了帮助读者在实际工程开发中快速决策,避开隐藏的兼容性与安全陷阱,下表与全景矩阵总结了 os 与 subprocess 模块的核心要点与规范:
常见问题与调试要点
- 为什么 subprocess.run 找不到命令(FileNotFoundError)?
在 Linux/macOS 下,直接传args=["my_tool", ...]会根据当前环境变量PATH进行检索。如果该命令安装在/usr/local/bin或虚拟环境特定目录,且脚本是由系统的 crontab(默认PATH非常精简)启动的,就会报错找不到文件。解决方法是使用绝对路径,例如/usr/local/bin/my_tool,或者在脚本开头读取并确保os.environ["PATH"]包含目标目录。 - Windows 系统下可执行命令带后缀的问题:
在 Windows 系统中调用系统内置命令或批处理文件时(如dir、echo),由于它们并非独立 exe 而是cmd.exe的内置指令,此时若不通过cmd.exe /c调用,就会抛错。对于标准工具,建议明确指定可执行文件名称(如tar.exe、python.exe)。 - 大输出量命令的内存处理:
如果被调用的外部命令会连续打印数百万行输出,不要使用capture_output=True将其全部缓冲在内存中。应改用subprocess.Popen并通过stdout=subprocess.PIPE逐行迭代读取,或者直接重定向到磁盘文件stdout=open("output.log", "wb")。
通过合理结合 os 对文件系统、路径元数据和目录结构的掌控力,以及 subprocess 对外部进程管道、生命周期与错误捕获的严谨调度,开发者能够摆脱脆弱的胶水脚本,构建出安全、高效且具备工业级容错能力的系统自动化应用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















