


Python爬虫模块怎么选?静态解析与动态渲染的场景化推荐
假设你正在编写一个抓取电商商品或资讯列表的爬虫脚本:满怀期待地用 requests.get() 发送了请求,却发现返回的 HTML 源码里关键的价格、库存和评论区完全是空白的,正文数据全被封装在一堆由 JavaScript 动态生成的加密结构中;而当你转用 Selenium 启动一个真实无头浏览器去抓取几百页数据时,机器内存占用瞬间突破警戒线,翻页速度慢如蜗牛。在实际工程落地中,选错爬虫技术栈不仅会导致开发周期大幅延误,更容易让采集程序陷入维护泥潭。
核心答案在于:Python 爬虫的技术选型核心取决于两步——第一步是判断目标页面是“服务端直出(静态)”还是“客户端渲染(动态)”;第二步是在吞吐性能要求与反爬对抗复杂度之间找到最优平衡点。 静态页面应毫不犹豫采用轻量级的 HTTP 客户端配合高效解析器;而对于动态单页应用,应优先通过浏览器控制台嗅探底层 JSON 数据接口,实在无法突破签名限制或需要复杂页面交互时,再引入现代无头浏览器驱动进行兜底渲染。
一、渲染机制分水岭:静态解析 vs 动态渲染
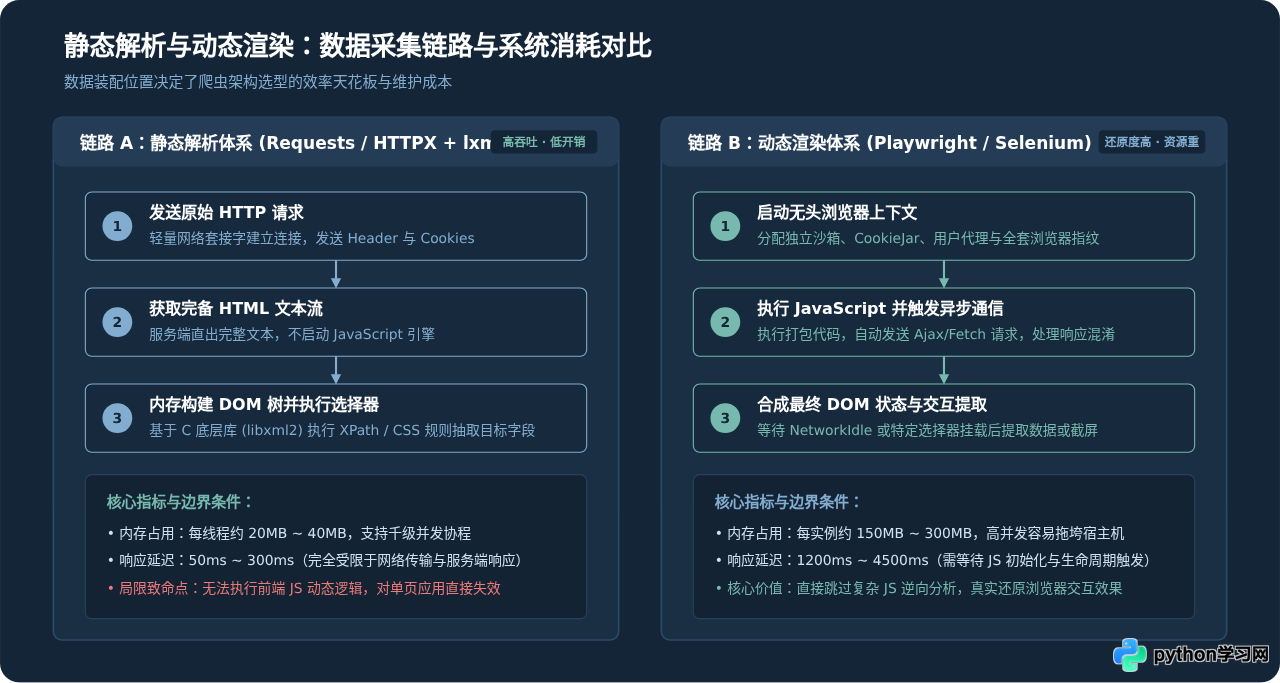
理解爬虫选型的第一步,是明确现代 Web 页面在数据装配流程上的根本差异。两者的技术链条决定了爬虫在资源消耗、并发能力以及抗反爬策略上的完全不同。
- 静态解析(Server-Side Rendering / SSR): 客户端发出的 HTTP GET 请求直接换回包含完整文本数据的 HTML 源码。服务端的模板引擎在响应返回前已将数据填入标签。爬虫只需完成文本请求与内存 DOM 树解析,单核 CPU 每秒可轻松处理数百甚至上千个页面,内存占用极少(通常单进程仅 20MB~40MB)。其硬伤在于完全无法执行页面中的 JavaScript 代码。
- 动态渲染(Client-Side Rendering / CSR): 服务端初次响应的往往只是一个空壳 HTML(仅包含基础骨架和引入的
<script>脚本)。浏览器加载后,由 JavaScript 引擎发起异步 Fetch/XHR 请求拉取实际数据,再在本地内存中动态生成 DOM 节点。爬虫若只用普通 HTTP 模块读取源码,拿到的就是空标签;必须借助真正的浏览器内核(如 Chromium)执行脚本并完成渲染周期,单实例内存占用常达 150MB~300MB,吞吐量骤降。
二、目标页面渲染类型的4步诊断法
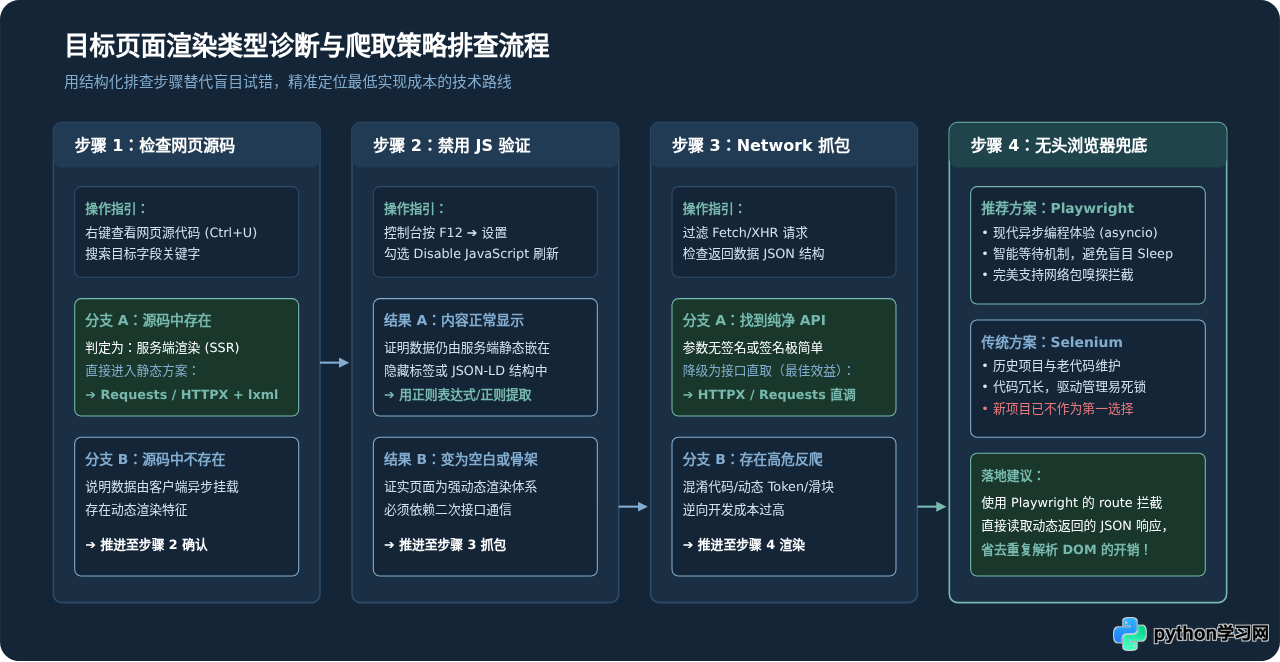
很多开发者在开始爬取时盲目使用 Playwright 或 Selenium,导致系统开销居高不下;另一些人则在静态源码中苦苦搜寻根本不存在的字段。在写第一行采集代码前,推荐遵循以下 4 步标准化排查流程:
- 第一步:查看网页源代码(Ctrl+U / Command+Option+U)。 在页面上复制一段核心业务数据(如某条商品的标题或特定价格),在源码视图中执行
Ctrl+F检索。如果在源码中直接找到了该内容,说明数据是服务端渲染直出的,属于静态页面,优先采用静态解析工具。 - 第二步:禁用浏览器 JavaScript 验证。 打开开发者工具(F12),进入设置(Settings)面板,勾选“Disable JavaScript”(禁用 JavaScript),然后刷新网页。如果核心数据依然完好无损地展示,证明该页面即便有局部 JS 效果,核心数据依然是静态渲染;如果刷新后页面呈现完全白屏、骨架屏或内容彻底消失,则说明数据 100% 依赖动态渲染。
- 第三步:Network 抓包嗅探(查找降级接口)。 若确认是动态渲染,不要急着启动无头浏览器!先在 Network 面板中选中
Fetch/XHR标签过滤,重新加载页面或进行一次翻页操作,观察所有返回 JSON 格式的后台网络请求。许多现代站点虽然页面是动态的,但后端 API 并没有复杂的防篡改签名。直接调用这个后端 API 相当于把动态页面“降级”为了最简单的静态 JSON 接口,采集效率可提升 20 倍以上。 - 第四步:评估逆向成本与渲染兜底。 如果捕获的 API 请求头中带有高强度的加密签名(例如
_signature、时间戳防篡改、动态 Token),且 JavaScript 代码经过了高度混淆(如 Obfuscator 压缩),在项目工期紧张的前提下,逆向分析可能需要耗费数天甚至数周。此时,直接使用 Playwright 启动无头浏览器进行动态渲染 便是最务实的兜底方案。
三、静态解析工具链横向测评与推荐场景
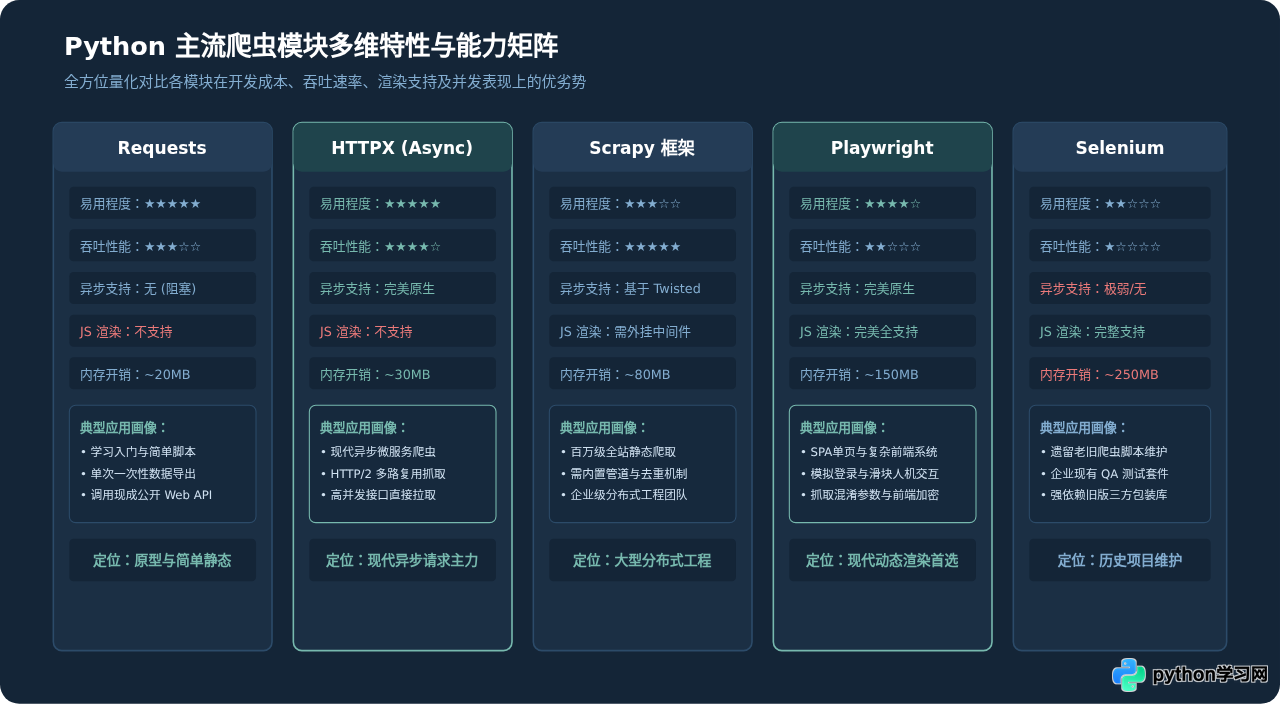
当确认目标页面属于静态直出或找到了直出 API 后,爬虫的性能核心就转移到了两个环节:网络请求模块 与 文档解析提取模块。合理搭配这两个层级,可以把采集效率提升一个数量级。
1. 网络请求层:Requests vs HTTPX
- Requests: Python 爬虫界最经典的同步 HTTP 库。优点是 API 设计极其直观优雅,会话管理(
Session)和连接池机制稳定。缺点在于仅支持同步阻塞,单线程一次只能等待一个响应返回,面对成千上万个页面采集时必须借助线程池或多进程。 - HTTPX: 现代 Python 异步开发首选。它不仅具备接近 Requests 的友好 API,而且原生支持 HTTP/2 与
async/await异步协程。结合asyncio,单机单进程只需开辟少量事件循环开销,即可维持成百上千个并发网络连接,吞吐量相较同步 Requests 可实现成倍跨越。
2. 数据解析层:BeautifulSoup4 vs lxml vs Parsel
- BeautifulSoup4: 容错率极高,甚至能解析标签未闭合的残缺 HTML。其语法简单亲民,但纯 Python 实现的搜索逻辑性能较弱。适合小脚本、格式混乱的老旧网站或原型验证。
- lxml: 基于 C 语言底层库
libxml2与libxslt封装,解析性能处于 Python 生态顶峰,且原生完整支持标准 XPath 1.0 语法。在大批量生产环境下,lxml 是静态 HTML 抽取的不二之选。 - Parsel: Scrapy 框架背后的核心抽取组件,对 lxml 进行了封装。它允许同时无缝使用 CSS 选择器、XPath,并支持链式正则匹配(
.re()),在工程开发中书写体验极为流畅。
以下是使用现代 httpx 与 lxml 进行高效异步爬取的典型示例:
import asyncio
import httpx
from lxml import etree

async def fetch_item(client: httpx.AsyncClient, item_id: int):
    url = f"https://example.com/books/{item_id}"
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0"}
    try:
        response = await client.get(url, headers=headers, timeout=10.0)
        response.raise_for_status()

        # 移交 lxml C底层的 HTML 解析器
        tree = etree.HTML(response.text)

        # 使用 XPath 快速定位
        title = tree.xpath("//h1[@class='book-title']/text()")
        price = tree.xpath("//span[@class='price']/text()")

        return {
            "id": item_id,
            "title": title[0].strip() if title else None,
            "price": price[0].strip() if price else None
        }
    except httpx.HTTPError as exc:
        return {"id": item_id, "error": str(exc)}

async def main():
    async with httpx.AsyncClient(http2=True, limits=httpx.Limits(max_connections=50)) as client:
        tasks = [fetch_item(client, i) for i in range(1, 101)]
        results = await asyncio.gather(*tasks)
        print(f"成功完成 {len(results)} 个页面的采集提取")

if __name__ == "__main__":
    asyncio.run(main())
四、动态渲染方案对比:Playwright vs Selenium
当页面存在强动态混淆加密、滑块验证码或依赖鼠标滚动翻页加载时,动态渲染便成了刚需。目前主流的解决方案是 Microsoft 主导的 Playwright 与老牌的 Selenium。
time.sleep(3)。网络环境稍有波动就会造成爬取失败,或者无意义地延长采集耗时。现代渲染方案必须依赖选择器挂载状态或网络空闲(NetworkIdle)来动态触发后续动作。
| 对比维度 | Playwright (推荐首选) | Selenium (传统方案) |
|---|---|---|
| 异步并发支持 | 原生支持 asyncio 协程,多页面轻量并发 |
依赖同步执行,并发需起多进程/多线程,极重 |
| 等待机制 | 内置智能自动等待(Auto-waiting),元素就绪才操作 | 需手动编写复杂的 WebDriverWait 与 expected_conditions |
| 网络控制与拦截 | 一等公民支持:可直接拦截并读取 Fetch/XHR 数据包 | 原生能力弱,通常需要借助三方中间人代理(Browsermob) |
| 多上下文隔离 | 单浏览器实例下可开辟数千个互不干扰的 BrowserContext | 需要频繁创建并销毁独立 WebDriver 进程,容易残留死锁 |
| 生态历史包袱 | 现代化 API 设计,开箱即用无须繁琐安装驱动文件 | 生态资料多,但驱动版本常与本地 Chrome 脱节报错 |
在 Playwright 中,有一个极其强悍的技术技巧是通过网络路由(Route)直接拦截并读取异步 JSON,这样既不需要复杂的 JS 逆向,也不必在页面上写复杂的 DOM 选择器:
import asyncio
from playwright.async_api import async_playwright

async def handle_response(response):
    # 只要包含目标商品数据的后端接口响应,就直接提取 JSON
    if "/api/products/detail" in response.url and response.status == 200:
        try:
            data = await response.json()
            print("【拦截到结构化数据】:", data.get("title"), data.get("price"))
        except Exception:
            pass

async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        # 创建隔离上下文,开启伪装
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
            viewport={"width": 1280, "height": 800}
        )
        page = await context.new_page()

        # 挂载后台响应监听
        page.on("response", handle_response)

        # 访问页面,等待网络空闲即可触发拦截
        await page.goto("https://example.com/product/1001", wait_until="networkidle")
        await browser.close()

if __name__ == "__main__":
    asyncio.run(main())
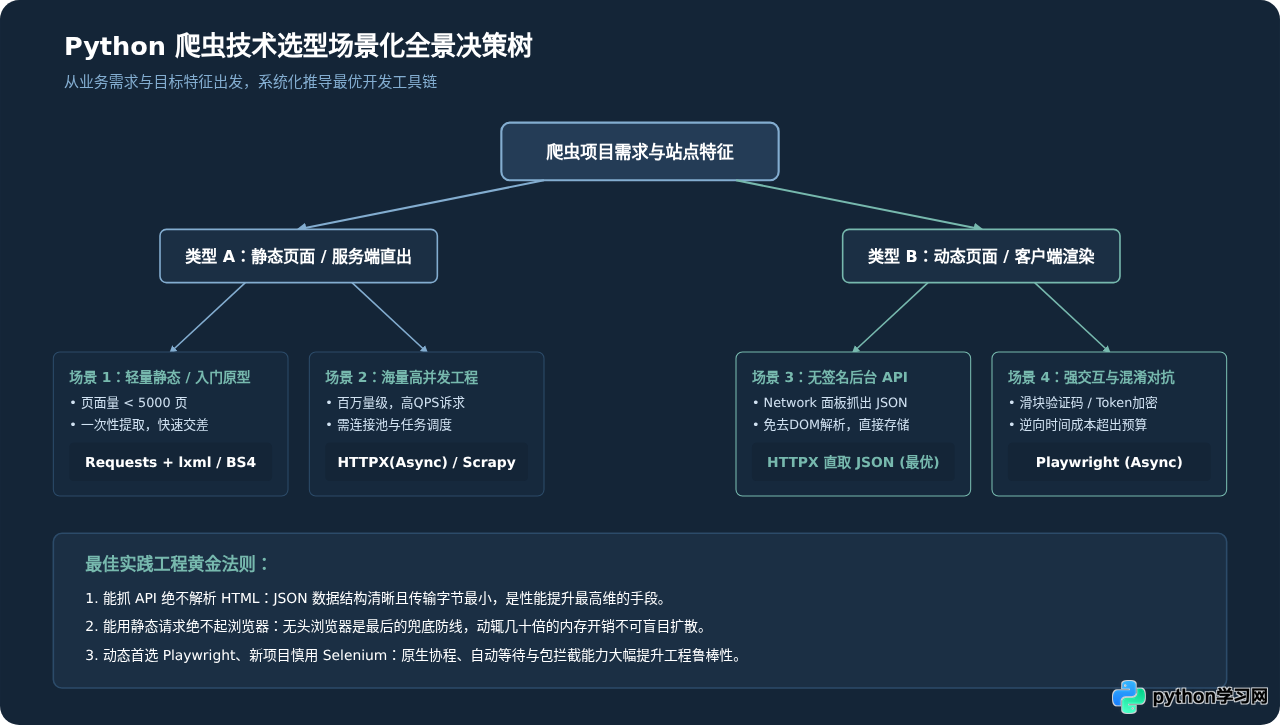
五、全景决策树与场景化选型指南
为帮助你在新项目中迅速做出判断,我们总结出如下 4 大典型场景的推荐组合与全景决策树:
- 场景 1:新闻资讯、维基百科、静态文档、轻量数据抓取
首选组合:Requests / HTTPX + lxml (XPath)
理由: 数据全部包含在初始 HTML 中,开发门槛极低,运行资源开销忽略不计,维护最省心。 - 场景 2:全网数十万至千万级规模数据采集
首选组合:HTTPX (Async) 协程集群或Scrapy 分布式框架 (Scrapy-Redis)
理由: 该量级下禁止使用任何重量级无头浏览器。必须通过抓包找出服务端原始数据接口,以纯异步高并发网络流直接拉取,单台服务器日采集量可达数千万条。 - 场景 3:Vue / React / Angular 单页应用(SPA)但接口公开
首选组合:浏览器控制台定位 Fetch/XHR ➔ HTTPX 模拟请求
理由: 尽管界面由前端 JS 渲染,但数据接口暴露明晰。直接调用数据接口既能避开繁琐的 HTML 标签清理,又能享受到静态级别的极致吞吐。 - 场景 4:高阶反爬对抗、滑块/点选验证码、强加密混淆、Canvas 图表抓取
首选组合:Playwright (Python Async) + playwright-stealth 插件
理由: 逆向解密代码的工程成本已远超服务器算力成本。通过 Playwright 保持浏览器真实执行环境,并配合智能等待机制,是兼顾产出效率与成功率的终极手段。
六、写在最后的选型提醒
技术选型本质上是对研发时间、服务器算力、维护难度三者之间的综合权衡。在实际项目中,最优秀的爬虫系统往往不是单一模块的孤军奋战,而是“动静结合”的协同作战:例如,先利用 Playwright 模拟用户完成带有滑块验证的登录流程,持久化保存此时的浏览器会话(Cookie 与 Token);随后的上万页批量数据采集任务,则直接把该凭证注入到轻量级的 HTTPX (Async) 会话中进行极速高并发拉取。掌握静态解析与动态渲染的本质特征,按图索骥选择合适工具,方能在数据采集工作中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















