


Java转Python:数据类型使用中常见的陷阱与避坑指南
针对从Java转向Python的开发者,系统解析变量引用模型、可变与不可变类型、默认参数陷阱、数值整除差异及集合操作中的常见隐患,并提供规范的代码解决方案。
从静态强类型的 Java 转向动态类型的 Python,开发者常会被 Python 精简的语法和无需显式声明变量类型的特性所吸引。然而,这种语法表面的简单性往往隐藏着底层机制的巨大差异。Java 开发者如果直接沿用原有的内存模型习惯、参数传递认知和类型判断思维,很容易在数值运算、参数求值、对象赋值等场景中遭遇非预期的静默错误。本文聚焦两门语言在数据类型核心机制上的差异,逐一梳理最容易踩中的数据类型陷阱,并给出规范的避坑解决策略。
一、变量绑定模型:内存盒子 vs 命名标签
在 Java 中,变量声明本质上是在内存中开辟了一块固定大小与类型的“盒子”。对于基本数据类型(如 int、double),盒子直接存放数值,变量赋值是数值副本的直接复制;对于引用类型,盒子中存放的是堆内存对象的指针,两个变量指向同一对象时,赋值仅复制指针本身。
但在 Python 的设计哲学中,“一切皆对象”(Everything is an object)。Python 的变量名并没有固定的类型或专有内存槽,变量名仅仅是一个“标签”(Name Binding),通过符号表绑定到底层独立存在的对象上。执行 a = [1, 2] 是在堆中创建列表对象并将名字 a 贴到该对象上;随后执行 b = a,并不是创建新列表,而是把标签 b 也贴到了同一个列表对象上。
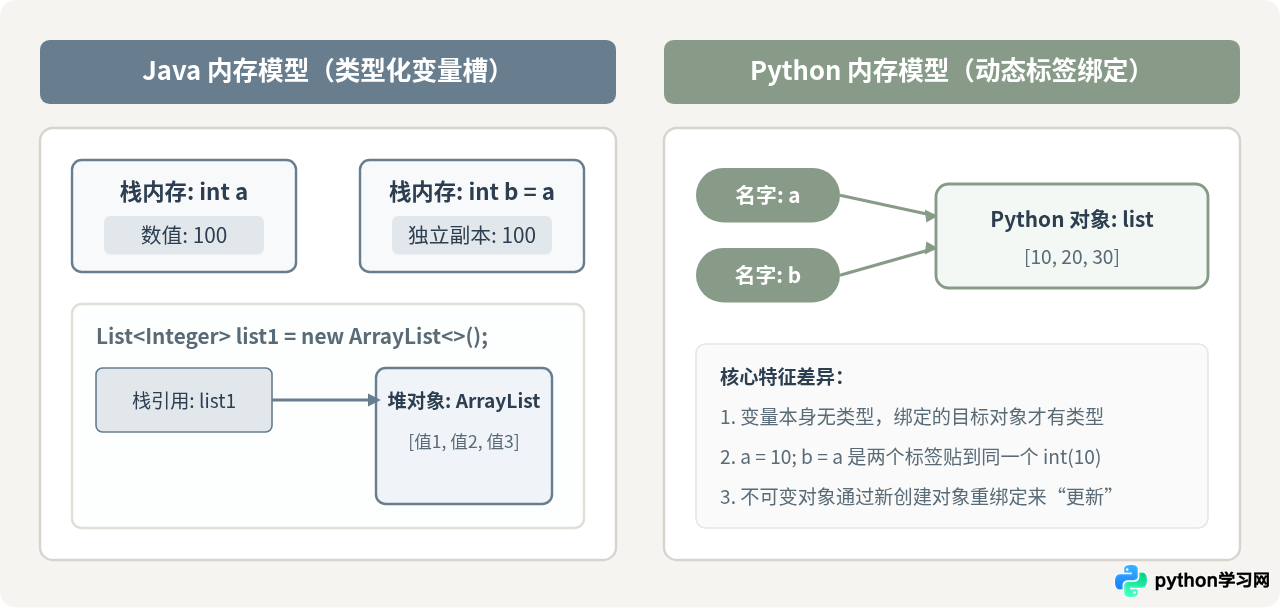
== 在 Python 中比较的是内容相等性(类似 Java 的 equals()),而要判断是否指向同一内存对象,必须使用 is 关键字(对应 Java 的 ==)。
二、不可变类型与可变类型的修改陷阱
Python 将内置数据类型严格划分为不可变类型(Immutable)与可变类型(Mutable):
- 不可变类型:
int、float、bool、str、tuple、frozenset。此类对象创建后其内存内容不可更改。 - 可变类型:
list、dict、set以及大部分自定义类。可以在不改变对象内存地址的情况下就地(in-place)新增、删除或修改元素。
1. 字符串高频拼接性能陷阱
与 Java 的 String 类似,Python 中的 str 也是不可变对象。Java 在循环拼接字符串时会使用 StringBuilder 避免反复分配新对象,而初转 Python 的开发者容易写出如下循环累加代码:
# 陷阱:每次 += 都会分配新字符串并复制旧字符(O(N^2) 耗时)
result = ""
for item in large_dataset:
    result += str(item) + ","

# 避坑规范:收集到列表中使用 str.join() 拼接(O(N) 耗时)
parts = [str(item) for item in large_dataset]
result = ",".join(parts)
2. 浅拷贝导致的嵌套数据污染
在 Java 中复制集合通常会执行 new ArrayList<>(sourceList)。在 Python 中,无论是调用 list.copy()、切片 list[:] 还是内置函数 list(source),都仅仅是浅拷贝(Shallow Copy)。如果列表中包含可变子对象(如嵌套字典或子列表),复制出来的只是子对象的引用指针。
import copy

matrix = [[1, 2], [3, 4]]
shallow_copy = matrix.copy()

# 修改外层容器互不干扰
shallow_copy.append([5, 6])
# matrix 仍为 [[1, 2], [3, 4]]

# 陷阱:修改内层元素会直接污染原始矩阵
shallow_copy[0][0] = 999
print(matrix[0][0])  # 输出 999!原数据被意外篡改

# 避坑规范:包含嵌套可变结构时,显式使用 deepcopy
deep_matrix = copy.deepcopy(matrix)
deep_matrix[0][0] = 100  # 安全,互不影响
三、致命陷阱:函数可变默认参数
在 Java 中,方法重载或在方法体内初始化入参每次都会在调用发生时执行。而 Python 允许在函数定义时指定默认参数,例如 def process(data=[])。这是 Java 转 Python 最常栽跟头的严重隐患。
底层原因:Python 的 def 是一个可执行语句。函数定义时,Python 解释器就会对默认参数表达式进行求值,并将其绑定在函数对象的 __defaults__ 元组中。如果默认参数是可变类型(如 list 或 dict),该对象只会被创建一次,所有未传参的后续调用都将共享这同一个对象实例!
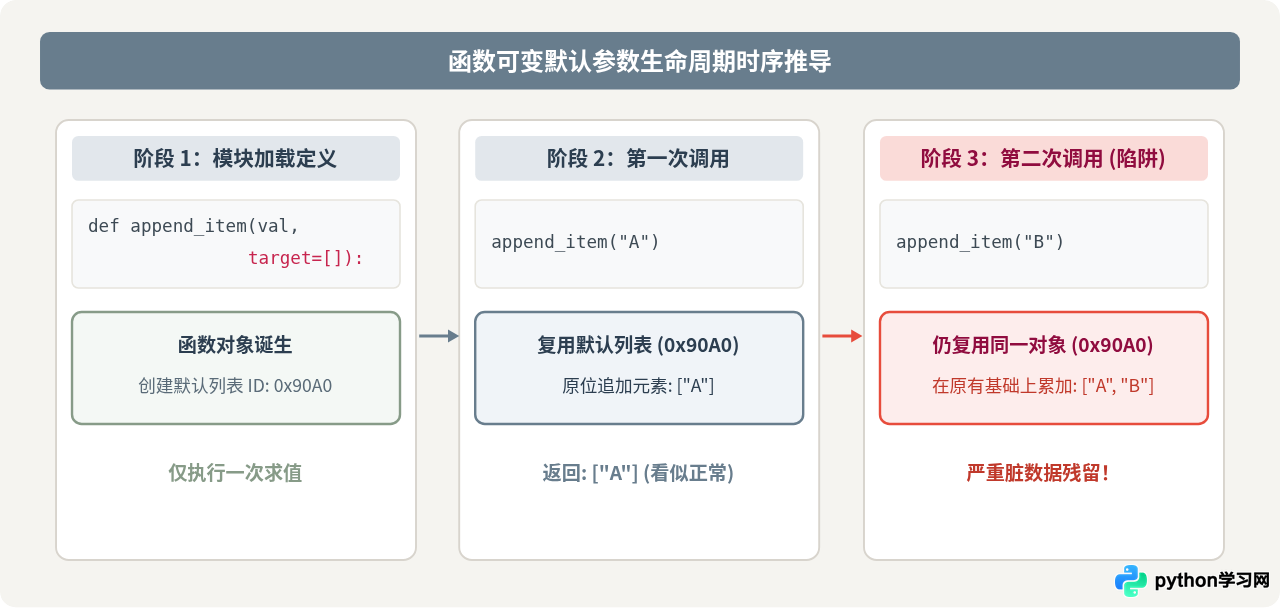
避坑指南与标准规范:在 Python 中,绝不应使用可变对象(如 []、{})直接作为默认参数。正确的做法是使用不可变的 None 作为哨兵值(Sentinel Value),并在函数体内动态判断初始化:
# 规范做法:使用 None 作为占位符
def append_item(val, target=None):
    if target is None:
        target = []  # 每次调用动态创建独立列表
    target.append(val)
    return target
四、数值计算差异:除法模式与截断规则
Java 的数值类型系统层次严谨,分为 byte、short、int、long、float、double。Python 则对数值类型进行了高度抽象,这在带来便利的同时也引入了细微且隐蔽的数学差异。
1. 除法运算符的语义重构
在 Java 中,两个整型使用斜杠 / 相除,得到的结果一定是整型,小数部分会被直接向零截断(Truncation toward zero)。而在 Python 3 中:
- 单斜杠
/称为真除法(True Division),无论操作数是否为整数,返回值一律为浮点型float。 - 双斜杠
//称为底除法/地板除(Floor Division),返回向下取整后的整数商。
2. 负数除法截断方向的差异
Java 和 Python 在处理负数整除时的舍入机制完全不同,这是数学和算法移植时极易产生偏差的角落:
- Java 向零取整(Truncate toward 0):
-5 / 2结果为-2。 - Python 向下取整(Floor toward -infinity):
-5 // 2结果为-3。
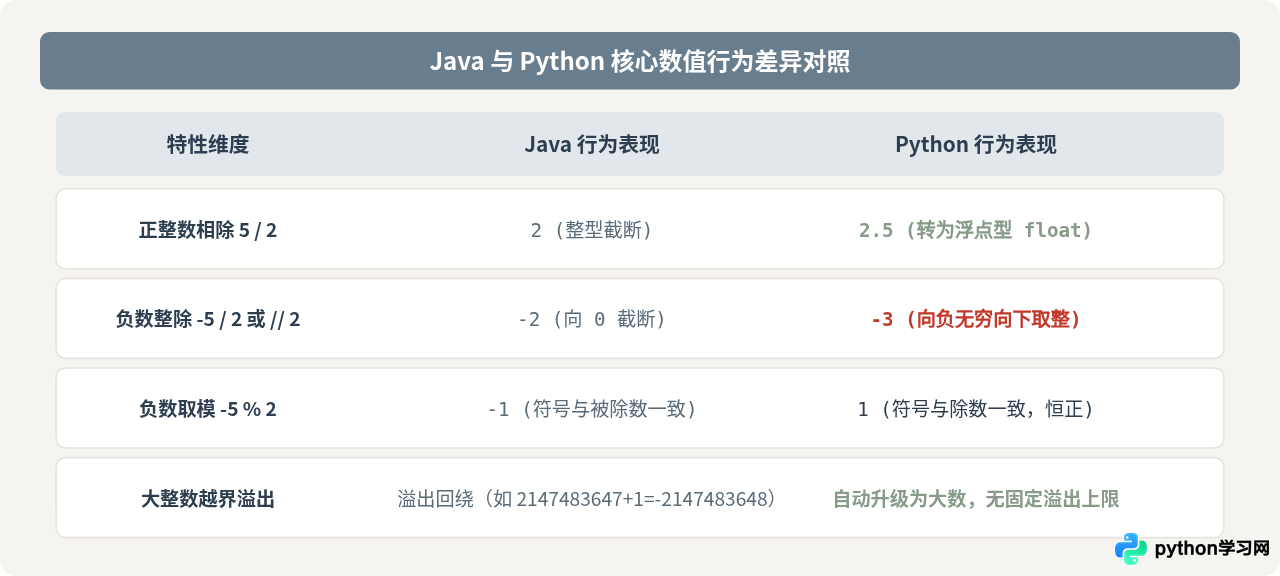
int(a / b) 或借助 math.trunc(a / b)。
五、集合与字典的哈希契约:可哈希性(Hashable)
在 Java 中,任何对象都可以作为 HashMap 的键或 HashSet 的元素,只要对应类正确重写了 equals() 和 hashCode() 方法。若没有重写,则默认根据对象内存地址哈希。
而在 Python 中,对字典键和集合元素有严格的可哈希性(Hashable)要求:
- 一个对象如果拥有在生命周期内永不改变的哈希值(实现了
__hash__()),并且能与其他对象比较(实现了__eq__()),它才是可哈希的。 - Python 的可变集合对象(如
list、dict、set)均没有实现__hash__()(其值为None)。尝试将列表用作字典键会直接触发异常:TypeError: unhashable type: 'list'。
# 陷阱:直接使用 list 作为字典的 key
coordinates = [10, 20]
cache = {}
# cache[coordinates] = "Point A"  # 报错:TypeError: unhashable type: 'list'

# 避坑规范:将不可变序列 tuple 作为 key
cache[tuple(coordinates)] = "Point A"  # 正确无误

# 对于嵌套集合,使用不可变集合 frozenset 代替普通 set
tags = frozenset(["python", "java"])
lookup = {tags: "Programming Languages"}
六、循环中动态修改容器的“静默故障”
在 Java 中,如果在 for-each 增强型循环中直接调用 list.remove(item),运行时会立即抛出 ConcurrentModificationException(快速失败机制 Fail-Fast),强迫开发者使用 Iterator.remove()。
在 Python 中,在 for item in my_list: 遍历的同时执行 my_list.remove(item) 或 del 不会抛出任何异常。Python 解释器在内部使用一个自增的下标指针按索引迭代,当移除了当前位置的元素后,后续元素向前位移填补空缺,导致迭代指针直接跳过紧邻的下一个元素!
# 陷阱代码:在遍历时移除符合条件的元素
numbers = [1, 2, 2, 3, 4]
for n in numbers:
    if n == 2:
        numbers.remove(n)

# 实际输出结果:[1, 2, 3, 4]
# 第二个 2 因为元素左移被迭代器漏掉了!没有任何报错,但逻辑完全错误!

# 避坑规范 1:遍历原容器的切片浅拷贝
for n in numbers[:]:
    if n == 2:
        numbers.remove(n)

# 避坑规范 2(更推荐):使用列表推导式重构生成新列表
numbers = [n for n in numbers if n != 2]
七、系统排查与避坑全景总结
综合以上核心差异,从 Java 转向 Python 编写工程化代码时,建议建立一套针对数据类型和引用特性的核对清单。
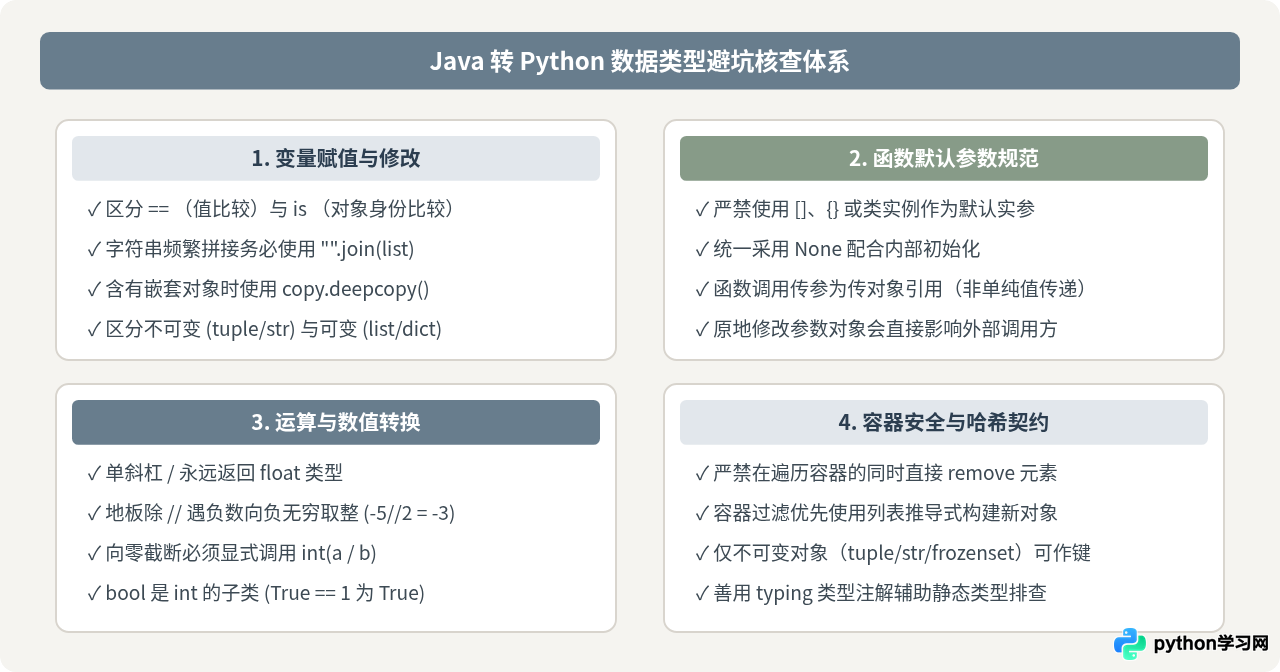
理解 Python 数据类型背后的对象模型与求值时机,是从“用 Java 思维写 Python”迈向“写出地道、安全、健壮的 Pythonic 代码”的关键跃升。在实际编码中保持对对象生命周期与可变性的敏感,结合类型注解(Type Hints)与静态检查工具(如 mypy),能够从源头上规避大部分由于语法直觉差异带来的隐蔽 Bug。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















