


为什么高并发项目首选Java而非Python?底层机制解析

在高并发、大吞吐量的企业级后端服务中,技术栈选型往往决定了系统的性能上限与维护成本。尽管Python在快速原型交付、数据分析与人工智能领域占据主导地位,但在面对每秒数十万请求(QPS)的互联网核心交易与结算系统时,行业主流几乎一致倾向于Java。这种技术偏向并非偶然的生态惯性,而是源于两种语言在多核并行模型、即时编译优化、内存分配与回收,以及工业级I/O管道等底层机制上的根本性差异。
一、并发执行模型:GIL限制与真正多核并行的鸿沟
高并发系统的首要任务是充分压榨服务器的多核CPU资源。在高密度请求到达时,系统需要将不同的计算与I/O任务分发到各个硬件核心上并行处理。Java与Python在操作系统线程的利用机制上存在质的差异。
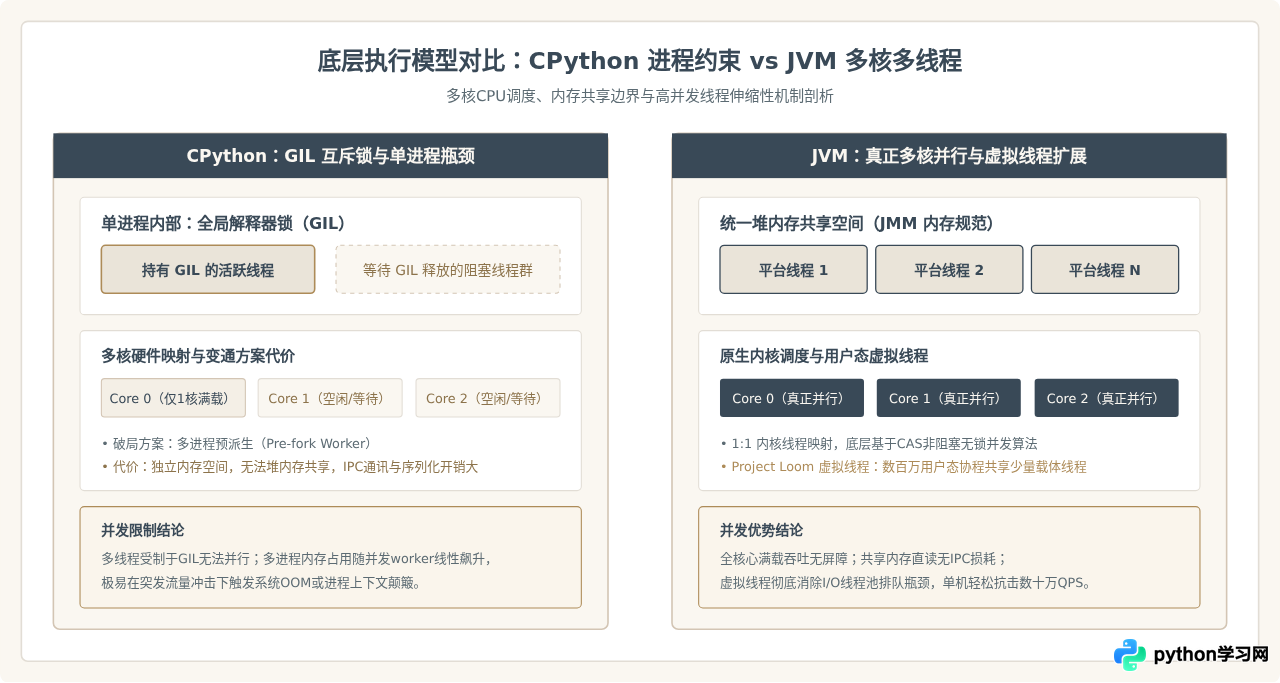
标准CPython解释器采用了全局解释器锁(Global Interpreter Lock,简称GIL)。GIL是一个互斥锁,用于保护Python对象免受并发访问时的竞态破坏。其直接后果是:在同一个Python进程中,无论物理CPU拥有多少个核心,在任意给定时间片内,只能有一个线程在解释器中执行字节码。这意味着纯线程化的Python程序在面对高并发CPU计算或序列化密集型场景时,无法利用多核硬件优势,甚至由于频繁的线程上下文切换与锁争夺,性能低于单线程执行。
为了绕过GIL,Python社区普遍采用多进程架构(如通过Gunicorn或Celery预派生Worker进程)。然而,多进程模型带来了显著的代价:每个子进程都拥有独立的内存空间与解释器副本,进程间无法直接共享堆内存。处理共享状态必须依赖进程间通信(IPC)、共享内存或外部中间件(如Redis),这不仅消耗了数倍的物理内存,还引入了沉重的序列化与反序列化开销。
相比之下,Java HotSpot虚拟机采用了1:1映射模型,Java线程(java.lang.Thread)直接对应操作系统的原生内核线程。JVM中的所有线程共享同一堆内存空间,由操作系统的内核调度器直接调度到不同的物理核心上同时并发运行。Java不仅具备完整的内存模型(Java Memory Model,JMM)来规范多线程可见性与重排序,还在java.util.concurrent(JUC)库中提供了极其成熟的非阻塞并发原语(基于CPU的硬件级CAS原子指令)。
更进一步,自Java 21起正式推出的虚拟线程(Virtual Threads,Project Loom)将并发能力提升到了新维度。虚拟线程将成千上万个用户态轻量级线程挂载在少量操作系统载体线程(Carrier Threads)之上,在保留直观的同步阻塞编程风格的同时,实现了与异步非阻塞I/O相当的高吞吐能力,单个JVM实例即可轻松支撑百万级长连接与并发会话。
二、执行引擎与运行时:JIT编译优化 vs 动态字节码解释
在高并发场景下,业务逻辑(例如协议解析、对象序列化、权限鉴权、业务规则计算)会被执行数十万次甚至数百万次。执行引擎的指令处理效率直接决定了CPU核心在单请求上消耗的微秒数。
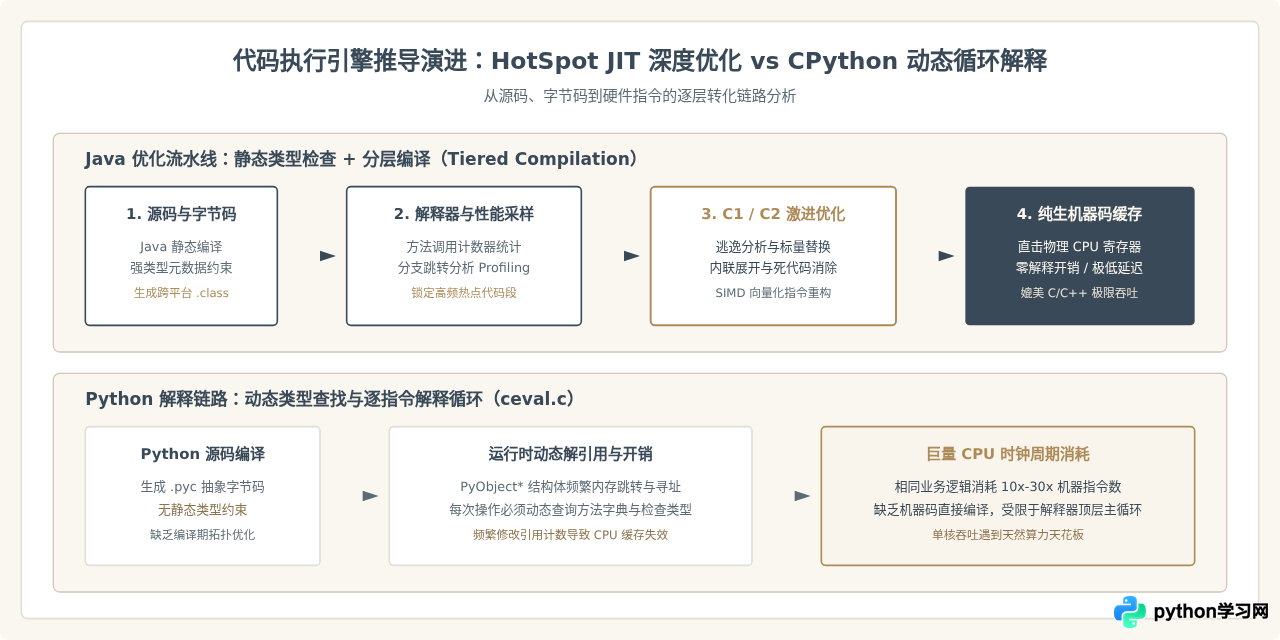
Python是纯粹的动态强类型语言,CPython解释器的运行原理基于评估循环(Evaluation Loop,即ceval.c)。在执行字节码时,解释器无法在编译期获知对象的真实类型。例如,执行简单的加法操作a + b时,解释器必须经历以下步骤:
- 从通用对象指针
PyObject*中解引用获取类型对象ob_type; - 在类型对象的字典中动态查找
__add__方法对应的C函数指针; - 检查参数合法性并装箱新创建的
PyObject对象; - 处理可能的异常与垃圾回收引用计数增减。
这种纯解释性执行方式伴随着大量的指针间接寻址、分支预测失败和CPU指令缓存(I-Cache)未命中,计算开销通常比优化后的机器码高出10到50倍。
Java则采取了完全不同的分层编译策略(Tiered Compilation)。虽然Java源码首先编译为通用的.class字节码,但在JVM(如HotSpot)启动后,运行时系统会全面接管:
- 热点代码探测(Hot Spot Profiling):解释器首先快速运行代码,通过方法调用计数器和回边循环计数器精确收集运行时分支走势、热点路径与类型反馈信息。
- C1 客户端编译器:当某段代码执行频率上升,C1编译器介入进行初级优化,快速生成高效机器码。
- C2 服务端编译器 / Graal:对于真正的高频核心链路,C2编译器进行激进的底层机器码重写优化,包括:
- 方法内联(Method Inlining):消除方法调用栈帧压栈与弹栈开销,打通上下文优化边界;
- 逃逸分析(Escape Analysis):若分析证明某个对象只在当前方法内部生效,JVM会将其标量替换为寄存器或栈上变量,完全避免堆内存分配;
- 循环展开与SIMD向量化:将批量运算自动编译为利用CPU AVX/SSE指令集的单指令多数据并行计算。
经过JIT深度优化后的Java热点代码,其执行性能极其逼近C/C++原生编写的机器码。这意味着处理同样数量的请求,Java所需的CPU时钟周期远远低于Python,极大地降低了高并发系统的计算密集型延迟。
三、网络I/O管道与零拷贝通信架构
在高并发网络服务(如API网关、微服务RPC通信、即时推送)中,网络I/O的吞吐能力决定了系统能否维系数十万长连接。现代操作系统通过epoll(Linux)或kqueue(macOS/BSD)提供多路复用能力,但编程语言如何组织I/O事件驱动架构至关重要。
1. Python Asyncio 的单主线程事件循环痛点
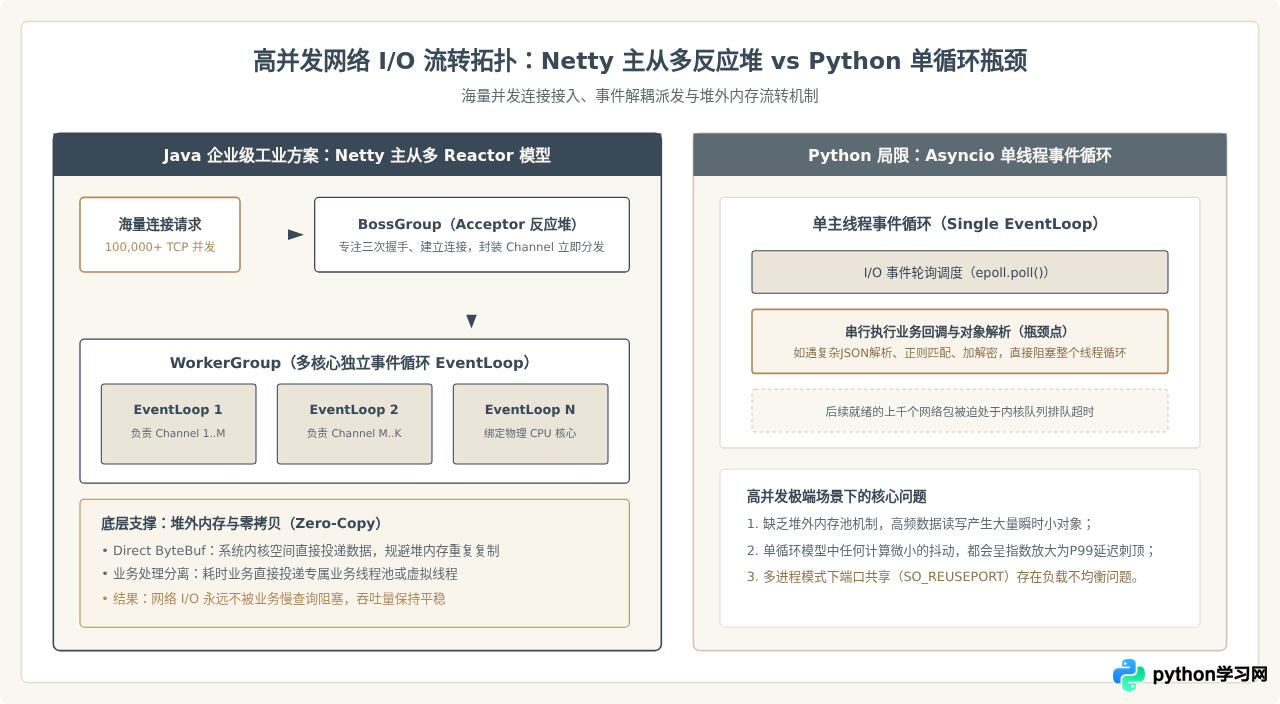
Python通过asyncio库提供了协程异步I/O模型(如FastAPI、Tornado)。在纯网络I/O等待(如等待数据库响应)场景下,asyncio表现优异。然而,其核心架构是单线程事件循环(Single-threaded Event Loop):
- 所有网络事件派发、回调函数执行、JSON数据解析、数据校验与业务逻辑都在同一个系统线程中串行执行;
- 如果某个请求包含耗时10毫秒的复杂对象解包或加密计算,整个事件循环将被卡死10毫秒,导致后续成百上千个准备就绪的I/O事件无法被按时调度,造成整体P99延迟瞬间恶化;
- 虽然可以通过
run_in_executor将阻塞任务投递到进程池,但频繁的数据跨进程拷贝和上下文切换会快速吞噬系统资源。
2. Java 工业级反应堆网络架构(Netty)
Java在网络层拥有历经二十年高压验证的基础设施——Netty。Netty采用了高度优化的多反应堆主从模型(Multi-Reactor Pattern):
- Boss Group 线程池:专门负责监听网络端口并建立客户端TCP连接,接收连接后迅速移交给工作池,完全不受业务逻辑干扰;
- Worker Group 线程池:由多个与CPU物理核心相匹配的EventLoop组成,独立轮询处理对应Socket的数据读写;
- 零拷贝与堆外内存(Direct ByteBuf):Netty通过JNI直接调用操作系统的
sendfile和堆外物理内存池(Off-Heap Buffer),网络数据包从网卡缓冲区读取后,无需在JVM堆内进行二次数据复制即可直接写入目标管道,极大降低了GC压力与CPU拷贝开销。
四、内存管理与垃圾回收(GC)工程稳定性
在高并发场景下,每秒涌入的几十万请求意味着系统每秒都要分配成千上万个数据对象(DTO、请求上下文、字符串、缓冲区)。内存分配的效率以及垃圾回收器的暂停时间(STW),直接决定了系统能否提供平稳的SLA服务级别协议。
1. Python 的引用计数与分代循环检测
Python的内存回收核心依赖引用计数机制(Reference Counting),辅助以分代循环检测(Generational GC):
- 频繁的缓存颠簸:每个Python对象头都有一个
ob_refcnt计数器。无论是变量赋值、作为函数参数传递,还是存入列表,都会执行引用计数的加减操作。在大规模并发读取时,多个CPU核心同时修改同一内存地址的引用计数,会导致CPU的L1/L2数据缓存行(Cache Line)不断发生伪共享与失效,显著消耗内存总线带宽; - 垃圾回收暂停(Stop-The-World):为了解决循环引用问题,Python定期触发分代检测。当老年代(Generation 2)对象数量达到阈值时,触发全局链表扫描。由于无法做到与业务线程并发运行,这种检测会引起偶发但明显的请求卡顿。
2. JVM 分代假说、TLAB 与现代并发低延迟收集器
Java在内存管理工程上投入了长达几十年的工业级优化,其核心优势体现在分配机制与并发回收算法两方面:
- TLAB(Thread Local Allocation Buffer)无锁分配:在JVM中,每个线程在Eden区预先分配一块私有的内存缓冲区。当创建新对象时,线程直接在本地TLAB通过指针碰撞(Bump-the-pointer)完成内存分配,全程不需要加任何全局锁,速度等同于C语言的栈上分配。
- 弱分代假说(Weak Generational Hypothesis):绝大多数高并发请求所创建的对象(如HTTP Body、解析临时对象)都是“朝生夕死”的。JVM新生代GC(如G1 Young GC)能在数毫秒内高速批量回收上百兆无用内存。
- 现代亚毫秒级并发收集器(ZGC / Shenandoah):自Java 17起成熟的ZGC采用了着色指针(Colored Pointers)与读屏障(Load Barriers),使得对象标记、内存转移、指针重映射等原本耗时的步骤全部与业务线程并发执行。无论堆内存是16GB还是16TB,GC暂停时间始终稳定在1毫秒以内,彻底消除了困扰大型系统的高延迟毛刺。
五、并发工具链与生产级生态完整度
底层机制的强大最终需要体现在开发者日常使用的工程构件中。Java生态在高并发领域的成熟度体现在一系列开箱即用的工业级组件中:
| 核心维度 | Java 生态解决方案与底层支撑 | Python 生态表现与技术局限 |
|---|---|---|
| 线程安全集合 | ConcurrentHashMap、CopyOnWriteArrayList,基于细粒度锁与CAS无锁并发控制 |
原生dict和list依赖全局解释器锁保护;多进程下必须使用共享字典或Redis中转 |
| 并发同步原语 | 基于AQS(AbstractQueuedSynchronizer)的ReentrantLock、CountDownLatch、Semaphore |
标准库提供threading.Lock但受GIL调度制约;跨进程锁性能极低且容易出现死锁 |
| 连接池与资源复用 | HikariCP(高并发数据库连接池,字节码优化)、Netty对象池Recycler |
DB连接池在多进程模型下每个worker独立维护,容易耗尽数据库连接数或依赖外部PgBouncer |
| 观测与运行时排查 | JVM 深度内省工具链:JProfiler、Async-Profiler、Arthas(不重启线上实时热诊追踪) | 排查生产多进程死锁或内存泄露相对繁琐,侵入性调试工具对线上吞吐损耗明显 |
六、架构选型与高并发决策总结
选择Java还是Python并非简单的语言优劣之争,而是不同工程哲学在特定应用场景下的取舍:
- Python 的绝对主场:在数据工程、机器学习模型训练与推理编排(通过C/C++底层绑定的PyTorch/TensorFlow)、自动化运维以及中轻量级Web原型开发中,Python凭借无与伦比的开发效率和胶水整合能力无可替代。
- Java 的不可撼动领域:在金融交易结算、大型电商订单网关、实时流计算(Flink/Kafka)等吞吐量达到数十万QPS、且要求P99延迟低于5毫秒的核心系统里,Java凭借无GIL约束的真多核并发、JIT极致性能机器码编译、ZGC亚毫秒垃圾回收以及稳固的工业级类库,构成了无法被轻易超越的底层护城河。
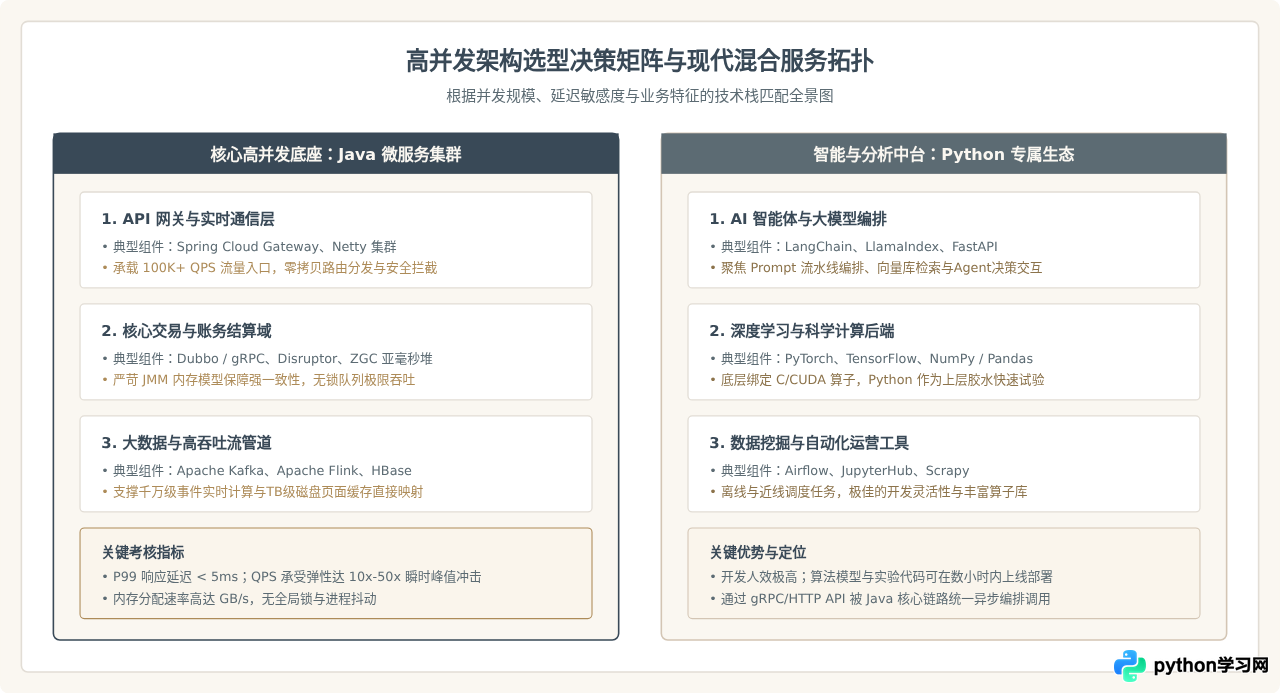
现代大规模互联网系统的终极架构演进,并非非此即彼的排他竞争,而是走向各取所长的混合架构:采用 Java 构筑扛住海量连接与资金一致性要求的核心高并发管道,同时将 Python 部署在内网作为 AI、算法推荐与离线分析的计算节点。在单体系统需要独自抗击数十万级高并发吞吐的关键战役中,Java 在底层线程、编译优化、I/O 调度与内存管理上的深厚积淀,依然是工业界最坚实的技术基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















