


Python怎么解析URL获取域名、路径和参数
详细讲解在Python中使用标准库urllib.parse解析URL,提取网络协议、域名、端口、路径以及查询参数的方法与实战注意事项。
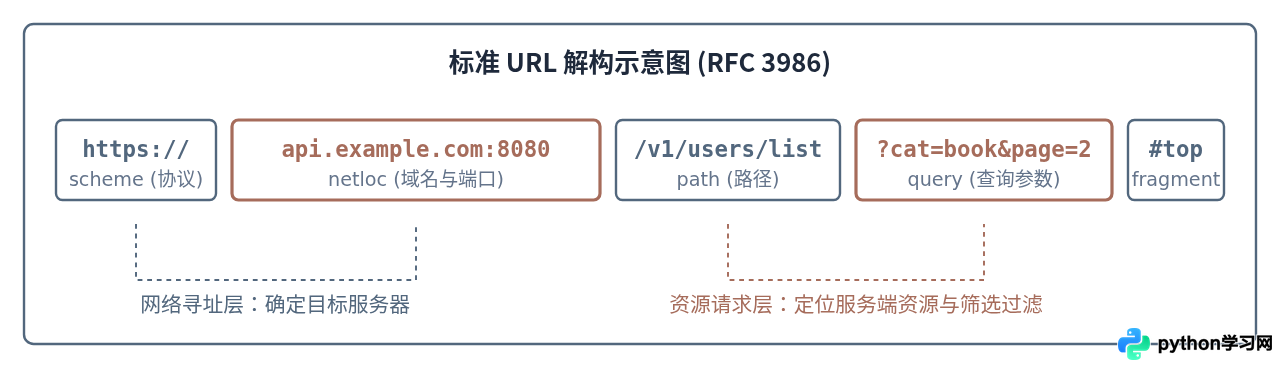
在Python中解析URL不需要安装任何第三方库,标准库自带的 urllib.parse 模块提供了拆解URL的完整工具链。其中,使用 urlparse 可以把URL切分为协议、网络位置(含域名与端口)、路径等组件,而利用 parse_qs 则能把末尾的查询字符串进一步转成键值对字典。本文将通过具体的分解演示与代码示例,带你理清URL各部分的提取方式与常见边界情况。
一、使用 urlparse 拆解核心组件
很多人在尝试提取域名或路径时会习惯性地使用字符串的 split('/'),这往往在遇到带端口、不带协议头或参数中包含特殊字符时出错。Python内置的 urllib.parse.urlparse 是标准的解析入口,它会将传入的URL字符串解析为一个 ParseResult 命名元组对象。
from urllib.parse import urlparse

url = "https://api.example.com:8080/v1/users/list?category=books&page=2#heading"
parsed = urlparse(url)

print("协议 (scheme):", parsed.scheme)
print("网络位置 (netloc):", parsed.netloc)
print("纯域名 (hostname):", parsed.hostname)
print("端口 (port):", parsed.port)
print("路径 (path):", parsed.path)
print("原始参数 (query):", parsed.query)
print("锚点 (fragment):", parsed.fragment)
执行上述代码后的示例输出如下:
协议 (scheme): https
网络位置 (netloc): api.example.com:8080
纯域名 (hostname): api.example.com
端口 (port): 8080
路径 (path): /v1/users/list
原始参数 (query): category=books&page=2
锚点 (fragment): headingnetloc 包含端口号以及认证信息(如 user:pass@host:port),如果只需要目标域名,直接读取 parsed.hostname 更加安全,该属性会自动剥离端口并自动将域名转为小写。
二、提取并结构化查询参数
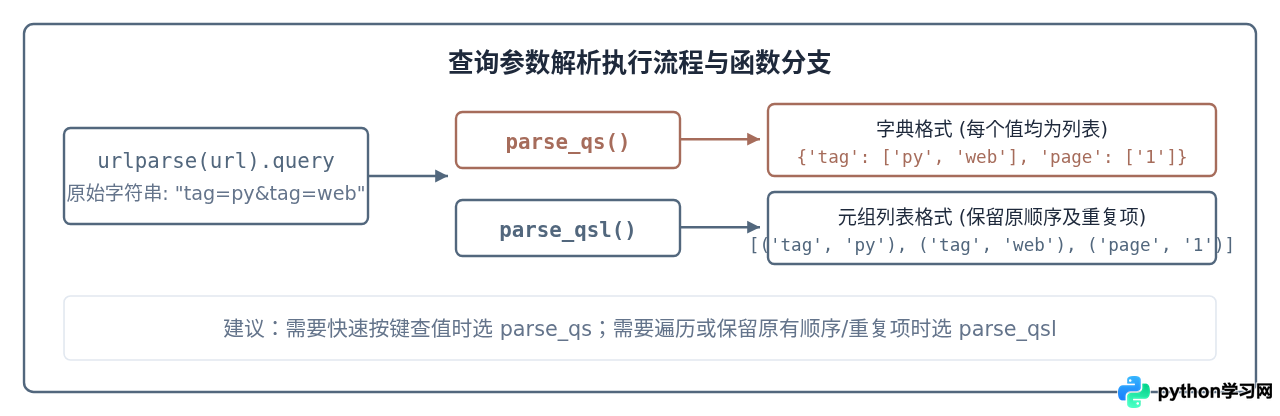
urlparse 返回的 query 只是一个原始字符串(例如 category=books&page=2)。为了在代码中直接读取具体参数,需要用到 parse_qs 或 parse_qsl。
1. 使用 parse_qs 解析为字典
parse_qs 会自动完成 URL 解码(Percent-decoding),并将每一个参数名映射为一个列表。这是因为在 HTTP 标准中,同一个参数名可以出现多次(如复选框提交的 tag=python&tag=web)。
from urllib.parse import urlparse, parse_qs

url = "https://example.com/search?keyword=python+%E6%95%99%E7%A8%8B&tag=backend&tag=web"
query_str = urlparse(url).query
params = parse_qs(query_str)

print("解析结果字典:", params)
print("解码后的关键字:", params.get('keyword', [''])[0])
print("所有标签:", params.get('tag', []))
示例输出:
解析结果字典: {'keyword': ['python 教程'], 'tag': ['backend', 'web']}
解码后的关键字: python 教程
所有标签: ['backend', 'web']
2. 使用 parse_qsl 转换为键值对列表
如果不希望处理字典中嵌套的列表,或者想完全保留参数在URL中出现的顺序,可以使用 parse_qsl(qs list),它返回包含 (key, value) 元组的列表:
from urllib.parse import urlparse, parse_qsl

url = "https://example.com/items?sort=asc&filter=active"
pairs = parse_qsl(urlparse(url).query)

print("元组列表:", pairs)
# 如果确定没有同名参数,可直接转为普通单值字典
flat_params = dict(pairs)
print("简化扁平字典:", flat_params)
三、实战解析与容错处理步骤
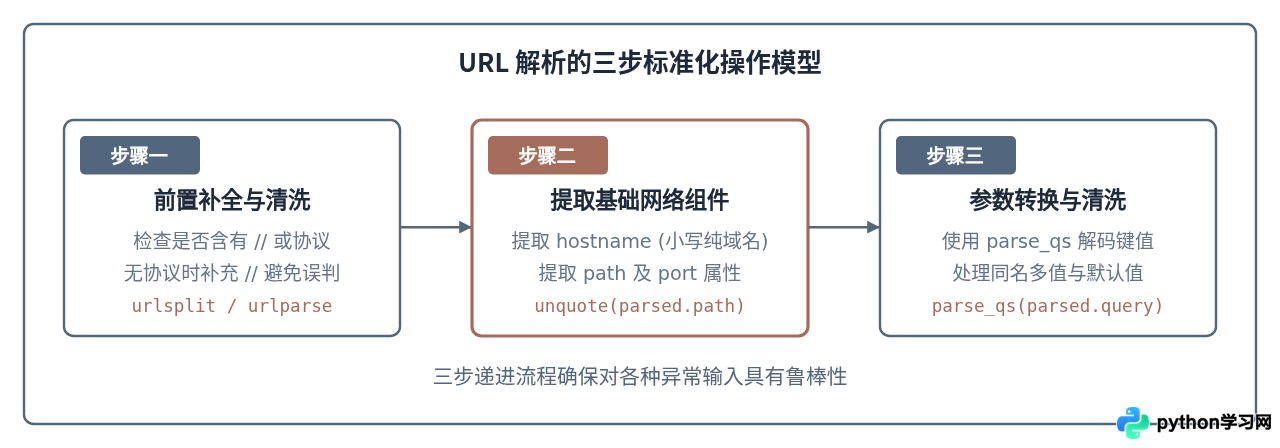
在实际生产环境中,待解析的URL往往并不规范,例如缺少 https:// 协议头、包含中文路径或混杂非标准的相对路径。掌握以下三个标准化步骤能够避免解析异常:
常见边界情况与解决方式
1. URL 缺失协议前缀(如 example.com/path)
按照 RFC 规范,如果字符串不以 // 或协议开头,urlparse 会将整串字符直接当成 path,导致提取到的 netloc 为空。解决方法是在解析前预先检查:
from urllib.parse import urlparse

raw_url = "example.com/articles?id=10"
if not raw_url.startswith(('http://', 'https://', '//')):
    raw_url = '//' + raw_url

res = urlparse(raw_url)
print("域名:", res.hostname)  # 输出: example.com
print("路径:", res.path)      # 输出: /articles
2. 路径中含有中文字符或已转义的特殊字符
浏览器发送的URL通常会对中文进行百分比编码(如 /docs/%E6%89%8B%E5%86%8C)。提取出的 path 仍是编码串,如果需要阅读或存储真实路径,调用 urllib.parse.unquote 即可还原:
from urllib.parse import urlparse, unquote

encoded_url = "https://wiki.org/wiki/%E4%BA%BA%E5%B7%A5%E6%99%BA%E8%83%BD"
path = urlparse(encoded_url).path
readable_path = unquote(path)

print("还原后的路径:", readable_path)  # 输出: /wiki/人工智能
四、封装与总结对比
在日常开发或数据爬取项目中,我们可以把以上逻辑整理为一个健壮的工具函数,统一返回包含纯域名、端口、路径与参数字典的对象。
from urllib.parse import urlparse, parse_qs, unquote

def extract_url_elements(url_string):
    """从URL中统一解析域名、端口、解码路径及参数字典"""
    target = url_string.strip()
    if not target.startswith(('http://', 'https://', '//')):
        target = '//' + target

    parsed = urlparse(target)
    return {
        "hostname": parsed.hostname,
        "port": parsed.port,
        "path": unquote(parsed.path),
        "params": parse_qs(parsed.query)
    }

# 测试调用
sample = "https://api.v2.test.cn:9000/%E6%95%B0%E6%8D%AE/query?token=xyz123&type=full"
result = extract_url_elements(sample)
print(result)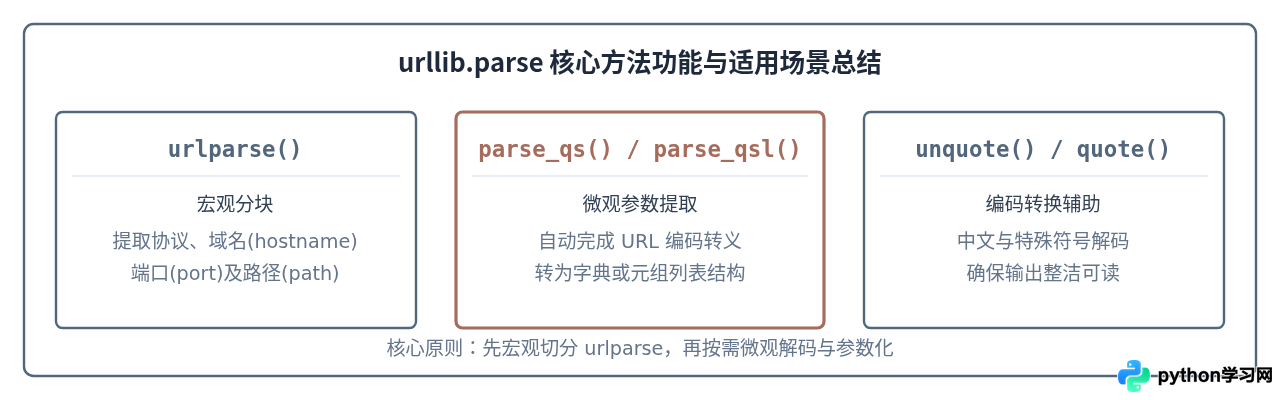
通过组合标准库中的 urlparse、parse_qs 与 unquote,你可以在纯标准库环境下以最高效、最稳健的方式准确获取URL中的任意组成部分。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















