


Python嵌套字典怎么取值:多层级数据访问方法
全面讲解Python中嵌套字典与多层级数据结构的取值方法,涵盖多级方括号访问、链式get()容错机制、动态路径提取函数、混合列表解析及异常捕获,提供实用代码与图解。
在 Python 中处理 JSON 响应、配置文件或树状数据模型时,常常会遇到多层嵌套字典(Nested Dictionaries)。从这类结构中获取深层数值的核心路径可以概括为两类:在键名确定存在时使用连续方括号索引 data['k1']['k2'];在键名可能缺失或结构不完全已知时,使用链式防护 .get()、路径遍历函数或结构化异常捕获。本文将针对各种典型场景,系统梳理从基础到生产环境的各级取值实现方案与避坑准则。
一、基础方案:连续方括号直接索引法
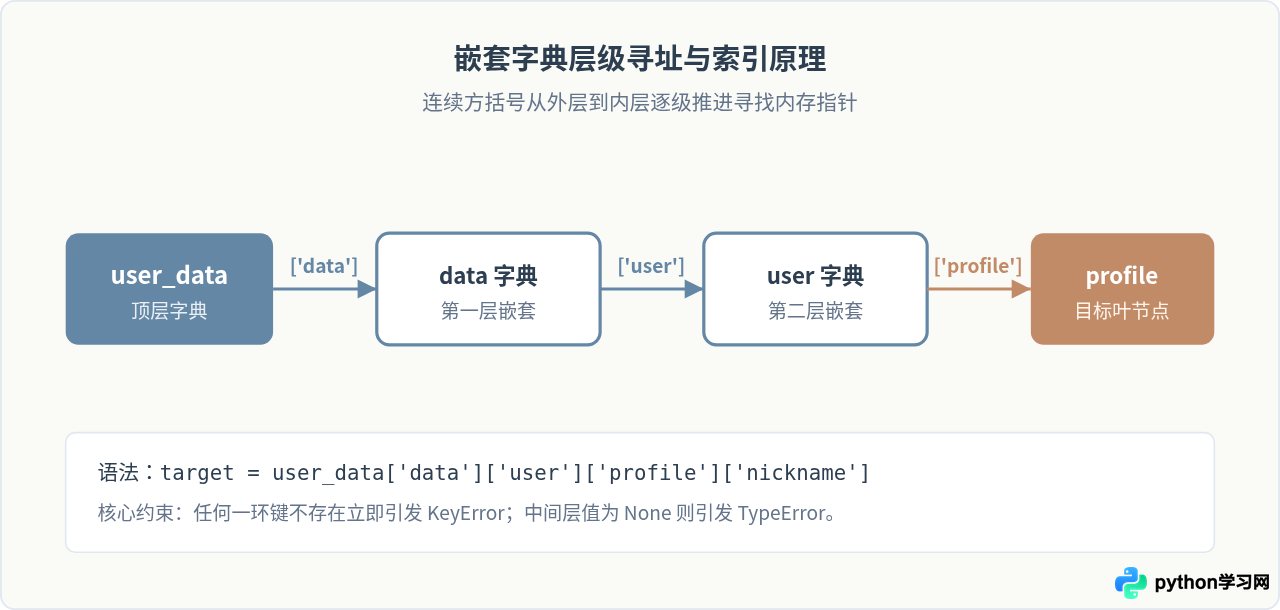
直接通过多层方括号逐级指定键名,是 Python 访问嵌套字典最直观、执行效率最高的方式。每一层方括号解析出一个内层字典,再作为下一个方括号的操作对象。
# 示例:基础多层字典
user_data = {
    "status": "success",
    "data": {
        "user": {
            "id": 1001,
            "profile": {
                "nickname": "Alex",
                "email": "alex@example.com"
            }
        }
    }
}

# 连续多层方括号取值
nickname = user_data["data"]["user"]["profile"]["nickname"]
print("获取到的昵称:", nickname)
# 运行结果输出(示例)
获取到的昵称: Alex直接索引机制要求路径上的每一个键都必须严格存在,并且每一级中间对象都必须是字典类型。如果某一级键缺失,Python 会抛出 KeyError;如果某一中间层的值是 None 或其他非映射类型,则会抛出 TypeError。
二、容错方案:链式 .get() 与防击穿技巧
当面对外部接口返回的动态数据时,某些字段可能缺省。常规单层字典使用 dict.get(key, default) 可以安全降级,但在多层嵌套中直接连缀 dict.get().get() 会潜藏严重缺陷。
1. 连缀 .get() 的常见崩溃陷阱
# 危险示例:未设有效默认值的链式 get
bad_attempt = user_data.get("data").get("missing_key").get("id")
# 如果 missing_key 不存在,返回 None
# 后续针对 None 调用 .get("id") 会抛出:
# AttributeError: 'NoneType' object has no attribute 'get'
2. 安全防护写法:注入空字典兜底与短路求值
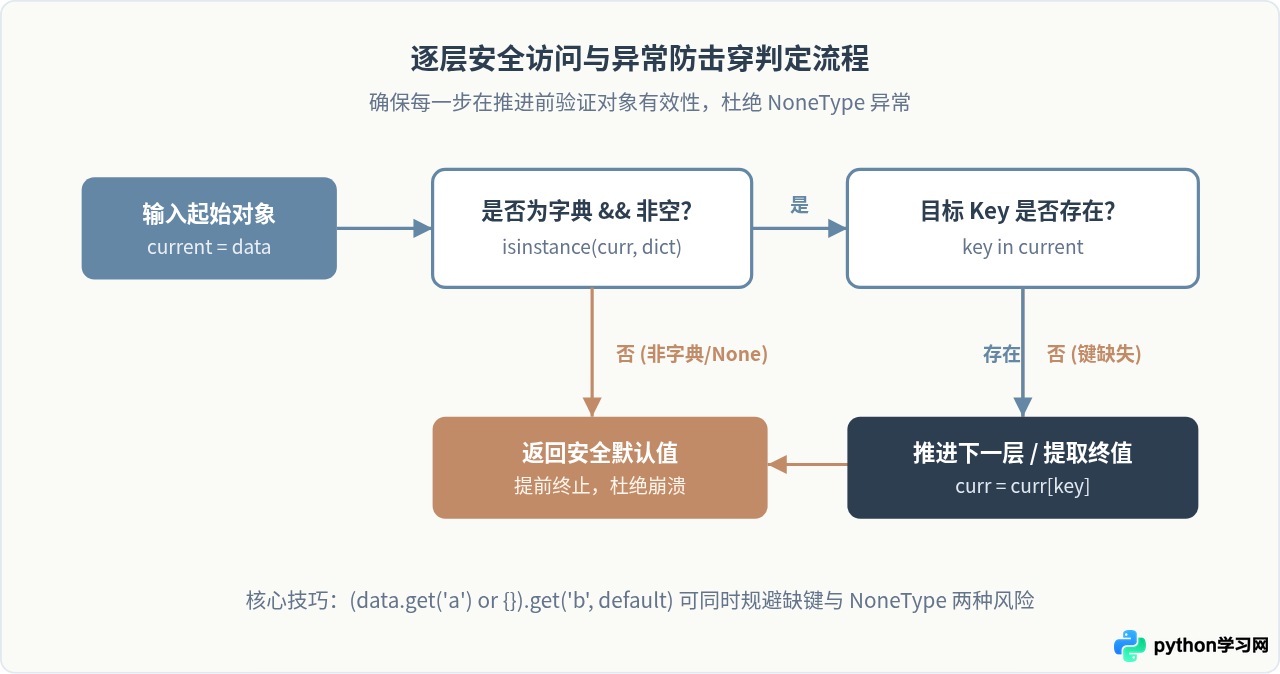
为了防止中间层产生 NoneType 导致程序崩溃,必须在每一层 .get() 的第二个参数提供默认空字典 {},或者利用布尔短路操作符 or:
# 防护写法 A:显式提供空字典作为兜底对象
nickname = user_data.get("data", {}).get("user", {}).get("profile", {}).get("nickname", "默认昵称")
print("安全获取(写法A):", nickname)

# 防护写法 B:使用 or {} 应对键存在但显式为 None 的场景
user_profile = ((user_data.get("data") or {}).get("user") or {}).get("profile") or {}
age = user_profile.get("age", 18)
print("安全获取(写法B):", age)
# 运行结果输出(示例)
安全获取(写法A): Alex
安全获取(写法B): 18None(例如 "user": None),仅依靠 .get("user", {}) 并不能阻止返回 None,因为此时键存在,默认值 {} 不会生效。此时必须结合 (data.get("user") or {}) 才能彻底杜绝 AttributeError。
三、深层通用方案:基于路径列表的解析函数
当嵌套层级超过三层,或者访问路径来自于配置文件、用户参数等动态数据时,手写冗长的 .get() 链条既难以维护又容易遗漏。此时应当封装通用的路径寻址函数。
1. 迭代循环实现:健壮且易于调试
通过 Python 的 for 循环按序遍历键名列表,在每一步中校验对象是否具备字典特性:
def get_nested_value(data, keys, default=None):
    """
    通过键名列表安全获取多层嵌套字典的值
    :param data: 待提取的字典对象
    :param keys: 路径列表,例如 ["data", "user", "profile", "email"]
    :param default: 任意一层查找失败时的默认返回值
    """
    curr = data
    for k in keys:
        if not isinstance(curr, dict):
            return default
        if k not in curr:
            return default
        curr = curr[k]
    return curr

# 测试多路径提取
path_a = ["data", "user", "profile", "email"]
path_b = ["data", "user", "settings", "theme"]

print("存在路径提取:", get_nested_value(user_data, path_a, "未知邮箱"))
print("缺失路径提取:", get_nested_value(user_data, path_b, "light"))
# 运行结果输出(示例)
存在路径提取: alex@example.com
缺失路径提取: light2. 高阶函数实现:使用 functools.reduce
如果偏好函数式编程,可以使用标准库内置的 functools.reduce,以极简的代码完成逐层推进:
from functools import reduce

def deep_get(dictionary, keys, default=None):
    try:
        return reduce(lambda d, k: d[k] if isinstance(d, dict) else default, keys, dictionary)
    except (KeyError, TypeError, IndexError):
        return default

# 一行调用完成多级安全提取
email = deep_get(user_data, ["data", "user", "profile", "email"], "无")
print("reduce提取结果:", email)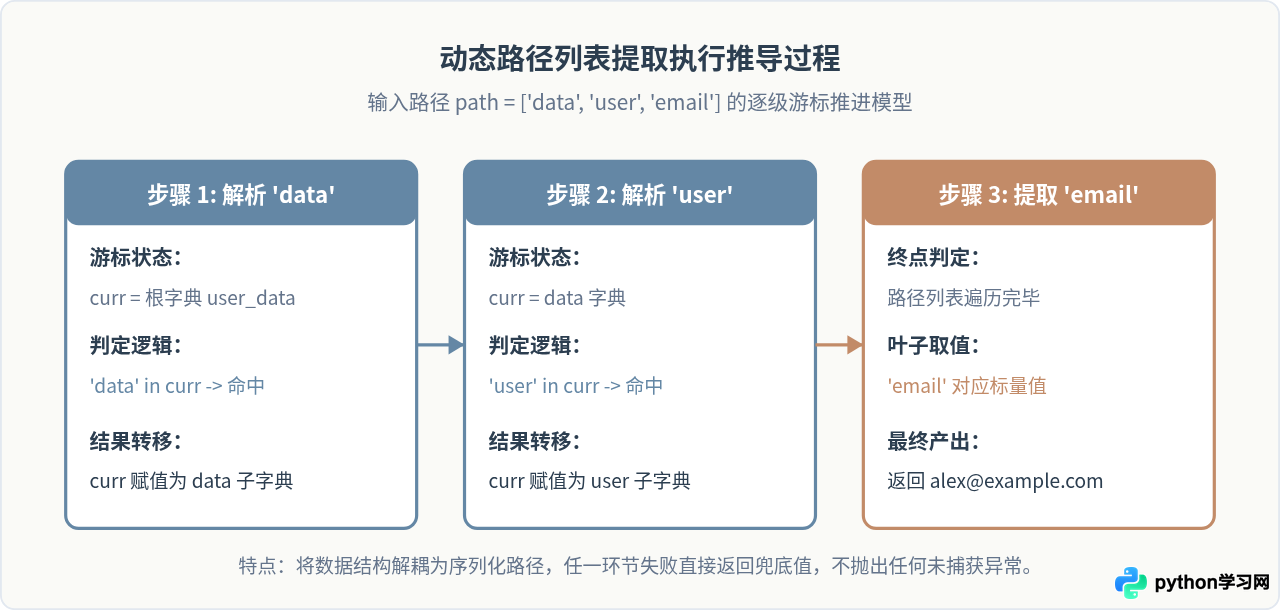
四、混合结构:字典嵌套列表与列表嵌套字典
现实开发中最普遍的 JSON 响应往往并非纯字典,而是字典与列表的交替组合。例如列表包含在某个键中,列表内部又包含若干对象。此时取值需要将字符串键(Key)与整数索引(Index)结合使用。
# 典型的混合结构数据
api_response = {
    "code": 200,
    "payload": {
        "total": 2,
        "items": [
            {"id": "prod_01", "name": "机械键盘", "tags": ["数码", "外设"]},
            {"id": "prod_02", "name": "显示器支架", "tags": ["办公", "配件"]}
        ]
    }
}

# 访问第一件商品的名称:交替使用字典键与列表索引
first_item_name = api_response["payload"]["items"][0]["name"]
print("首件商品名称:", first_item_name)

# 访问第二件商品的第一项标签
second_item_tag = api_response["payload"]["items"][1]["tags"][0]
print("第二件首个标签:", second_item_tag)
# 运行结果输出(示例)
首件商品名称: 机械键盘
第二件首个标签: 办公KeyError,还包括列表越界引发的 IndexError。若要编写通用路径提取器,应允许路径元素既包含字符串键,也包含整型下标,并使用 isinstance(curr, (dict, list)) 进行类型适配。
五、高性能场景:try...except 异常捕获策略
在 Python 理念中,有一种著名的模式叫做“请求原谅比请求许可更容易”(EAFP: Easier to Ask for Forgiveness than Permission)。如果在处理海量数据流时,绝大多数记录都具有规范完整的结构,那么每次都用 if key in dict 或频繁调用 .get() 会带来额外的条件判断开销。
此时直接使用多级方括号访问,并辅以 try...except 结构,是性能最出色且代码极其整洁的方案:
def extract_user_city(record):
    try:
        # 直接按理想结构深层提取
        return record["user"]["address"]["geo"]["city"]
    except (KeyError, TypeError):
        # 无论是键缺失(KeyError)还是中间某层为 None(TypeError),均在此处平滑兜底
        return "默认城市"

# 正常结构测试
data_valid = {"user": {"address": {"geo": {"city": "上海"}}}}
print("有效数据提取:", extract_user_city(data_valid))

# 异常结构测试(address 值为 None)
data_corrupt = {"user": {"address": None}}
print("破损数据提取:", extract_user_city(data_corrupt))
# 运行结果输出(示例)
有效数据提取: 上海
破损数据提取: 默认城市六、方法对比与选型决策指南
不同的访问方式适用于不同的工程环境。在实际项目中,可以根据数据可控性、层级深度及容错要求进行选择:
| 取值方法 | 典型语法 | 主要优势 | 潜在风险 / 限制 | 推荐使用场景 |
|---|---|---|---|---|
| 连续方括号 | d['a']['b']['c'] |
执行速度极快,语法最简练 | 遇缺失直接抛出 KeyError | 内部稳定数据、单元测试断言 |
| 链式防护 get | (d.get('a') or {}).get('b') |
标准库原生支持,防击穿 | 层级深时可读性差,易漏写 | 2~3 层中浅层结构,局部容错 |
| 动态路径函数 | get_nested(d, ['a','b']) |
解耦路径,支持深度与动态配置 | 需引入辅助函数,有微量遍历损耗 | 配置项读取、动态 API 解析 |
| try...except 结构 | try: ... except: ... |
大批量吞吐性能最佳,集中容错 | 无法精确定位哪一层键缺失 | 大数据批处理、ETL 清洗管道 |
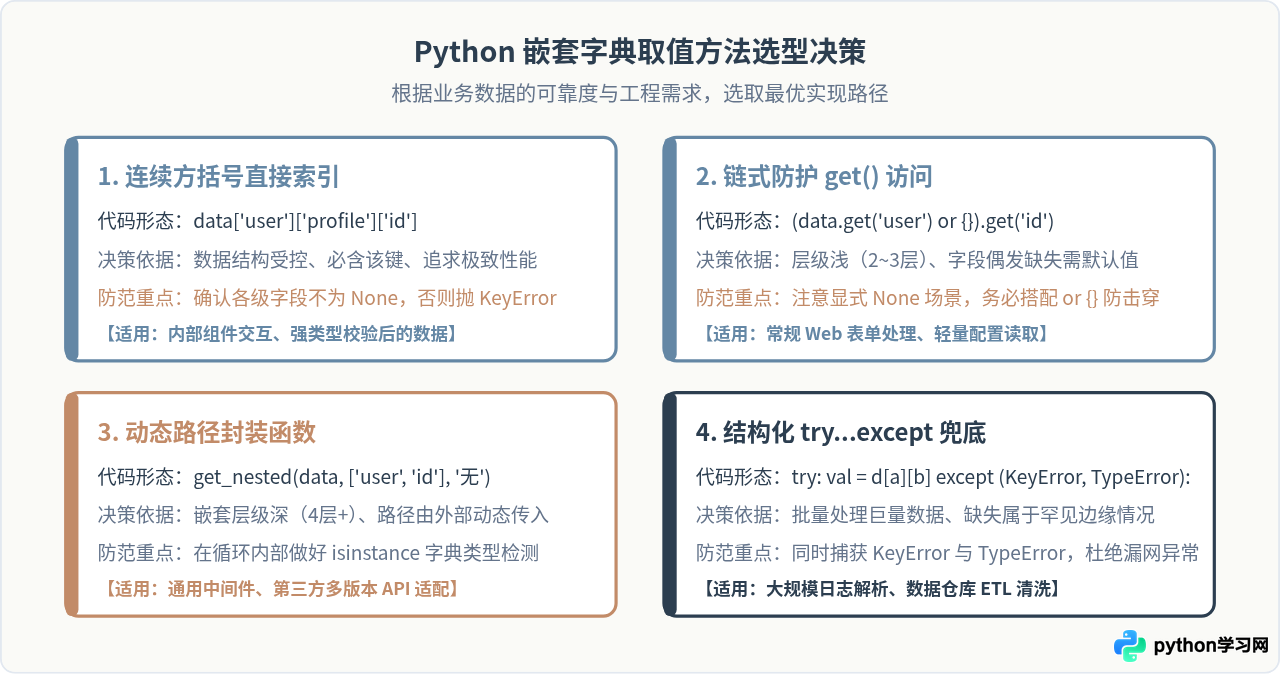
七、常见报错原因与排查自查清单
在调试多层嵌套字典取值时,遇到异常通常遵循以下顺序排查定位:
- 出现
KeyError: 'some_key':说明当前级别的字典中确实没有这个键。排查方式:打印上一层级的所有可用键print(current_dict.keys()),核对是否存在大小写不一致或拼写错误。 - 出现
TypeError: 'NoneType' object is not subscriptable:说明上一级虽然没有引发 KeyError,但取出来的真实值是None,你正在对None执行[...]下标操作。排查方式:将取值拆分为独立变量,逐步验证哪一层变成了None。 - 出现
AttributeError: 'NoneType' object has no attribute 'get':说明在执行链式.get()时,前面的.get()返回了None,而你未给它指定安全回退字典。排查方式:将.get('key')改写为(data.get('key') or {})。 - 出现
IndexError: list index out of range:说明在混合结构中访问列表下标时超出了数组长度。排查方式:在取索引前校验len(list_obj) > index。
掌握以上取值策略与异常规避方案后,便能够从容应对 Python 中各种复杂嵌套数据源,确保程序兼具高运行效率与生产级容错表现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















