


Python结合正则表达式验证密码长度及字符规则
介绍如何使用 Python 结合正则表达式验证密码的长度与字符组成规则,对比单条复杂正则先行断言与多规则拆解验证两种实现方式,并提供完整的代码示例与工程选型建议。
验证密码是否符合长度与字符复杂度要求,是各类网站用户注册与身份安全模块的基础环节。在 Python 中实现这一验证,主要有两种技术路线:一种是利用正则表达式的正向先行断言(Lookahead Assertion),使用单条正则表达式在毫秒级内完成所有维度的综合匹配;另一种是将长度检测与各类字符集的匹配规则分步拆解,通过逐项比对输出详细的校验结果。本文将详细解析这两种实现方式的具体原理、编写方法、适用场景及注意事项,帮助开发者根据业务需求快速构建健壮的密码校验逻辑。
一、单条正则表达式:利用先行断言一次性验证
很多开发者在初次尝试用正则表达式验证密码时,往往习惯使用普通的字符集匹配,例如 ^[A-Za-z0-9@$!%*?&]{8,20}$。这种表达式仅能限制密码长度在 8 到 20 位之间,且字符只能取自指定范围,却无法强制要求“同时包含”大写字母、小写字母、数字和特殊符号。
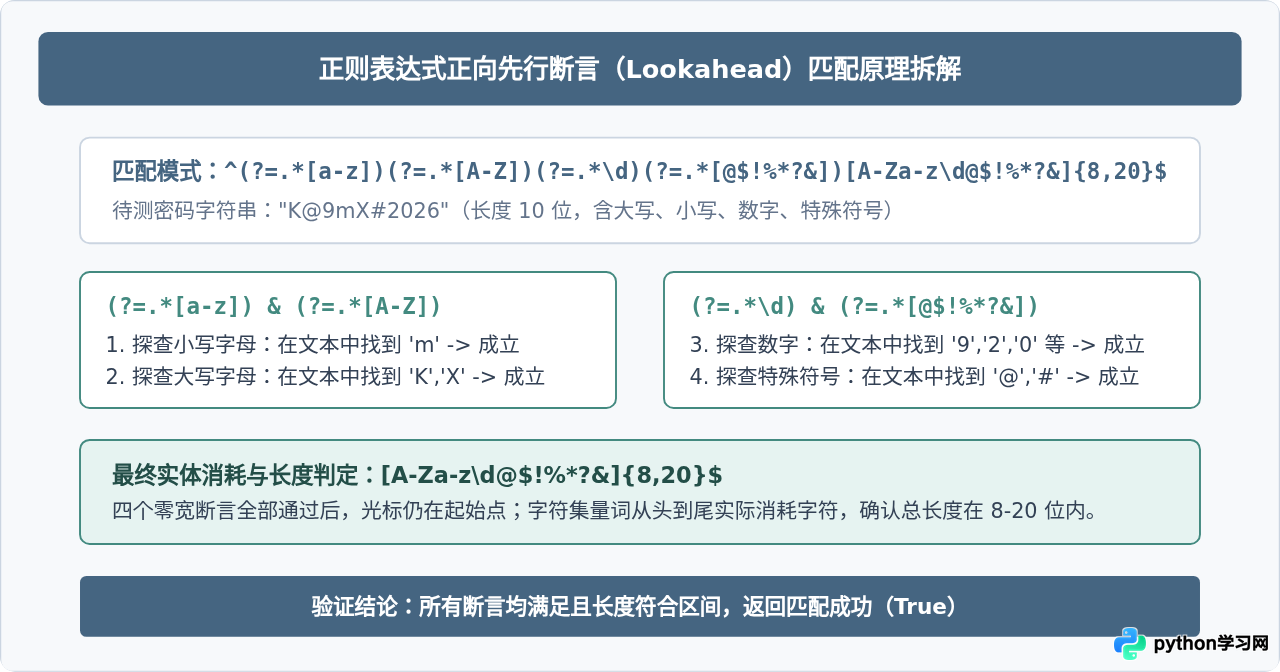
为了在单条表达式中实现“同时满足各项字符规则”,必须引入正向先行断言(Positive Lookahead),语法为 (?=...)。断言属于“零宽匹配”(Zero-Width Match),它只在当前位置向后探索字符串是否符合子规则,匹配成功后并不消耗任何字符,光标依然停留在起始位置。因此,我们可以连续放置多个先行断言,分别探查各类必须存在的字符集,最后再通过具体的字符集与量词完成长度校验与结尾匹配。
单正则校验的完整 Python 实现
在 Python 中,建议使用标准库 re 的 re.compile() 函数将正则表达式预先编译为模式对象,避免在循环调用或高并发接口中重复解析表达式,从而提高匹配效率。
import re

# 编译复合验证正则模式
# 规则:长度8-20位,必须同时包含大写字母、小写字母、数字和指定特殊符号
PASSWORD_PATTERN = re.compile(
    r"^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&])[A-Za-z\d@$!%*?&]{8,20}$"
)

def validate_password_regex(password: str) -> bool:
    """
    使用单条正则表达式验证密码强度
    :param password: 待验证的密码字符串
    :return: 符合规则返回 True,否则返回 False
    """
    if not isinstance(password, str):
        return False
    return bool(PASSWORD_PATTERN.match(password))

# 示例测试
if __name__ == "__main__":
    test_cases = [
        ("Abc12345", False),          # 缺少特殊符号
        ("abc12345@", False),         # 缺少大写字母
        ("ABC12345@", False),         # 缺少小写字母
        ("Abcdefg@", False),          # 缺少数字
        ("A1@b", False),              # 长度不足8位
        ("Abc12345@ExtraLongPassword", False), # 超过20位
        ("SafePass2026@", True),      # 完全符合规则
    ]

    for pwd, expected in test_cases:
        result = validate_password_regex(pwd)
        print(f"密码: {pwd:<26} 预期: {str(expected):<5} 实际: {str(result):<5} 结果: {'通过' if result == expected else '失败'}")
二、字符规则矩阵与分级强度设计
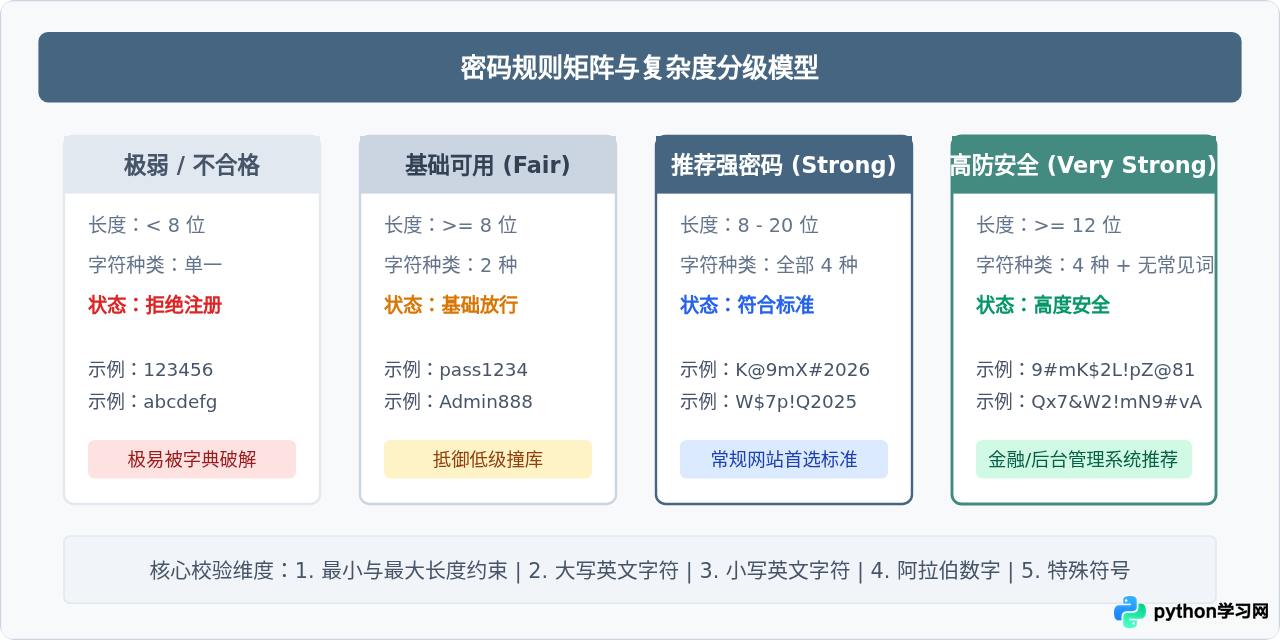
在企业级系统或复杂业务场景中,单一的“是/否”验证往往不够灵活。现代安全标准通常将密码规则划分为基础规则与可选增强规则,形成规则判定矩阵。通过评估密码命中各项规则的数量,可以将密码划分为不同的安全等级。
三、方案二:多规则拆解验证(推荐生产环境使用)
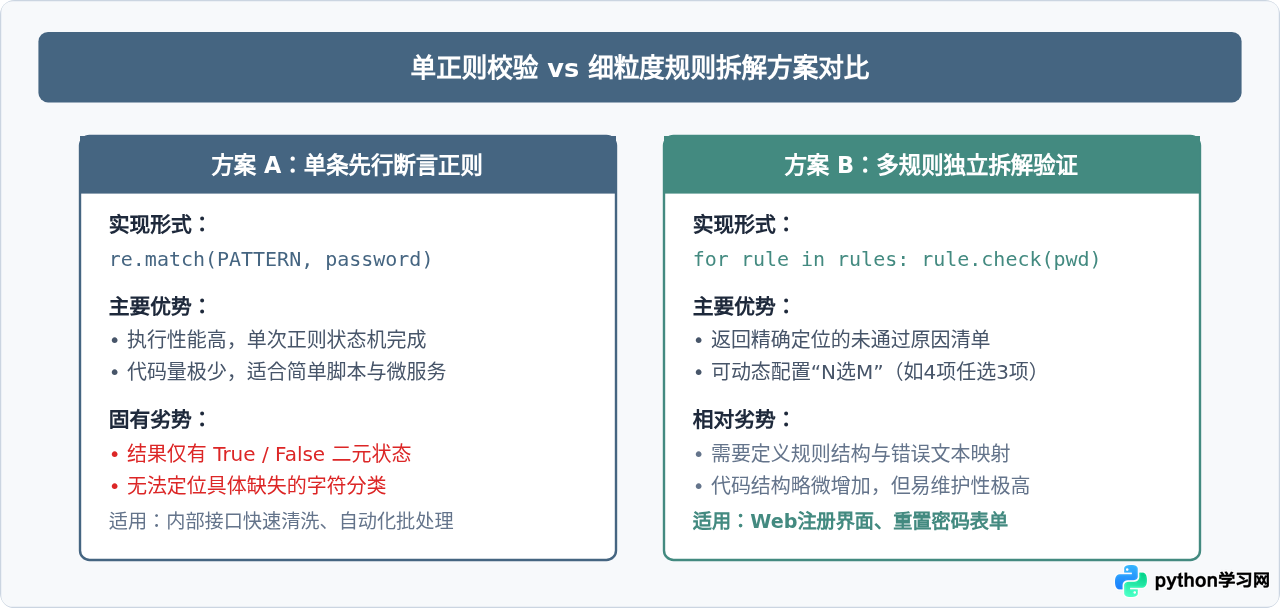
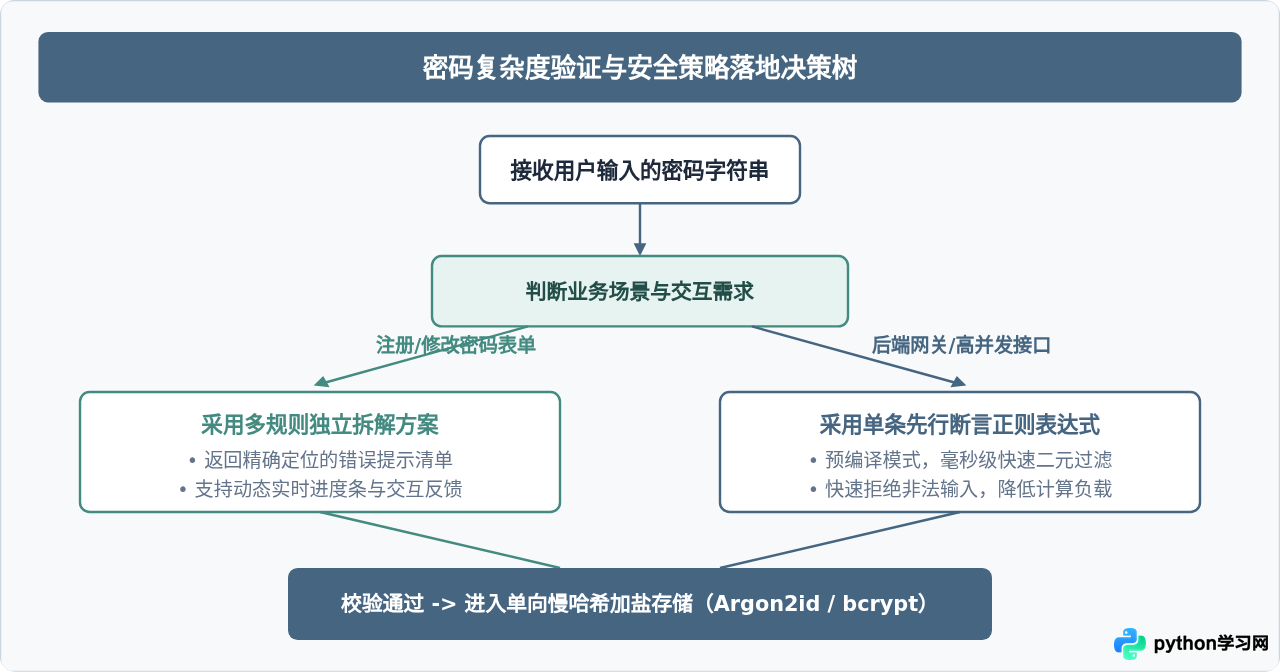
虽然前文介绍的单条复合正则表达式性能极佳且代码紧凑,但在真实用户交互场景中存在一个显著缺陷:无法明确提示用户具体哪里不合规。当用户输入的密码验证未通过时,界面只能泛泛提示“密码不符合规则”,用户往往不知道是“长度不足”、“缺少大写字母”还是“特殊符号不符合范围”,这极大降低了表单的易用性。
因此,在注重用户体验的生产环境中,更推荐将各项规则独立拆解。通过顺序检测各项独立规则,收集所有未满足的项目,最后汇总返回验证状态与明确的错误信息列表。
拆解验证的完整 Python 实现
下面给出面向实际工程落地的完整验证器实现。该模块定义了清晰的规则元组列表,既使用标准字符长度判定,也使用简明的正则分别探查各类字符,并返回结构化的校验报告:
import re
from typing import List, Tuple, Dict, Any

class PasswordValidator:
    def __init__(self, min_len: int = 8, max_len: int = 20):
        self.min_len = min_len
        self.max_len = max_len

        # 预编译各项子规则正则
        self.re_lower = re.compile(r"[a-z]")
        self.re_upper = re.compile(r"[A-Z]")
        self.re_digit = re.compile(r"\d")
        self.re_special = re.compile(r"[@$!%*?&]")

    def validate(self, password: str) -> Dict[str, Any]:
        """
        执行精细化多维度验证
        :param password: 待验证密码
        :return: 包含通过状态、错误列表及各项规则详情的字典
        """
        errors: List[str] = []

        if not isinstance(password, str):
            return {"is_valid": False, "errors": ["密码必须是字符串类型"]}

        # 1. 长度验证
        pwd_len = len(password)
        if pwd_len < self.min_len or pwd_len > self.max_len:
            errors.append(f"密码长度必须在 {self.min_len} 到 {self.max_len} 位之间(当前长度:{pwd_len})")

        # 2. 字符规则检测
        rule_checks = [
            (self.re_lower.search(password), "密码必须包含至少一个小写字母 (a-z)"),
            (self.re_upper.search(password), "密码必须包含至少一个大写字母 (A-Z)"),
            (self.re_digit.search(password), "密码必须包含至少一个数字 (0-9)"),
            (self.re_special.search(password), "密码必须包含至少一个特殊字符 (@$!%*?&)"),
        ]

        for match_obj, error_msg in rule_checks:
            if not match_obj:
                errors.append(error_msg)

        return {
            "is_valid": len(errors) == 0,
            "errors": errors,
            "passed_rules_count": 4 - (len(errors) - (1 if (pwd_len < self.min_len or pwd_len > self.max_len) else 0))
        }

# 测试执行
if __name__ == "__main__":
    validator = PasswordValidator(min_len=8, max_len=20)
    test_samples = ["123456", "password", "PassWord123", "Secure#2026"]

    for item in test_samples:
        res = validator.validate(item)
        print(f"\n输入密码: {item}")
        print(f"校验状态: {'合格' if res['is_valid'] else '不合格'}")
        if res["errors"]:
            print("未满足要求项:")
            for err in res["errors"]:
                print(f"  - {err}")
四、常见边界问题与注意事项
注意:正则表达式中特殊符号的转义是高频出错点。若在字符集 [...] 内使用了短横线 -,如果未放置在最前或最后位置,会被解析为字符区间(如 a-z)。若要允许短横线,建议写成 [-@$!%*?&] 或对其进行转义 [\-@$!%*?&]。
| 场景 / 边界情况 | 潜在风险 | 规范处理方案 |
|---|---|---|
| 超长密码输入(如数万字符) | 复杂正则在极端长文本下可能引发正则回溯耗时,导致服务阻塞(ReDoS)。 | 在执行正则表达式前,优先通过内置 len(password) > 128 进行短路拦截。 |
| 特殊符号集定义不明确 | 不同平台键盘可输入的符号不同,过窄的符号集会导致用户习惯密码无法注册。 | 明确列出允许符号或采用标准字符类 string.punctuation。 |
| 空格与控制字符 | 首尾空格易被用户复制混入,或隐藏控制字符导致后续认证时哈希不一致。 | 明确禁止空格或在校验前使用 strip() 并在说明中告知。 |
| 非 ASCII 字符(如中文或表情符号) | 未作限制时,某些正则默认匹配所有 Unicode 字符或直接报错。 | 根据系统需求显式限制编码范围,或声明支持 UTF-8 扩展。 |
五、密码验证策略与架构选型
在设计系统密码校验策略时,开发者需要结合当前的系统架构层级、面向用户类型以及性能要求进行综合决策。下图展示了从前端表单到后端存储的完整验证与处理决策路径:
六、总结
使用 Python 结合正则表达式验证密码长度与字符规则时,核心在于根据实际业务选择合适的表达形式:
- 若追求极致的执行效率与代码精简度(如批处理、内部通信或网关前置过滤),单条包含正向先行断言
(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&])的正则表达式是最直接的解法; - 若追求优秀的用户交互体验(如面向终端用户的注册与改密界面),将长度与各字符类拆分为独立子规则,能够输出精准的错误提示,避免用户在猜测规则中流失;
- 无论采用哪种验证方案,密码规则校验仅仅是身份安全的第一步。验证通过后的明文密码必须及时使用安全单向哈希算法(如 Argon2 或 bcrypt)进行加盐散列后再持久化存储,严禁明文入库。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















