


Python爬虫数据解析:BeautifulSoup与正则表达式对比

re 模块的正则表达式代表了两种根本不同的处理思路:前者先将 HTML 构建为完整的层级节点树再进行语义化查找,后者把文档视作无结构的纯字符流直接进行模式扫描。本文围绕两者的解析机制、实战用法、容错边界与性能差异展开具体对比,帮助读者在不同爬虫场景中做出准确选择。
一、底层解析机制与工作模式差异
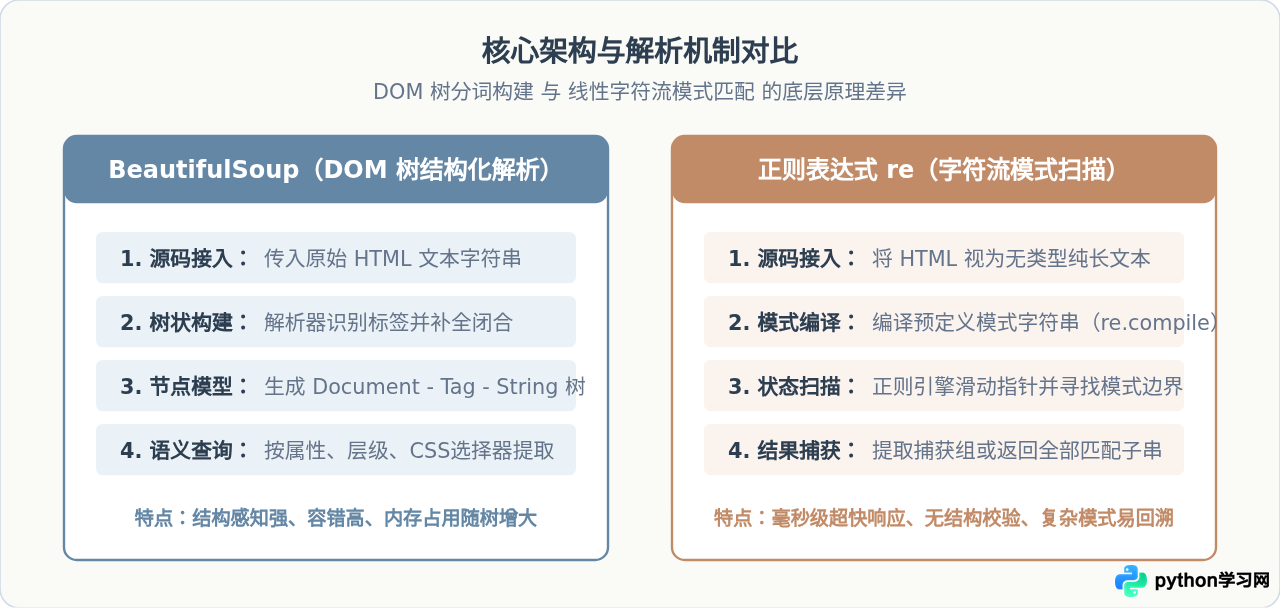
理解两者的选择基准,首先要从它们的内部工作原理切入。HTML 是一种标记语言,包含嵌套标签、属性、注释以及潜在的不规范格式。两种工具对同一段 HTML 文本的理解方式有着本质区别。
BeautifulSoup 本身是一个语法包装库,它依赖底层的解析器(例如 lxml 或 Python 内置的 html.parser)对输入的字节流或字符串进行词法分词。解析器在内存中搭建一个完整的文档对象模型(DOM)树,所有的标签被抽象为 Tag 对象,标签内的纯文字被封装为 NavigableString 对象。通过这个树状结构,开发者可以顺着父节点、子节点、兄弟节点上下穿梭,或使用 CSS 选择器定位具体元素。
正则表达式(re) 则是基于正则状态机的字符匹配引擎。它完全脱离 HTML 语法规则,仅把输入当成一段单向流动的纯字符串。正则引擎根据用户编写的元字符规则(如字符组、量词、边界),在字符序列上逐个滑动并尝试满足条件。它并不知道某个标签是否已经正确闭合,也不知晓当前处于第几层嵌套中。
二、常见提取任务的代码实战对比
为了直观展现两者的编码体验与适用性,我们通过一个常见的新闻列表解析任务来对比两者的写法。
假定我们抓取到的网页 HTML 片段如下:
html_content = """
<div class="news-container">
  <ul class="news-list">
    <li class="item" id="post-101">
      <a href="/article/101.html" target="_blank">Python 爬虫实战指南</a>
      <span class="date">2025-05-10</span>
    </li>
    <li class="item" id="post-102">
      <a href="/article/102.html">数据清洗与储存方案</a>
      <span class="date">2025-05-12</span>
    </li>
  </ul>
</div>
"""
1. 使用 BeautifulSoup 提取标题与链接
使用 BeautifulSoup 时,通常先初始化 BeautifulSoup 对象,接着利用 CSS 选择器 select() 或标签查找方法 find_all() 逐层过滤:
from bs4 import BeautifulSoup

soup = BeautifulSoup(html_content, 'html.parser')
results = []

# 直接使用 CSS 选择器精确定位目标节点
for item in soup.select('ul.news-list li.item'):
    a_tag = item.find('a')
    date_tag = item.find('span', class_='date')
    if a_tag and date_tag:
        title = a_tag.get_text(strip=True)
        link = a_tag.get('href', '')
        date = date_tag.get_text(strip=True)
        results.append({'title': title, 'link': link, 'date': date})

print(results)
# 示例输出:
# [{'title': 'Python 爬虫实战指南', 'link': '/article/101.html', 'date': '2025-05-10'},
#  {'title': '数据清洗与储存方案', 'link': '/article/102.html', 'date': '2025-05-12'}]
这种写法的优势在于可读性极佳。即使网页增加了 target="_blank" 或修改了属性顺序,选择器依然能够准确命中 href 属性与文本内容。
2. 使用正则表达式 re 提取标题与链接
若使用正则表达式完成相同目标,开发者需要考虑属性顺序、空白符变化以及换行符:
import re

pattern = re.compile(
    r'<li[^>]*class=["\']item["\'][^>]*>\s*'
    r'<a[^>]*href=["\']([^"\']+)["\'][^>]*>([^<]+)</a>\s*'
    r'<span[^>]*class=["\']date["\'][^>]*>([^<]+)</span>',
    re.S
)

matches = pattern.findall(html_content)
results = [{'link': m[0], 'title': m[1].strip(), 'date': m[2].strip()} for m in matches]

print(results)
# 示例输出结果与 BeautifulSoup 一致从代码可以看出,正则表达式需要手动处理任意前导属性([^>]*)、单双引号混用(["\'])以及标签间的空白字符(\s*)。如果前端工程师将 span.date 移动到了 a 标签的前面,原正则就会完全失效,必须重构模式。
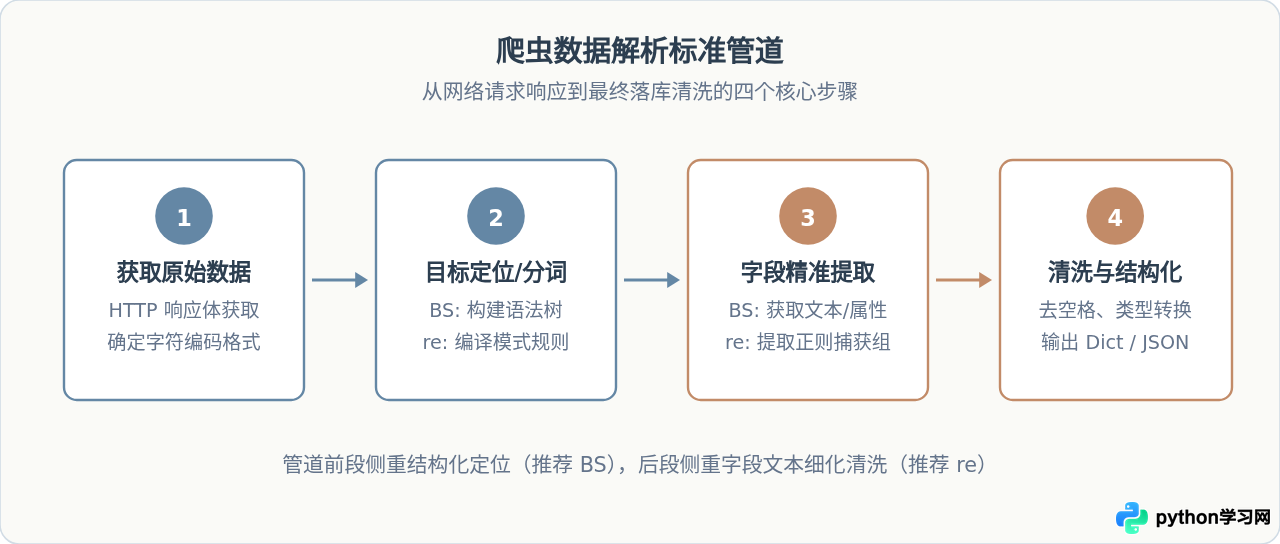
三、解析性能与容错能力深度评估
在工程化爬虫中,解析效率和面对劣质 HTML 时的稳定性直接决定了爬虫系统的吞吐量与健壮性。
1. 容错能力与残缺 HTML 修复
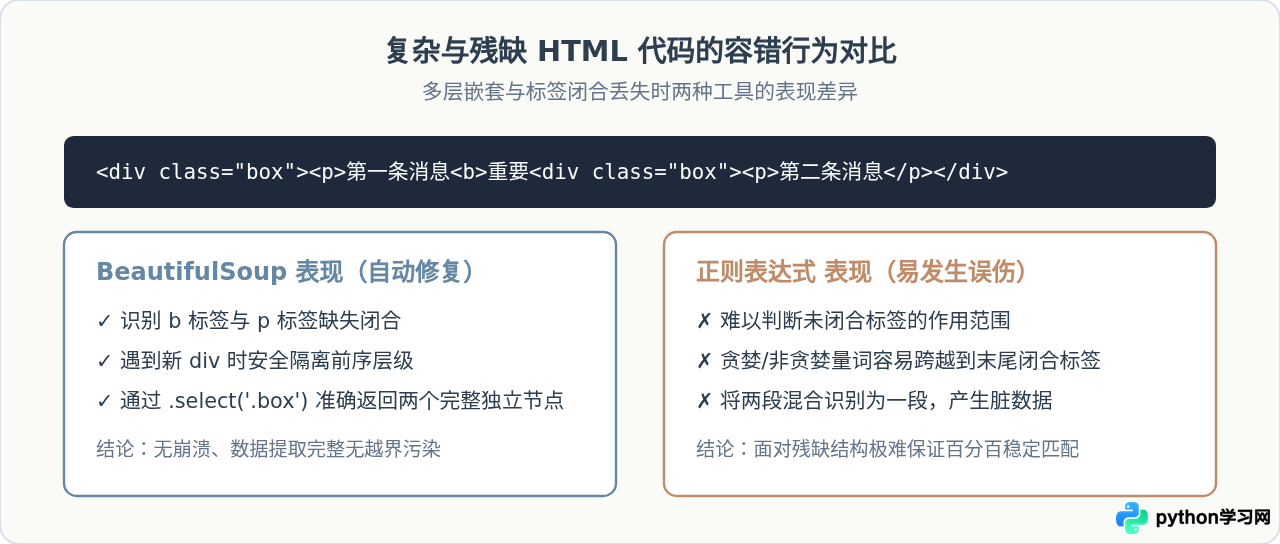
互联网中大量网页并非严格符合 W3C 标准,常见问题包括:未闭合的 <p> 或 <div> 标签、属性遗漏引号、不合法的注释嵌套等。
BeautifulSoup 的核心优势之一就是强容错。当配合 lxml 解析器时,底层 C 语言解析库会自动根据上下文补全缺失的闭合标签,将混乱的文档组织成一棵合乎逻辑的树。即便某处标签漏写,也不会影响后续同级节点的遍历。
正则表达式 对结构缺陷毫无抵御力。正则依靠字符锚点匹配,如果一个标签缺失了右括号 > 或闭合标签 </div>,带有贪婪特性的正则表达式(如 .*? 或 [\s\S]*)很容易一路越界吞噬后续内容,导致整段匹配丢失或返回严重错误的脏数据。
2. 执行性能与资源消耗
在性能测试中,正则表达式展现出了无可比拟的优势。因为 re 模块底层由纯 C 语言编写,编译后的正则直接执行高效的状态机扫描,无需分配复杂的对象树结构。
以下是两者在解析百万字节量级 HTML 时的典型资源消耗对比:
- 内存占用:BeautifulSoup 需要在内存中为每个节点创建 Python 对象。一个包含数千个标签的复杂页面,解析后往往占用数兆到数十兆字节内存;而正则表达式仅对原字符串建立切片引用,额外内存开销几乎为零。
- 解析耗时:对于同一份目标字段抽取,使用预编译正则
re.compile()的耗时通常是BeautifulSoup + lxml的 1/5 至 1/20,是BeautifulSoup + html.parser的 1/30 以上。
(.*)* 或重叠可选分组),在面对大文本未匹配场景时可能触发灾难性回溯(Catastrophic Backtracking),导致 CPU 占用率飙升至 100% 出现假死。
四、选型决策路径与混合最佳实践
在真实的工程项目中,二者绝非互斥关系。明智的工程师会根据目标数据的特征与载体形式选择合适的解析策略。
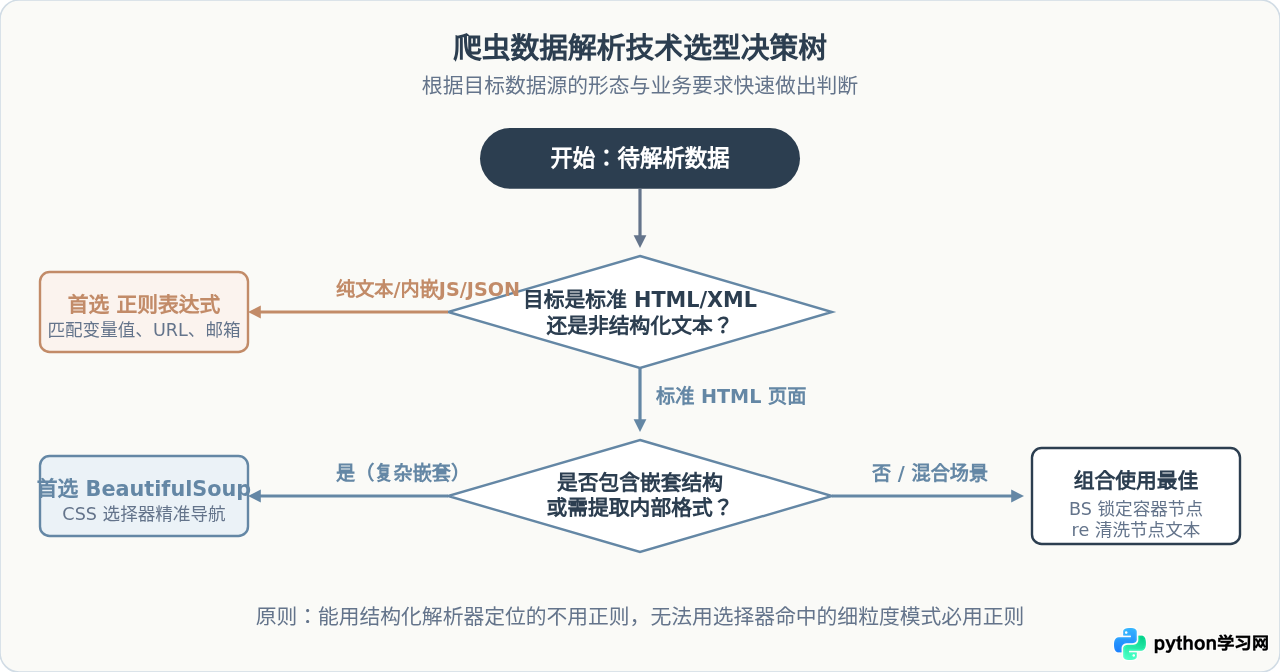
黄金组合:“BS 圈定范围 + 正则精准提取”
在成熟的爬虫项目中,最稳健的做法往往是两者的协同作战:
- 第一阶段(宏观定位):利用 BeautifulSoup 的 CSS 选择器定位到承载数据的具体容器或卡片(如
soup.select('div.user-profile')),排除掉页面其他区域(如页头、页脚、侧边栏广告)的文本干扰; - 第二阶段(微观清洗):在拿到该容器的纯文本后,利用预编译的正则表达式提取手机号、金额、发布日期等符合特定格式的字段。
import re
from bs4 import BeautifulSoup

# 示例:抓取动态混杂文本中的价格与阅读数
user_card = soup.find('div', class_='user-profile')
if user_card:
    text_content = user_card.get_text()

    # 使用正则表达式提取格式严谨的数字和编号
    phone_pattern = re.compile(r'1[3-9]\d{9}')
    price_pattern = re.compile(r'¥\s*([0-9]+(?:\.[0-9]{2})?)')

    phones = phone_pattern.findall(text_content)
    prices = price_pattern.findall(text_content)
这种模式既避开了正则表达式在全网页搜索时的越界风险与高昂回溯成本,又免去了 BeautifulSoup 在提取非结构化微小格式时的繁琐字符串切片工作。
五、多维度综合对比矩阵与总结
为了帮助读者在技术选型时建立清晰的全景图,我们将两个工具的核心维度进行系统汇总。
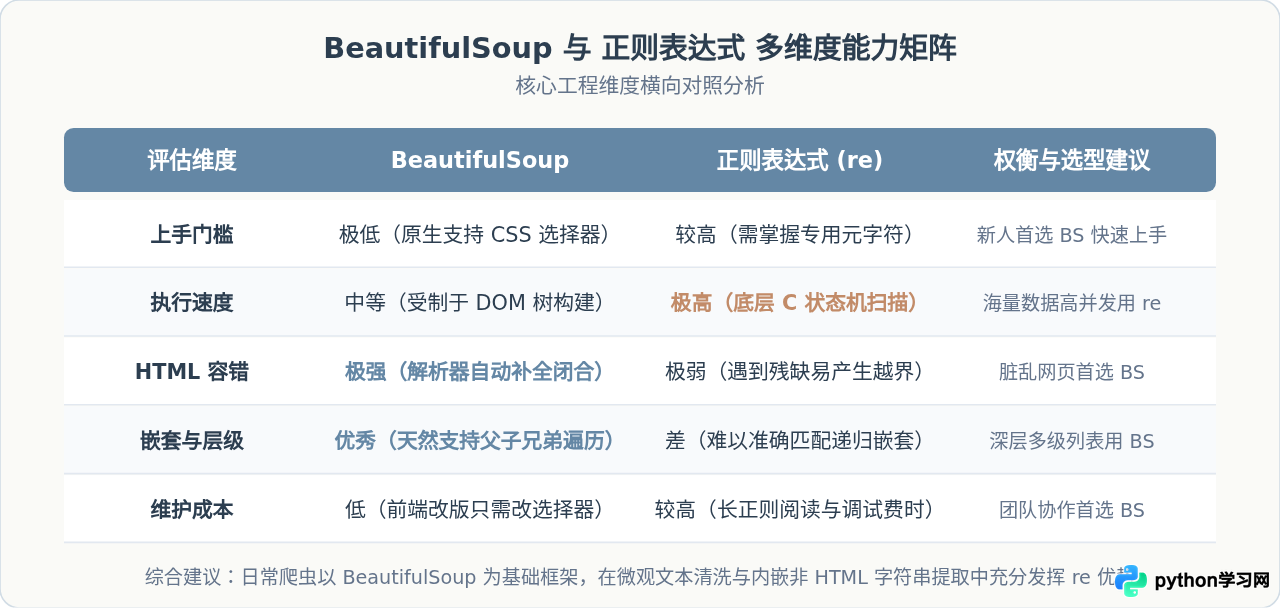
| 对比维度 | BeautifulSoup | 正则表达式 (re) |
|---|---|---|
| 数据模型 | 树状节点模型(DOM Tree) | 线性纯文本字符流(Flat String) |
| 定位语法 | CSS 选择器、标签方法(find/find_all) | 正则表达式模式、捕获分组 |
| 外部依赖 | 需安装 beautifulsoup4,建议配置 lxml |
Python 内置标准库,无额外依赖 |
| 内存占用 | 随 DOM 节点数增多而明显上升 | 近乎零额外对象开销 |
| 非 HTML 处理 | 无法直接处理(只能将其作为普通文本) | 通用工具,支持 JSON、JS 变量、URL 等 |
综上所述,在 Python 爬虫的数据解析工作中,并没有绝对的胜者。BeautifulSoup 胜在语义化、结构感知与强大的容错能力,是解析网页主体结构、表格以及嵌套列表的首选;而正则表达式胜在纯粹的速度、泛用性与对特定字符模式的微观捕获能力。掌握两者的本质差异,并在实际工程中采取“结构归 BS,文本归正则”的组合策略,能够显著提升爬虫的开发效率与运行鲁棒性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















