


Python 2和Python 3的主要区别是什么
全面解析 Python 2 和 Python 3 的核心区别,涵盖字符串与 Unicode 模型、print 语句变函数、整数除法、迭代器与列表、异常语法及标准库重构,并提供平滑迁移与升级建议。
Python 2 和 Python 3 的核心区别在于:Python 3 是为了彻底修复 Python 2 在早期设计中遗留的历史包袱与架构缺陷而推出的重大版本。为了实现更严谨的字符编码体系、更一致的语法标准和更高效的运行机制,Python 官方主动打破了向后兼容性。Python 2 已于 2020 年 1 月 1 日正式终结生命周期(EOL),目前全行业所有活跃项目均已全面采用 Python 3。本文将从文本与字节编码、语法与内置函数变动、迭代与集合机制优化、异常与库结构重构四个核心维度系统拆解两者的本质差异,并说明具体的迁移与排查方法。
一、文本与二进制编码模型:从模糊隐式到严格分离
在 Python 2 中,字符编码问题是开发者遇到最频繁也是最棘手的痛点。Python 2 中的 str 类型本质上是原始字节序列,默认使用 ASCII 编码解析,只有带有 u 前缀的字符串才是 unicode 类型。更危险的是,Python 2 允许 str 和 unicode 进行隐式自动拼接与比较,一旦字符串中包含非 ASCII 字符(例如中文),系统就会在静默解码时抛出难以追踪的 UnicodeDecodeError。
Python 3 从底层彻底重构了数据模型:所有的 str 字符串均为原生的 Unicode 文本,能够直接存储世界各国的文字;对于纯二进制数据,则提供了完全独立的 bytes 类型(以 b'' 声明)。两类数据具有严格的安全边界,严禁直接拼接或混用比较。两者之间的转换必须显式执行 .encode('utf-8')(从文本转为二进制字节)和 .decode('utf-8')(从二进制字节解码为文本),从语法根源上消除了字符乱码与隐式类型转换崩溃的问题。
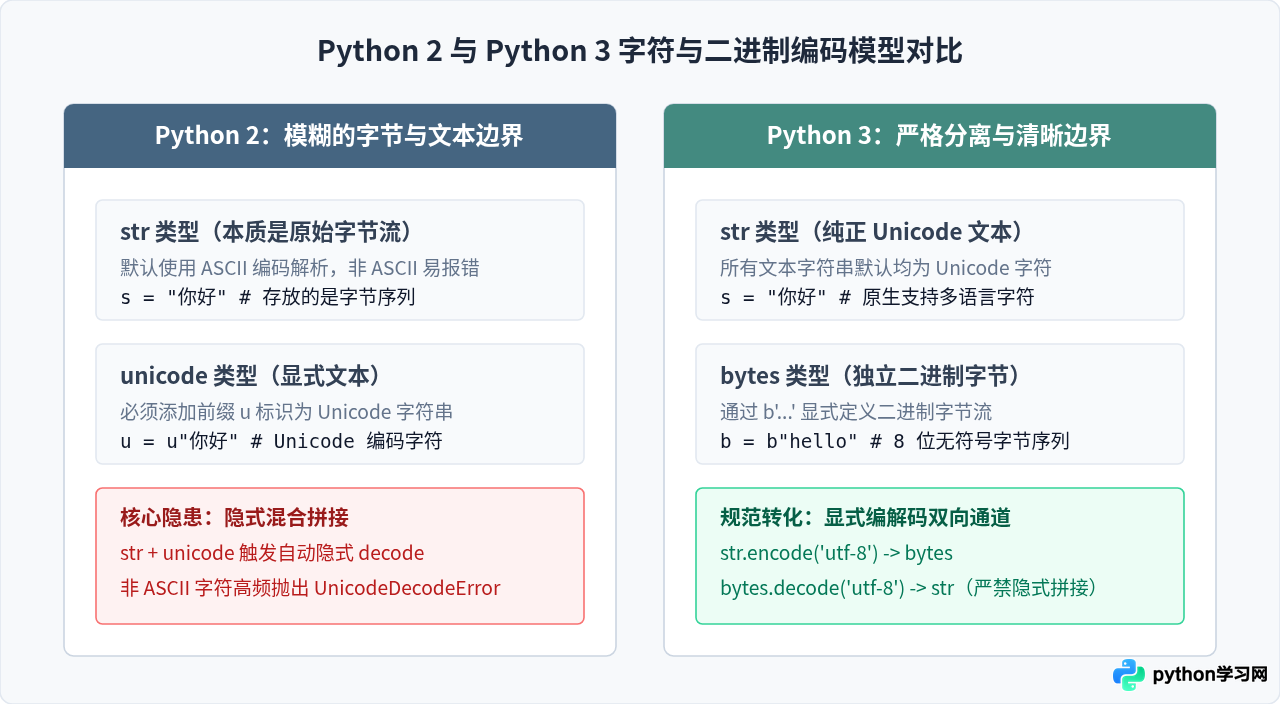
具体代码表现如下:
# Python 3 中的明确转换流程示例
text_data = "中文测试"
# 编码为 UTF-8 二进制字节
byte_data = text_data.encode("utf-8")
print(byte_data)  # 输出示例: b'\xe4\xb8\xad\xe6\x96\x87\xe6\xb5\x8b\xe8\xaf\x95'

# 从二进制字节还原为文本字符串
decoded_text = byte_data.decode("utf-8")
print(decoded_text)  # 输出: 中文测试

# 若尝试将两者直接相加:
# text_data + byte_data 会直接抛出 TypeError,不再出现隐式推断
二、常用语法与内置函数变动
在日常编写代码时,Python 2 与 Python 3 在多个基础内置功能上存在明显的语法演进:
1. Print 语句变更为内置函数
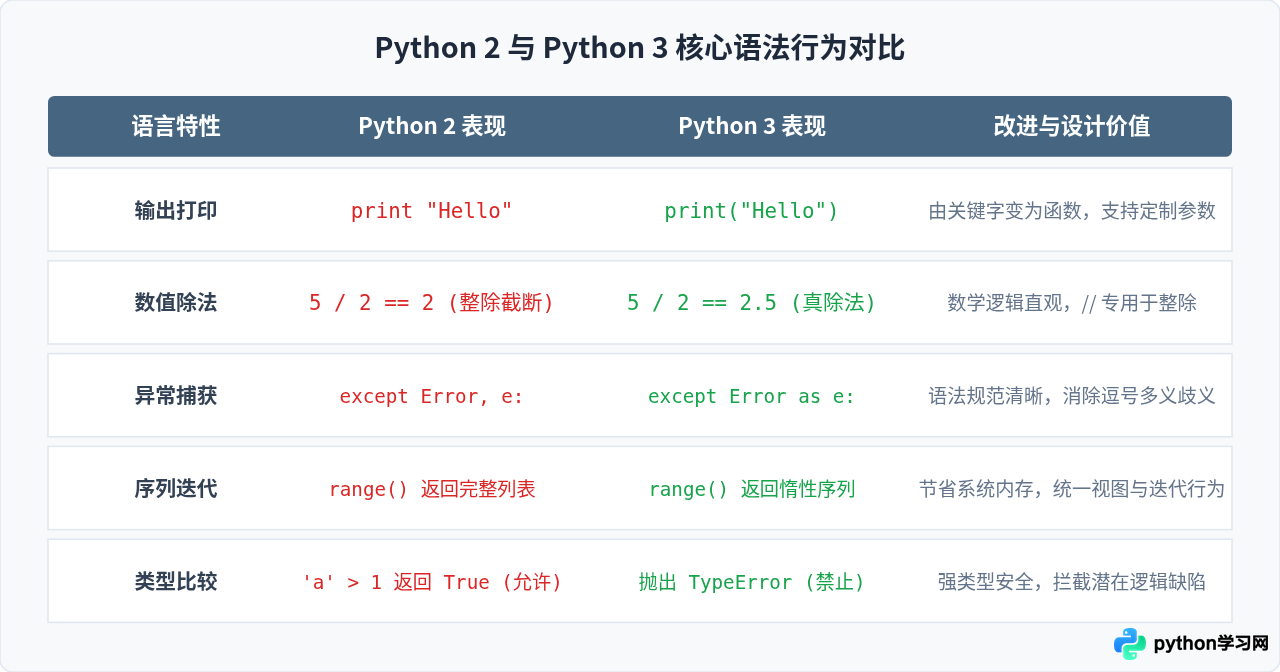
在 Python 2 中,print 属于关键字语句,调用时无需加括号:print "Hello"。这限制了参数传递的灵活性。Python 3 将其改为正规的内置函数 print("Hello"),支持通过关键字参数灵活指定输出行为:
end="...":定义结尾符号,替代 Python 2 末尾加逗号避免换行的做法。sep="...":定义多参数间的分隔符。file=...:将内容直接重定向输出至文件或标准错误流。
2. 数值除法机制的合理化
在 Python 2 中,除法运算符 / 对整数进行操作时执行的是整除(地板除),即 5 / 2 的计算结果为 2。这导致许多初学者在编写数学计算逻辑时因为类型截断而产生不易察觉的逻辑缺陷。如果需要浮点结果,必须显式书写 5.0 / 2。而在 Python 3 中:
- 单斜杠
/统一为真除法:5 / 2的计算结果为2.5。 - 双斜杠
//专门用作整除截断:5 // 2的计算结果为2。
3. input() 与 raw_input() 的整合
Python 2 同时存在 input() 和 raw_input()。其中 input() 会直接将终端输入作为 Python 表达式进行 eval() 执行,存在严重的安全风险;获取纯文本必须使用 raw_input()。Python 3 彻底移除了 raw_input(),并将 input() 改为统一返回纯字符串,彻底阻断了隐式代码执行漏洞。
4. 整型合并(int 与 long)
Python 2 区分标准的 32/64 位 int 和无限精度的长整型 long(大数带有 L 后缀)。Python 3 移除了 long,统一使用动态扩展精度的 int,无需开发者额外处理类型转换和大数后缀。
三、集合、迭代器与类型比较机制优化
1. 惰性迭代替代实体列表
在 Python 2 中,range(1000000) 会在内存中一次性分配包含 100 万个元素的列表,若要节省内存必须使用专用的 xrange()。Python 3 删除了 xrange(),将 range() 重构为一个轻量的不可变可迭代序列对象,只有在遍历时才动态生成值,大幅降低了大规模循环下的内存消耗。
同样,字典的方法在 Python 3 中也进行了类似革新:dict.keys()、dict.values() 和 dict.items() 在 Python 2 中返回独立的列表,而在 Python 3 中返回的是字典视图(view objects)。它们会动态跟随字典的变动而更新,且不再占用额外的内存空间;内建函数 map() 与 filter() 也改为了返回生成器迭代器。
2. 禁止非同类型间的无序比较
Python 2 允许对完全不同类型的对象进行大于或小于比较,例如 'abc' > 123 在 Python 2 中会返回 True(其底层仅仅依据类型名称字符串进行排序)。这种行为在很多情况下会隐藏代码中的排序逻辑 Bug。Python 3 引入了严格的不可比较约束:若两个对象之间未显式定义比较运算符,直接比较大小会立即触发 TypeError,保证了算法逻辑的确定性与稳健性。
四、异常处理与标准库模块重构
1. 异常语法的规范化与链式传递
在 Python 2 中,捕获异常使用逗号语法:
# Python 2 捕获异常
try:
    do_something()
except ValueError, e:
    print e
由于逗号同时也是元组的分隔符,容易让开发者将多异常捕获 except (ValueError, TypeError): 误写为 except ValueError, TypeError:,从而导致难以发现的逻辑错误。Python 3 统一强制使用 as 关键字:
# Python 3 统一规范语法
try:
    do_something()
except (ValueError, TypeError) as e:
    print(e)
此外,Python 3 还原生支持了异常链传递(Exception Chaining),允许通过 raise NewError from original_error 保留完整的调用堆栈回溯,极大简化了深层系统调用的排错链路。
2. 标准库命名与层级规整
Python 3 对标准库进行了系统清理与结构扁平化。例如 Python 2 中分散的 urllib、urllib2、urlparse 模块被统一整合进 urllib.request 和 urllib.parse;常用的首字母大写模块名称(如 ConfigParser、Queue、SocketServer)按照 PEP 8 命名规范统一修改为小写(configparser、queue、socketserver)。
五、遗留代码向 Python 3 升级迁移实操步骤
对于仍存留在旧系统中的 Python 2 代码库,完整的迁移过程通常划分为四个关键步骤:
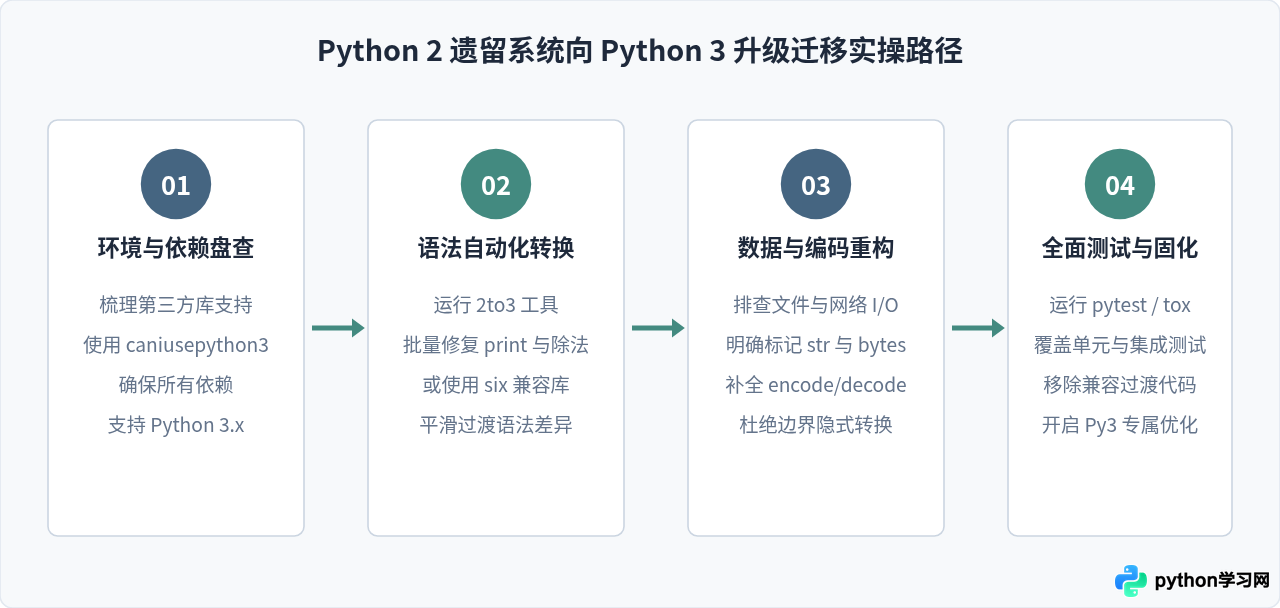
- 依赖评估:在终端运行
pip install caniusepython3,检查现有项目的requirements.txt,确认所有三方依赖包是否均已拥有稳定兼容 Python 3 的对应版本。 - 自动化转换代码:利用 Python 自带的
2to3命令行工具进行初步转换,例如执行:
该工具可自动将# 自动预览转换差异 2to3 my_project/ # 执行覆盖写入替换 2to3 -w my_project/print语句包裹函数括号,并将捕获异常中的逗号替换为as。 - 人工审查边界与 I/O:这是迁移最核心也是最容易出错的阶段。重点检查涉及网络通信(
socket、HTTP)、文件读写(open(..., 'rb')与open(..., 'r', encoding='utf-8'))和序列化(json、pickle)的代码,确保传入传出的数据类型在str与bytes之间严格匹配。 - 自动化回归测试:使用
pytest执行所有测试用例,重点关注文本处理、字典迭代和除法运算的预期输出,确认无误后完成生产环境的镜像替换与版本锁定。
encoding="utf-8" 参数(例如 open("data.txt", "r", encoding="utf-8")),以防止跨平台(Windows 默认 gbk,Linux 默认 utf-8)运行时产生偶发性读取报错。
六、全景对比与技术选型总结
综上所述,Python 3 不仅是一个修补错误的维护版,更是构建现代化高性能服务、异步并发网络应用和机器学习工程的基础。以下为两者的全局维度总结:
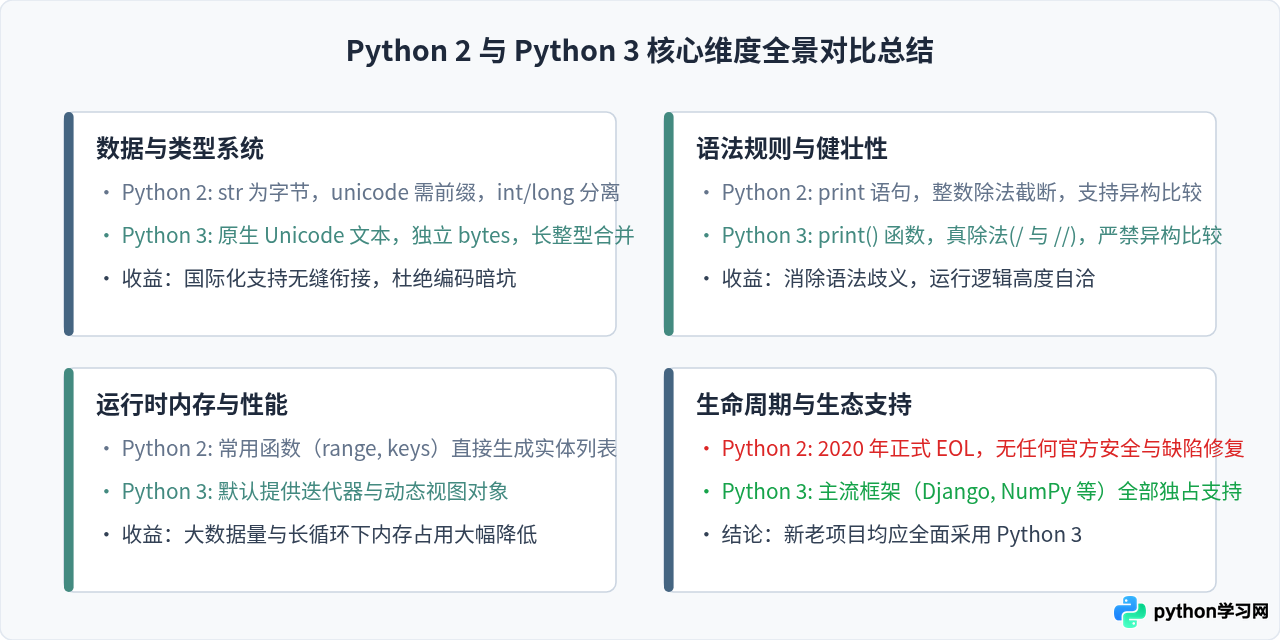
对于现代开发者而言,选择 Python 3 不再是一道选择题,而是必须遵守的工程标准。借助 Python 3 引入的原生类型注解(Type Hints)、结构化异步编程(async/await)以及持续迭代的解释器性能优化(如 Python 3.11+ 的 Faster CPython 专项优化),开发者不仅能够远离历史编码困扰,更能享受到更健全的现代化开发体验与庞大的开源生态保障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















