


现在还需要学Python 2吗?Python 2与3的主要区别

一、为什么不应该从头学习 Python 2?
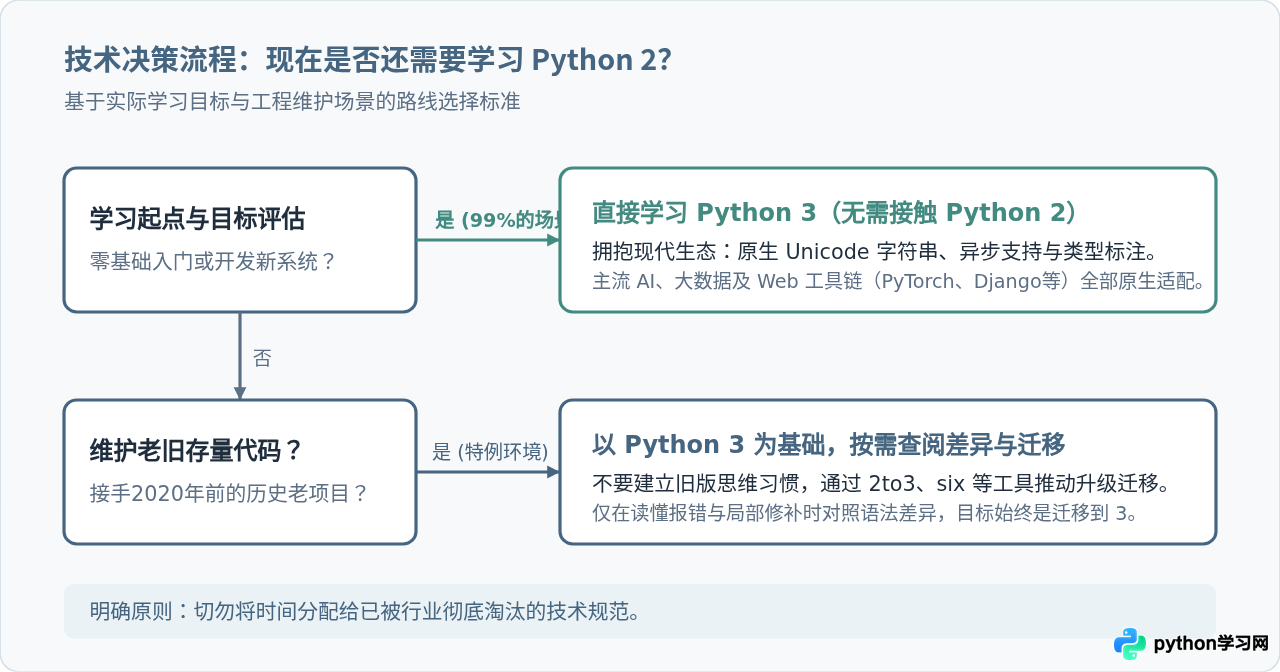
对于技术学习者而言,技术栈的选择不仅关乎个人精力的分配,更直接决定了工程规范的建立。Python 2 不再具备系统学习价值,原因主要体现在以下三个不可逆的事实层面:
- 官方支持彻底终结(End Of Life):Python 软件基金会(PSF)早在 2020 年 1 月 1 日就正式终止了对 Python 2.7 的支持。这意味着官方不会再针对 Python 2 发布任何漏洞修复、安全补丁或性能优化。使用 Python 2 运行生产业务已存在明确的安全隐患与合规风险。
- 第三方开源生态全面脱离:现代 Python 的核心优势在于丰富的第三方库。NumPy、Pandas、Scikit-learn、TensorFlow、PyTorch、Django、Requests 等主流库,已在数年前全部移除对 Python 2 的兼容代码。在 Python 2 环境中,你无法安装或使用这些库的任何现代版本,人工智能与数据科学的新算法更无从运行。
- 认知与编码习惯冲突:Python 2 存在诸多历史遗留设计缺陷(如默认 ASCII 编码、松散的类型比较等)。初学者若优先接触 Python 2,容易形成错误的编程心智模型,在转入 Python 3 时不得不耗费额外精力纠正坏习惯。
二、Python 2 与 Python 3 的核心语法与机制区别
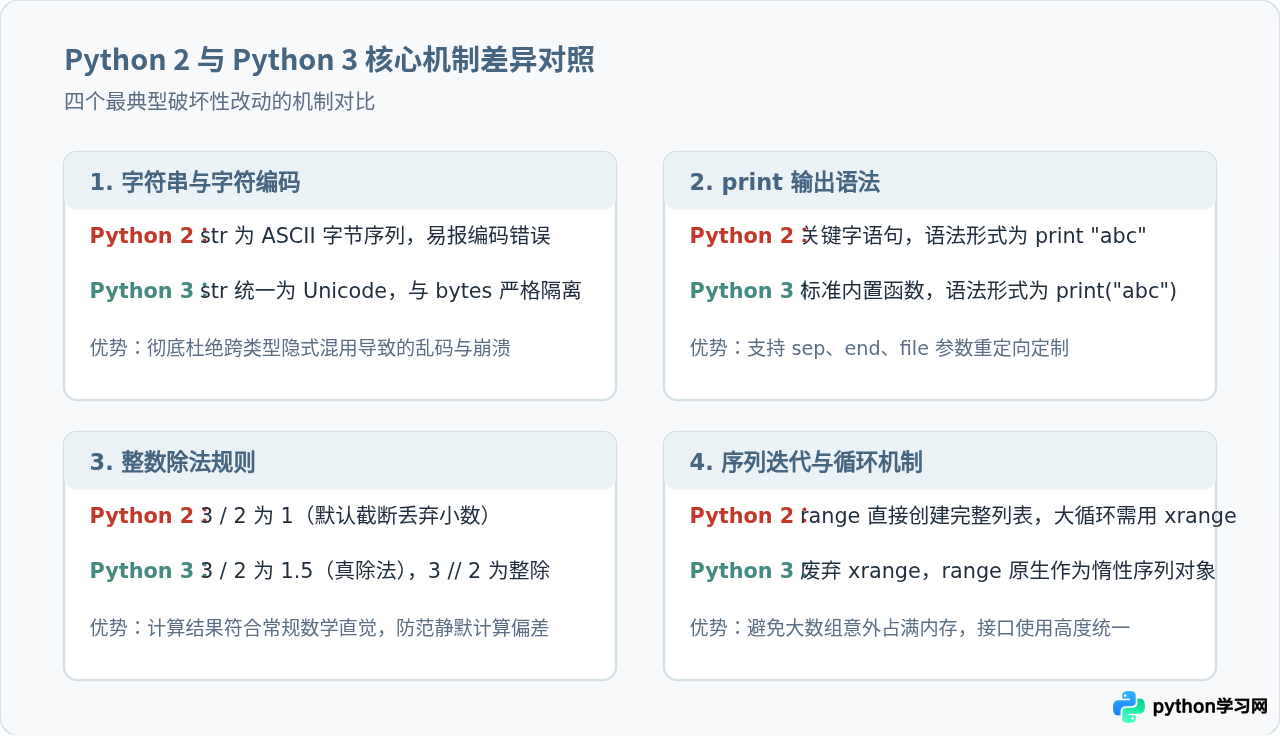
理解 Python 2 与 Python 3 的区别,有助于我们在阅读早期代码或执行遗留项目重构时迅速定位关键问题。二者的区别并非简单的关键字微调,而是涉及底层数据模型、字符串编码及执行机制的重大演进。
1. 字符串、编码与字节序列
这是两者之间最显著、也是在旧项目中引发最多运行期故障的破坏性改动。在 Python 2 中,默认字符串类型 str 实际上是原始字节序列,采用 ASCII 编码,若要表示 Unicode 文本必须显式添加 u 前缀:
# Python 2 示例
s = "你好"          # 类型为 str,底层为原始字节串(ASCII 默认)
u = u"你好"         # 类型为 unicode
# 当把 str 和 unicode 进行拼接时,解释器会隐式尝试用 ASCII 解码,极易触发:
# UnicodeDecodeError: 'ascii' codec can't decode byte ...
而在 Python 3 中,模型得到了彻底重构:所有文本字符串 str 默认均为 Unicode 编码,原始二进制字节则被严格隔离为独立的 bytes 类型:
# Python 3 示例
text = "你好"       # 类型为 str,默认即为 Unicode
raw_data = b"\xe4\xbd\xa0\xe5\xa5\xbd"  # 类型为 bytes

# 严禁跨类型隐式混用,必须显式编解码:
encoded_bytes = text.encode("utf-8")
decoded_str = raw_data.decode("utf-8")
这一重构彻底消除了隐式转换带来的不可控崩溃,使文本处理的逻辑变得清晰严谨。
2. print 语句与 print() 函数
在 Python 2 中,print 是一个内置语法关键字(语句),打印内容不需要括号;在 Python 3 中,print() 成为一个功能完整的内置函数。
# Python 2
print "响应结果:", status_code

# Python 3
print("响应结果:", status_code, sep=" ", end="\n")
函数化改造不仅统一了语法规范,还赋予了开发者灵活定制参数的能力,例如通过 sep 指定分隔符、通过 end 修改结尾换行符,以及通过 file 参数直接将内容重定向到文件或日志对象中。
3. 整数除法规则
Python 2 中的除法符号 / 对两个整数操作时默认执行“地板除”(舍去小数部分),这常常给未经严格类型转换的数学计算埋下隐患:
# Python 2
result = 5 / 2      # 结果为 2(整数截断)
float_res = 5 / 2.0 # 结果为 2.5(需手动将任一操作数转为浮点数)

# Python 3
result = 5 / 2      # 结果为 2.5(真除法,默认保留小数)
floor_res = 5 // 2  # 结果为 2(显式整除必须使用双斜杠 //)
4. range 与 xrange 的合并
在处理循环时,Python 2 提供了 range() 和 xrange() 两个函数。range() 会在内存中一次性分配出完整的列表,当循环规模较大时会造成巨大的内存开销,因此开发者往往需要谨慎改用 xrange() 生成器。而在 Python 3 中,xrange 被直接废弃,range() 本身被改造为按需计算的惰性序列对象,既节省内存,又免去了开发者的选择负担。
三、其他常见语法与模块差异
除上述四大核心差异外,日常接触代码时还会经常遇到以下几项改动:
- 异常捕获语法:Python 2 允许使用逗号分隔异常类与实例对象,如
except ValueError, err:。在 Python 3 中必须使用as关键字显式绑定,即except ValueError as err:,消除了与捕获多个异常元组时的语法歧义。 - 字典方法返回值:Python 2 中字典的
keys()、values()、items()方法直接返回全新列表;Python 3 中则返回动态视图对象(View Objects),不进行数据冗余拷贝,支持高效集合运算。 - 不可比类型的大小比较:在 Python 2 中,不同类型之间允许直接比较大小(例如数字与字符串
'1' > 0会判定为True,因为按照内部类型名称字符串排序);Python 3 则直接抛出TypeError: '>' not supported between instances of 'str' and 'int',严格避免潜在的逻辑隐患。 - 标准库路径整合:Python 3 整理了混乱的历史模块组织方式。例如 Python 2 中分散的
urllib与urllib2在 Python 3 中合并为统一的urllib.request和urllib.parse;模块名如ConfigParser、Queue分别规范化为小写的configparser与queue。
四、维护遗留系统时的正确应对策略
如果所在企业确实存在数年前编写且依赖特定老环境的 Python 2 存量服务,开发者应当如何应对?答案绝不是退回使用 Python 2 重新学习,而是采用标准的工程化手段对项目进行梳理与迁移。
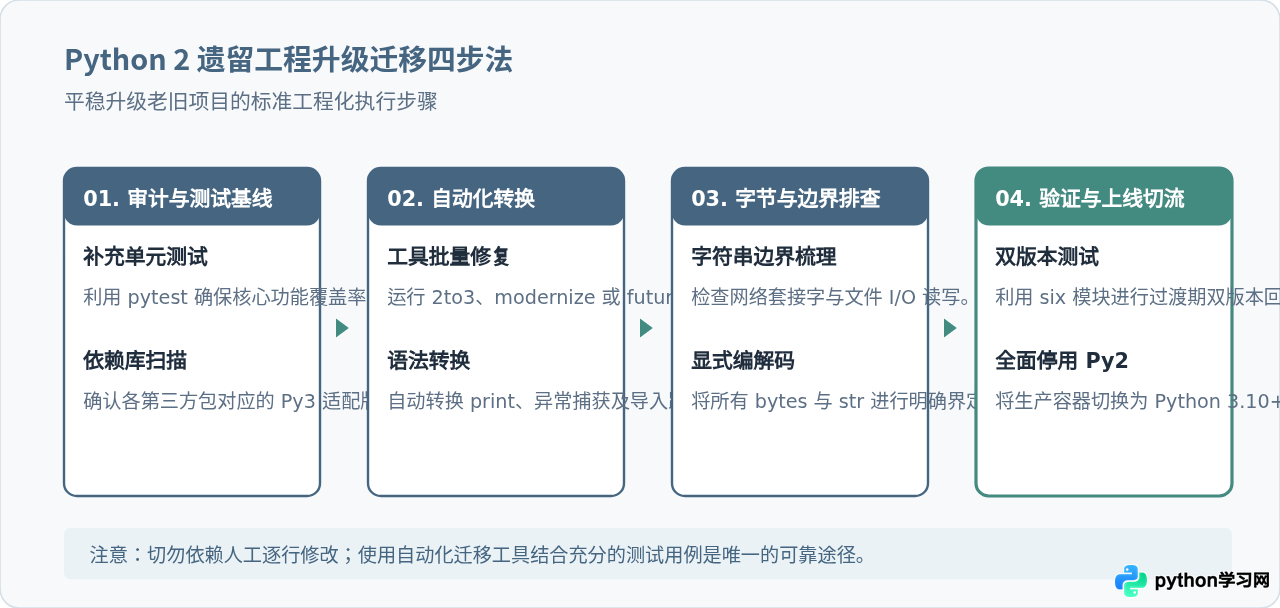
迁移执行过程中的关键实践要点包括:
- 使用官方
2to3工具自动生成补丁:Python 安装包自带2to3命令行脚本,可自动检测并修复大多数语法级变动(如 print、异常结构、urllib 路径)。例如执行2to3 -w your_script.py可以直接在原文件上完成常规语法的转换。 - 过渡期使用兼容适配库:如果项目规模庞大、需要短时间内在 Python 2 和 Python 3 两个环境中同时运行,可以引入
six或future库,在不破坏旧环境的前提下引入现代写法。 - 锁定外部接口的字节边界:在处理 HTTP 请求、文件读写、数据库交互等 I/O 边界时,仔细核对是否有未声明字符集的字符串隐式转换。所有外部输入必须第一时间
decode成字符串,所有对外发送的数据必须encode为字节流。
五、总结与现代学习建议
软件工程的发展具有明确的单向性。Python 3 自发布至今已经历了十余年的打磨,带来了类型提示(Type Hints)、结构化模式匹配(match-case)、现代化原生异步编程(asyncio)以及显著的性能提升。面对当前的技术生态,开发者的注意力应当牢牢锚定在现代 Python 规范上。
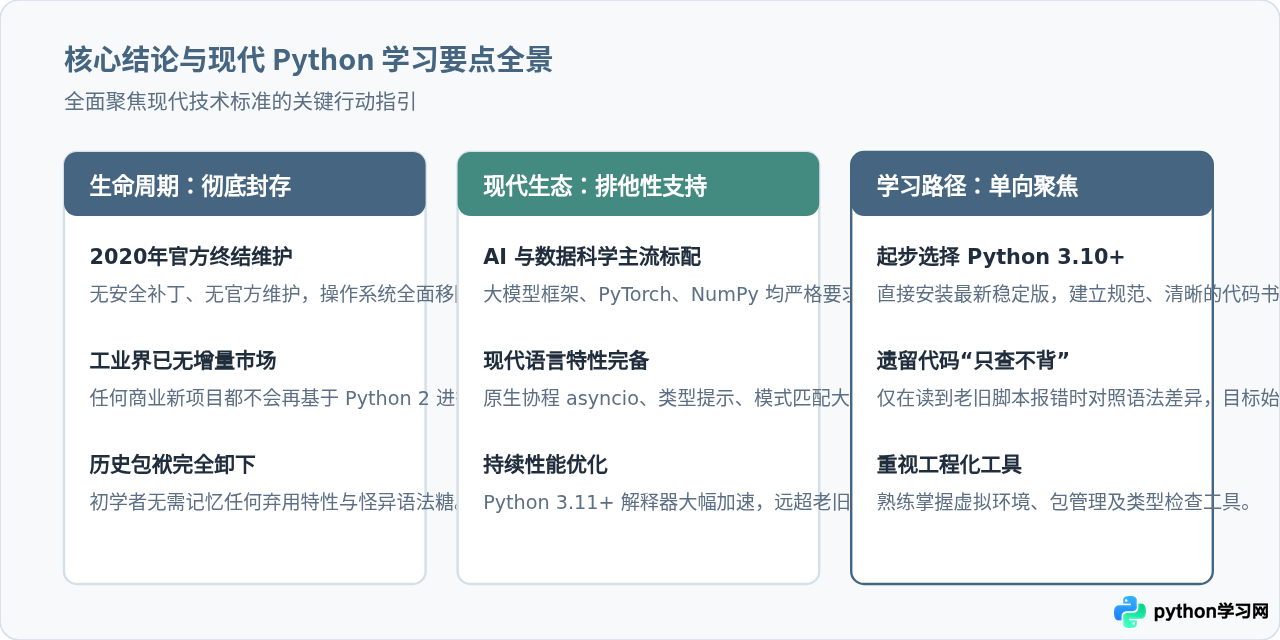
- 直接前往官方网站下载 Python 3.10 或更高版本;
- 在学习过程中忽略任何讲解
xrange、print 无括号、u"..."的陈旧教程; - 如果在实际工作中遇到了由 Python 2 编写的历史模块,优先使用
2to3进行迁移转换,不要把精力消耗在维系已淘汰的技术上。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















