


除了存储,优秀的AI提示词工具库还应具备评估与监控功能
本文介绍高级AI提示词管理工具的核心价值,从提示词版本、测试实验、评分复核到运行监控四个维度,解析如何建立可追踪、可评估的提示词工作流,避免仅将工具作为文本存储库。
提示词工具库不能只让人找到一句话,还应帮助团队看清:哪一版更适合当前任务,改动后有没有退步,上线使用时哪里出现异常。认识这类工具,可以沿着提示词、测试集、实验结果和运行记录四个功能区域阅读,而不必先记住所有按钮。
概述
存储区回答“用了哪一版”,评估区回答“在什么条件下表现怎样”,监控区回答“真实运行时发生了什么”。这三个问题需要互相关联,单独收藏提示词无法完成后两项。
下文以功能区域建立导览,不假定所有工具都有相同的页面布局。Langfuse 等平台已将提示词管理、数据集、实验、评分和运行追踪组织到同一工作流中;具体菜单名称、权限和部署方式仍以所用版本为准。
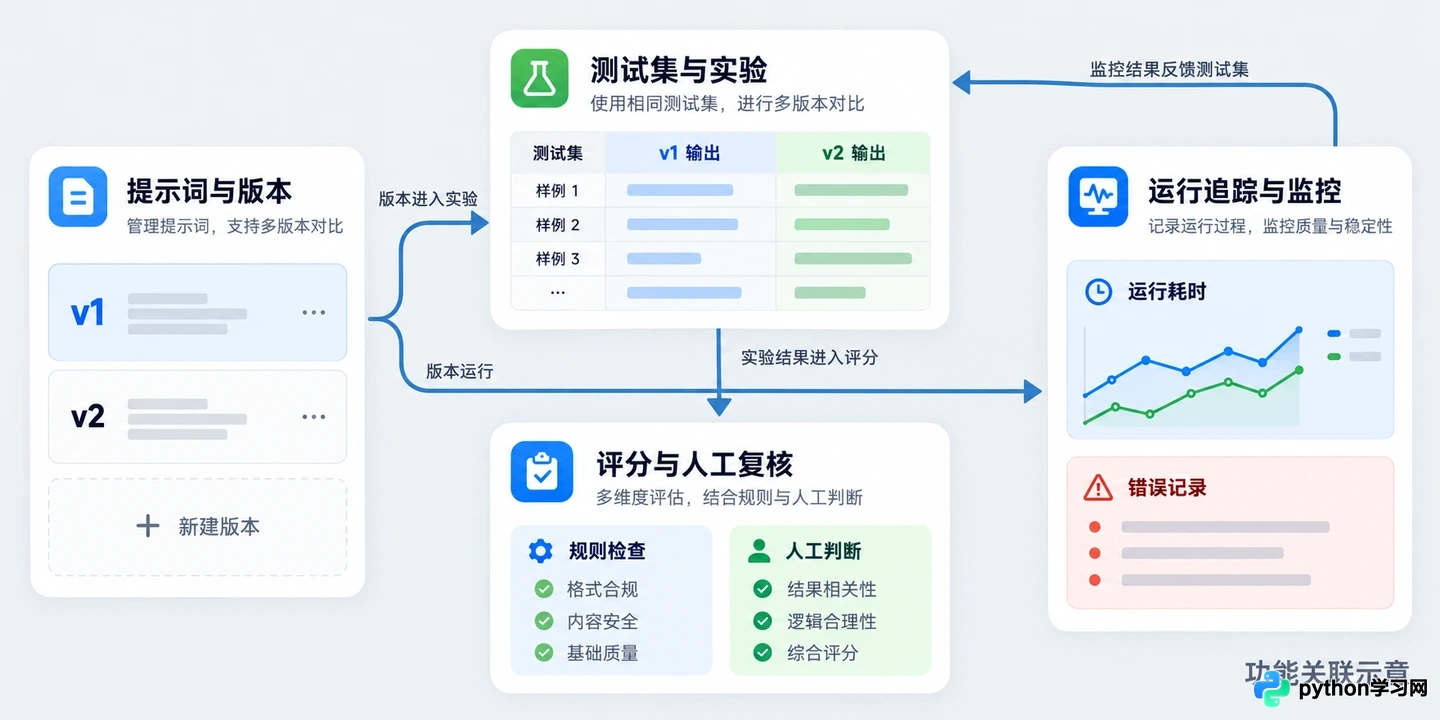
提示词管理、评估实验与运行监控的功能关联示意
关于提示词与版本区域
这里主要保存正文、变量和版本信息。除了能搜索、分类,还应能识别一次修改属于哪一版,并区分候选版本与实际使用的版本。否则,测试报告里的“新版提示词”很容易在下一次编辑后失去对应对象。
阅读这一部分时,重点不是模板数量,而是提示词能否关联到实际调用。例如在支持关联追踪的平台中,打开一次生成记录,可以追溯当时使用的提示词;再进入该提示词的指标区域,查看不同版本的表现。关联需要正确接入应用,不会因为保存了文字就自动完成。
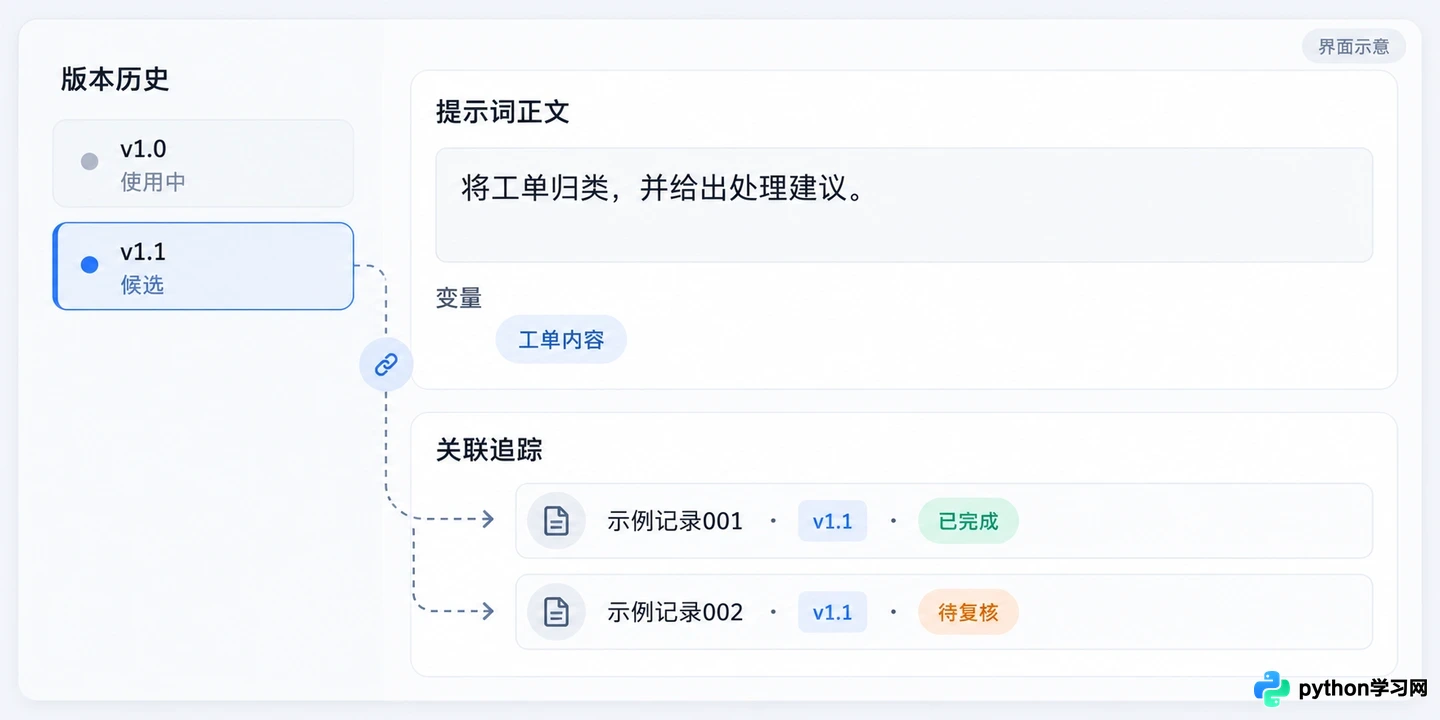
提示词版本历史及与生成记录的关联视图
关于测试集与实验区域
测试集保存输入样例及必要的预期信息,实验用于在这些样例上比较不同提示词或模型。它与聊天窗口里随手试一句的区别,在于比较条件可记录、结果可重复检查。
例如,要比较两版“工单分类”提示词,可以准备包含普通咨询、退款申请和模糊诉求的样例,并约定输出必须包含“类别”和“处理建议”。这是设计测试的示例,不代表任何平台已经替你建立了数据。比较时保持测试集版本、评分规则及其他条件一致,避免把模型变化误认为提示词改进。
好的实验区域不仅展示平均分,还应让人下钻到具体样例:哪条输入失败、输出缺了什么、旧版是否也存在同样问题。若工具支持结果并排比较,应优先查看差异样例,而不是只按总分选择。
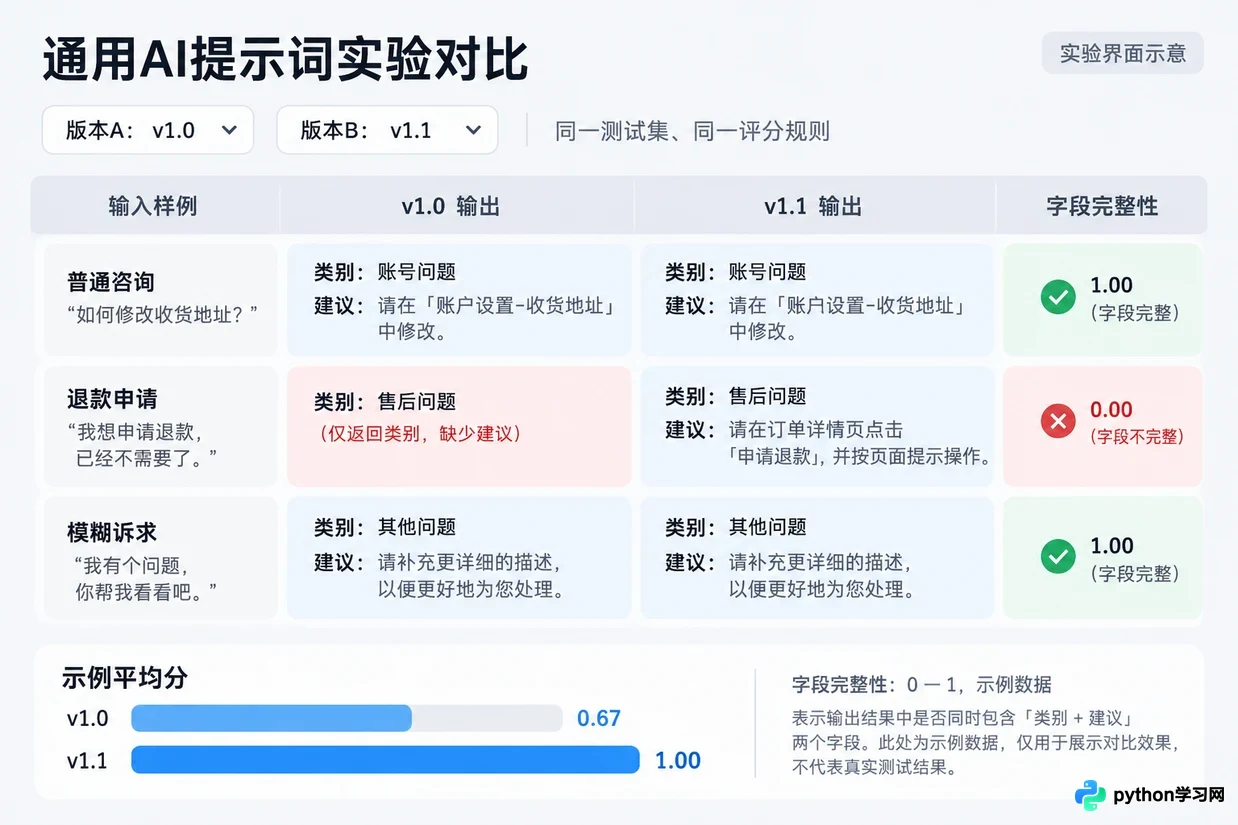
不同提示词版本在测试集上的表现对比
关于评分与人工复核区域
评分不必全部交给另一个模型。字段是否齐全、输出能否解析,可以采用明确规则检查;表达是否清楚、答案是否真正帮助用户,则需要合适的评估标准与人工复核。
阅读评分页时,应同时看到指标名称、数值含义及其对应记录。“0.8分”若没有说明范围、评分者和判断条件,就很难用于决策。模型评分也可能有偏差,不能把它等同于事实核验,更不能仅凭自动高分跳过重要业务内容的人工检查。
人工标注区域的价值,是集中处理有争议的结果,并把判断依据留下来。团队应先统一规则,再比较不同人的评分;否则图表看似精确,实际反映的可能只是标准不一致。
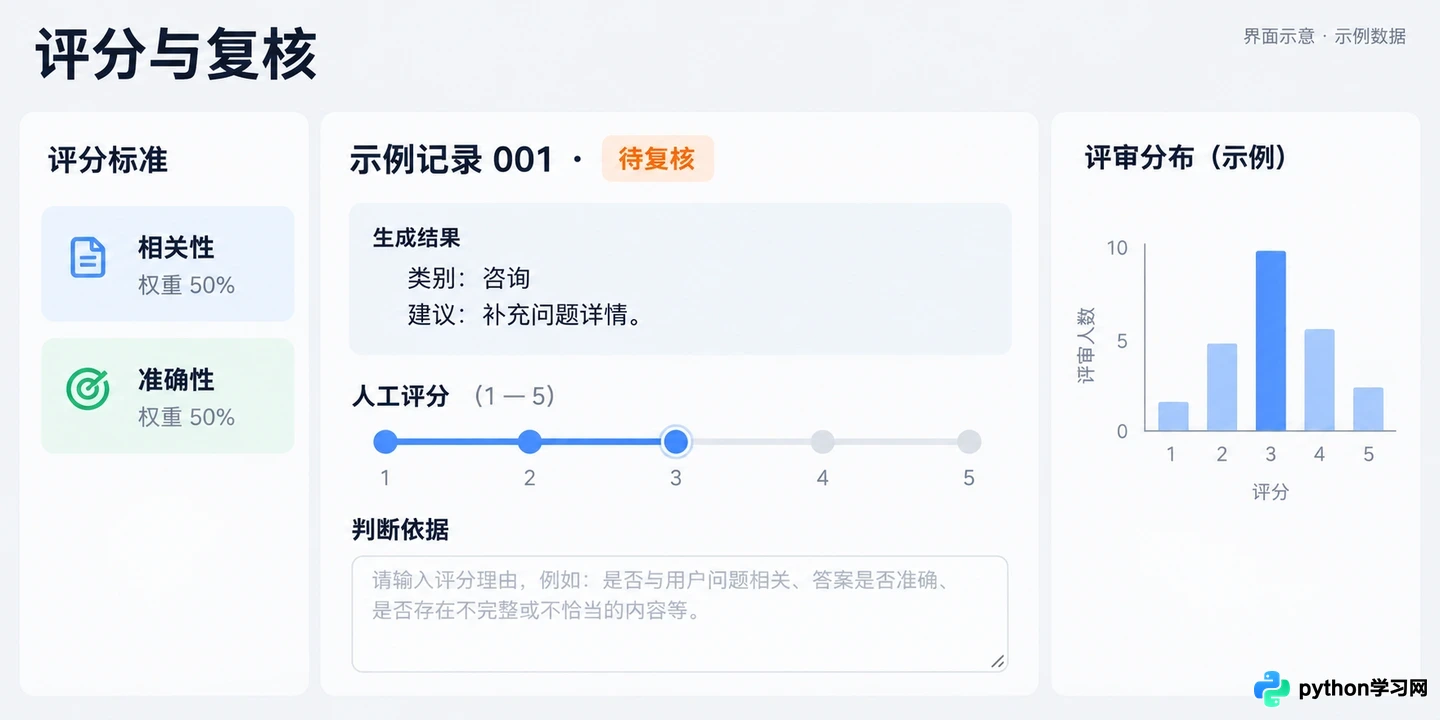
自动化评分指标与人工标注界面
关于运行追踪与监控区域
实验看的是准备好的样例,运行追踪看的是应用实际处理的一次请求。监控区域则将这些记录汇总,帮助观察耗时、消耗、错误以及质量指标随时间的变化。
看到异常后,应能回到对应记录,核对输入、输出、提示词版本及相关元数据,而不是只得到一条没有上下文的告警。是否支持告警、哪些数据可以查看、消耗如何计算,要单独确认,不能默认所有产品都提供。
运行数据也需要最小化采集。接入之前应明确哪些字段脱敏、谁能访问、保存多久,不要为了方便排错把密码、密钥或完整客户资料写入追踪。发现新的失败类型后,将经过处理的代表性样例补入测试集,让下一次版本比较能够覆盖它。这样,收藏、评估与监控才真正接成一条可回查的工作链。
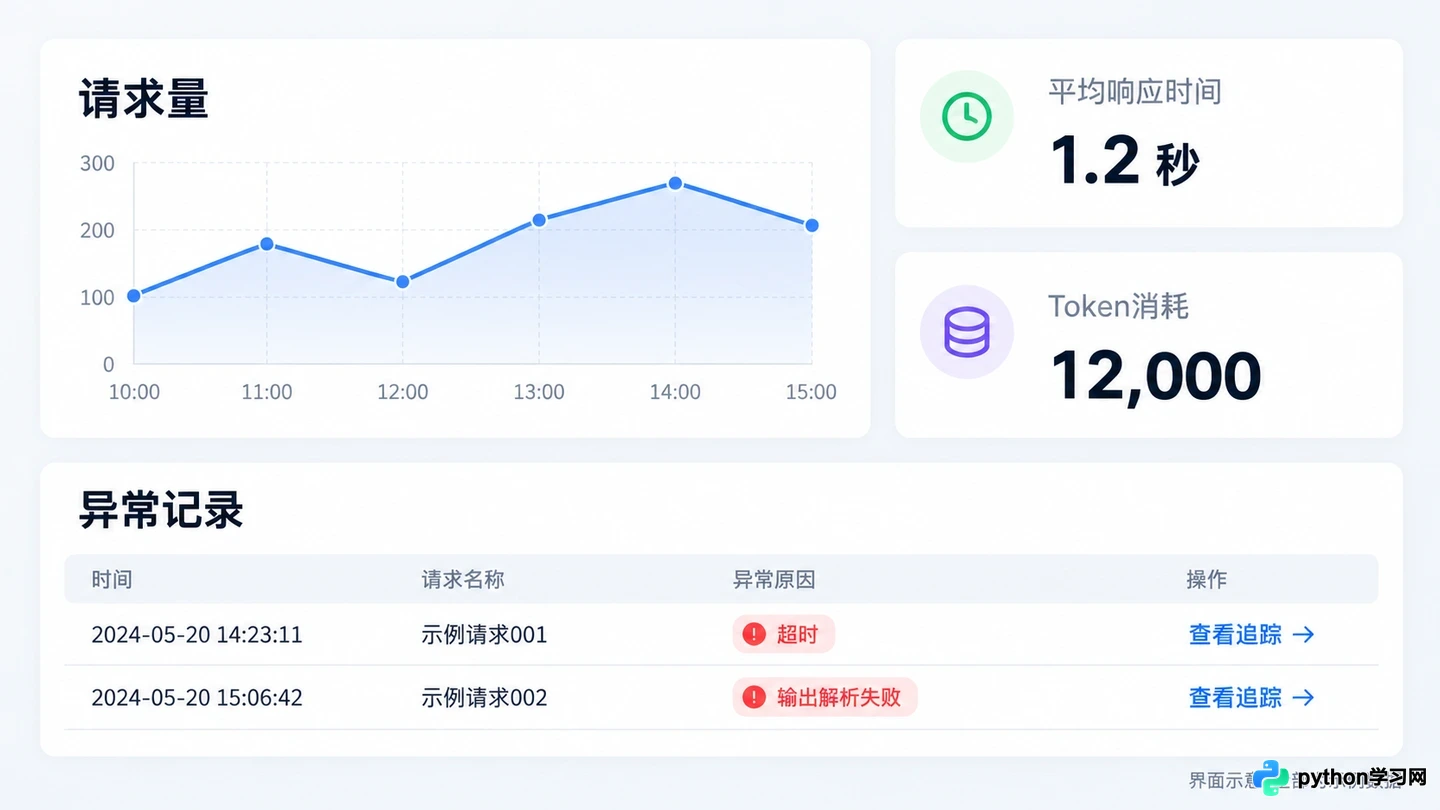
生产环境下的提示词运行状态监控
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















