


Python dataclasses能否替代手动编写的构造方法
深入分析 Python dataclasses 是否能够替代手动编写的 __init__ 构造方法,从底层生成机制、后置初始化、适用边界到选型决策树,提供清晰实用的工程指导。
核心答案是:在以数据载体、领域模型及参数绑定为主的常规面向对象场景中,Python 3.7 引入的 @dataclass 完全可以替代手动编写的 __init__ 构造方法;但在涉及动态变长参数传递、复杂前置参数解耦、多态构造重载或复杂单例工厂模式时,手动编写构造方法依然具有不可替代的灵活性。 理解两者的分界线,关键在于认清 dataclasses 自动代码生成的底层机制与其受约束的设计目标。
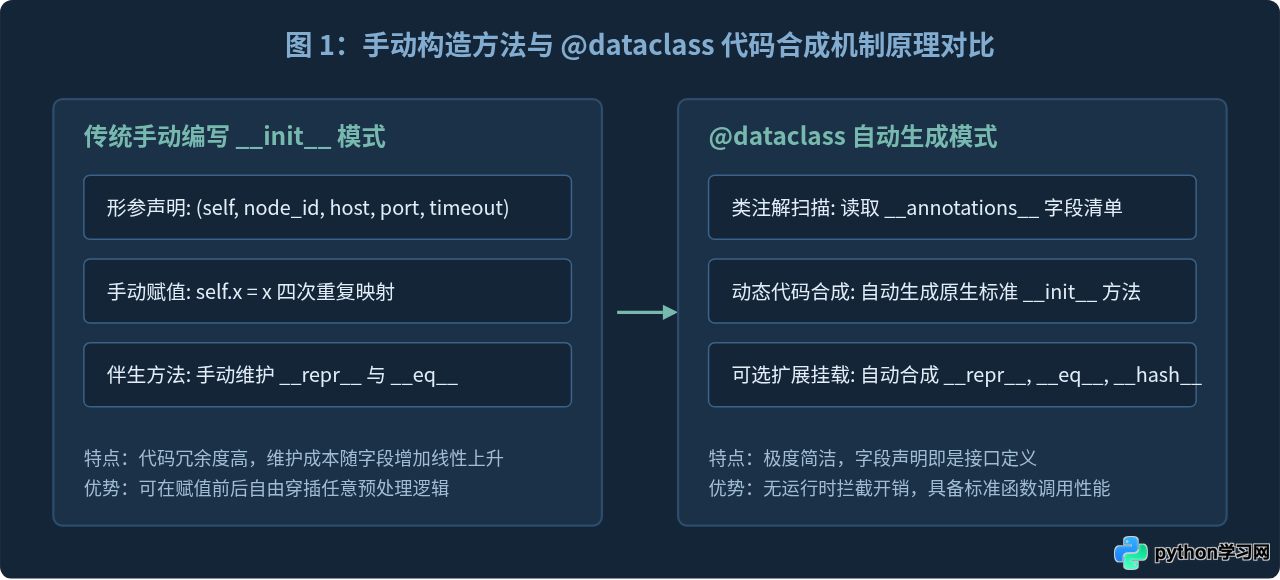
一、手动编写构造方法的痛点与 dataclass 的自动合成原理
在传统的 Python 类定义中,构造方法 __init__ 经常充斥着大量模板化的属性赋值语句。当类的字段逐渐增加时,开发者必须在形参列表、属性赋值语句、乃至后续的 __repr__ 与 __eq__ 方法中反复书写相同的属性名称。这种重复不仅繁琐,而且极易在重构或增删字段时遗漏某处对应关系。
假设我们定义一个服务节点的配置类,包含节点标识、主机名、端口以及超时时间:
# 传统方式:手动编写构造方法与支撑方法
class ServiceEndpoint:
    def __init__(self, node_id: str, host: str, port: int = 8080, timeout: float = 3.0):
        self.node_id = node_id
        self.host = host
        self.port = port
        self.timeout = timeout

    def __repr__(self) -> str:
        return f"ServiceEndpoint(node_id={self.node_id!r}, host={self.host!r}, port={self.port!r}, timeout={self.timeout!r})"

    def __eq__(self, other: object) -> bool:
        if not isinstance(other, ServiceEndpoint):
            return NotImplemented
        return (self.node_id, self.host, self.port, self.timeout) == (other.node_id, other.host, other.port, other.timeout)
如果改用 @dataclass,上述近二十行样板代码可以被精简为以下形式:
from dataclasses import dataclass

@dataclass
class ServiceEndpoint:
    node_id: str
    host: str
    port: int = 8080
    timeout: float = 3.0
@dataclass 装饰器并非在运行时通过 __getattr__ 动态拦截属性,而是在类声明加载期,检查类的类型注解(__annotations__),通过代码合成技术在内存中动态组装出一个完全标准的 __init__(self, node_id: str, host: str, port: int = 8080, timeout: float = 3.0) 方法并附加给该类。因此,在参数类型提示、IDE 自动补全及调用性能上,自动生成的构造方法与手写的构造方法表现完全一致。
二、通过 __post_init__ 与 field 实现高级构造逻辑
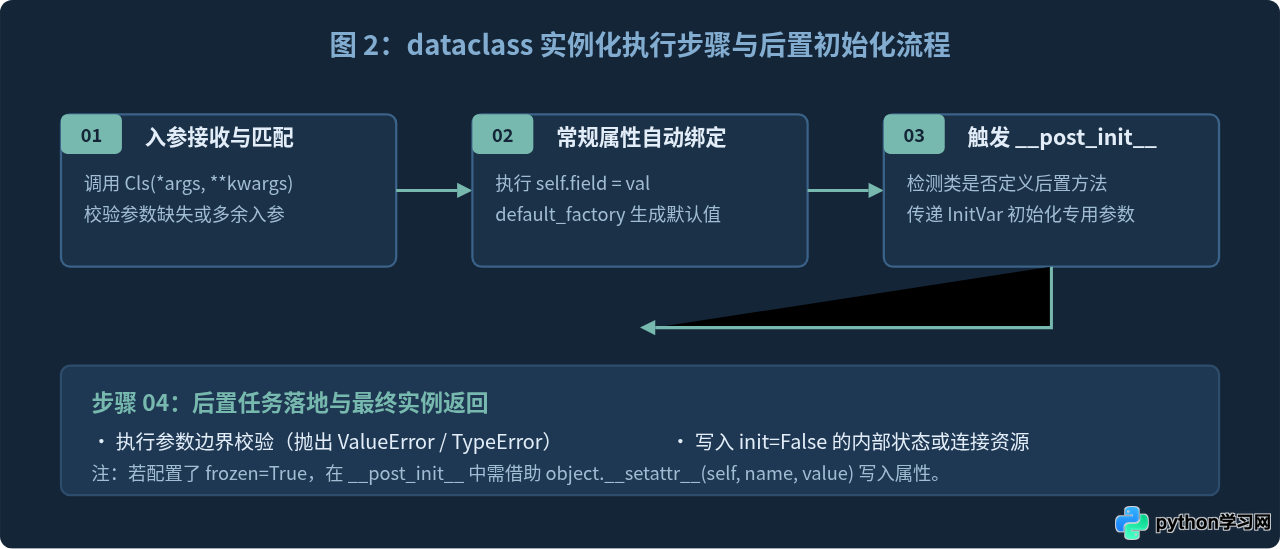
很多开发者担心替代 __init__ 会丧失执行“参数校验”与“派生属性推导”的能力。实际上,dataclasses 设计了专门的后置钩子函数 __post_init__ 来满足此类需求。
当合成的 __init__ 执行完毕基本字段的 self.field = field 绑定后,会自动检测并调用实例上的 __post_init__。此时所有已传入的属性都已经安全挂载在 self 上,开发者可以在此完成业务校验或计算衍生属性。
from dataclasses import dataclass, field

@dataclass
class DatabaseConnection:
    host: str
    port: int
    database: str
    # 派生字段:不直接在构造函数中由调用方传入,而由内部生成
    connection_url: str = field(init=False)
    # 集合类型必须通过 default_factory 规避可变默认值陷阱
    tags: list[str] = field(default_factory=list)

    def __post_init__(self):
        # 1. 参数合法性边界检查
        if not (1 <= self.port <= 65535):
            raise ValueError(f"无效的端口号: {self.port}")
        # 2. 派生字段赋值
self.connection_url = f"postgresql://{self.host}:{self.port}/{self.database}"def __init__(self, tags=[]) 中直接使用空列表会导致跨实例共享对象的著名陷阱。在 dataclass 中,直接书写 tags: list = [] 会在类加载时直接抛出 ValueError,强制要求使用 field(default_factory=list),从语法层面杜绝了此类隐患。
三、无法或不建议替代手动编写构造方法的典型场景
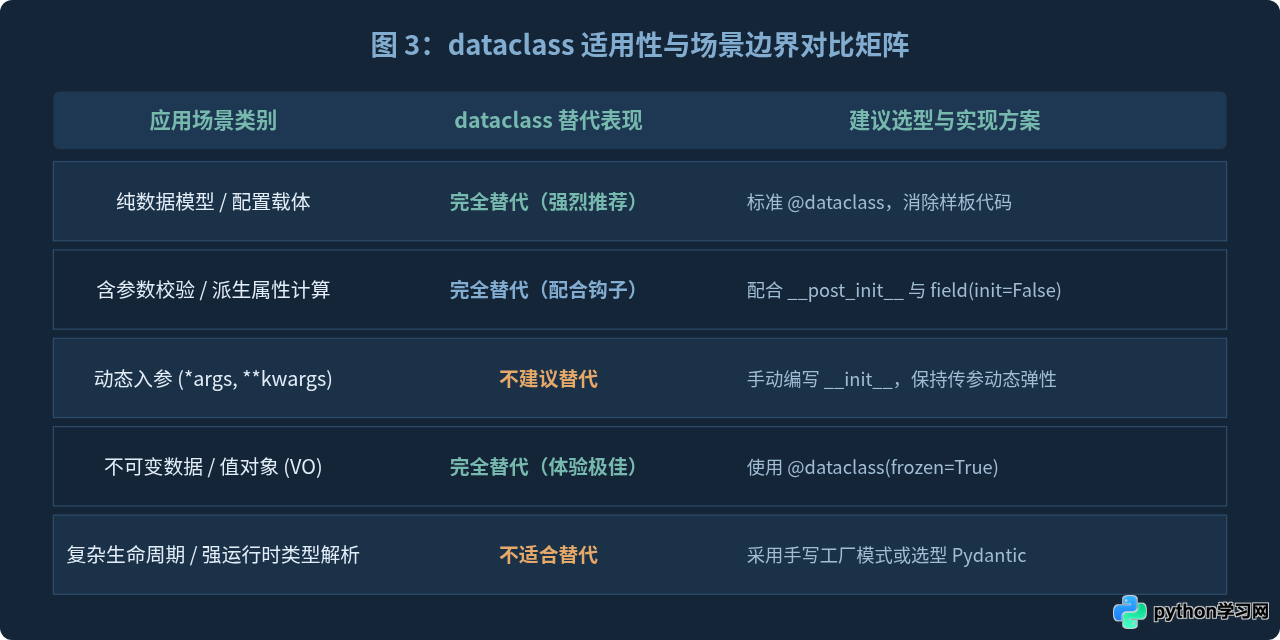
尽管 @dataclass 配合 __post_init__ 功能强大,但在面对复杂的面向对象设计时,它并不能覆盖所有构造需求。强行使用 dataclass 替代以下场景,往往会导致代码晦涩、难以维护:
1. 构造参数与类内部属性结构严重不对称
有时构造方法接收的参数仅仅是原始数据(例如二进制流、原始 JSON 字典或文件句柄),实例需要将其解构或转换后存入不同的内部属性中,而原始入参本身不需要保留。虽然可以使用 InitVar,但当参数体系完全非对称时,编写常规 __init__ 更加直截了当。
2. 需要灵活支持 *args 与 **kwargs 动态入参
dataclasses 的属性必须在类定义时显式声明类型注解。如果某个类需要兼任包装代理、装饰器转发或向下兼容多种遗留参数形态(例如接收任意扩展字典并在运行时动态展开),自动合成的确定性签名将成为束缚。
3. 不触发全量字段初始化的性能敏感或多构造路径场景
在底层网络协议解析、高性能几何计算等高频创建实例的循环中,如果需要跳过常规属性绑定,或需要多个拥有截然不同签名的重载构造路径(即使可通过 @classmethod 类方法弥补),手动控制的 __init__ 或 __new__ 依然具备更高的自由度。
@dataclass 装饰的类中同时手动手写 def __init__(self, ...)。虽然 Python 允许这样做(手动编写的 __init__ 会直接覆盖合成方法),但这会直接破坏类型注解与字段反射的同步机制,失去了使用 dataclass 的大部分意义。
四、工程落地选型决策路径
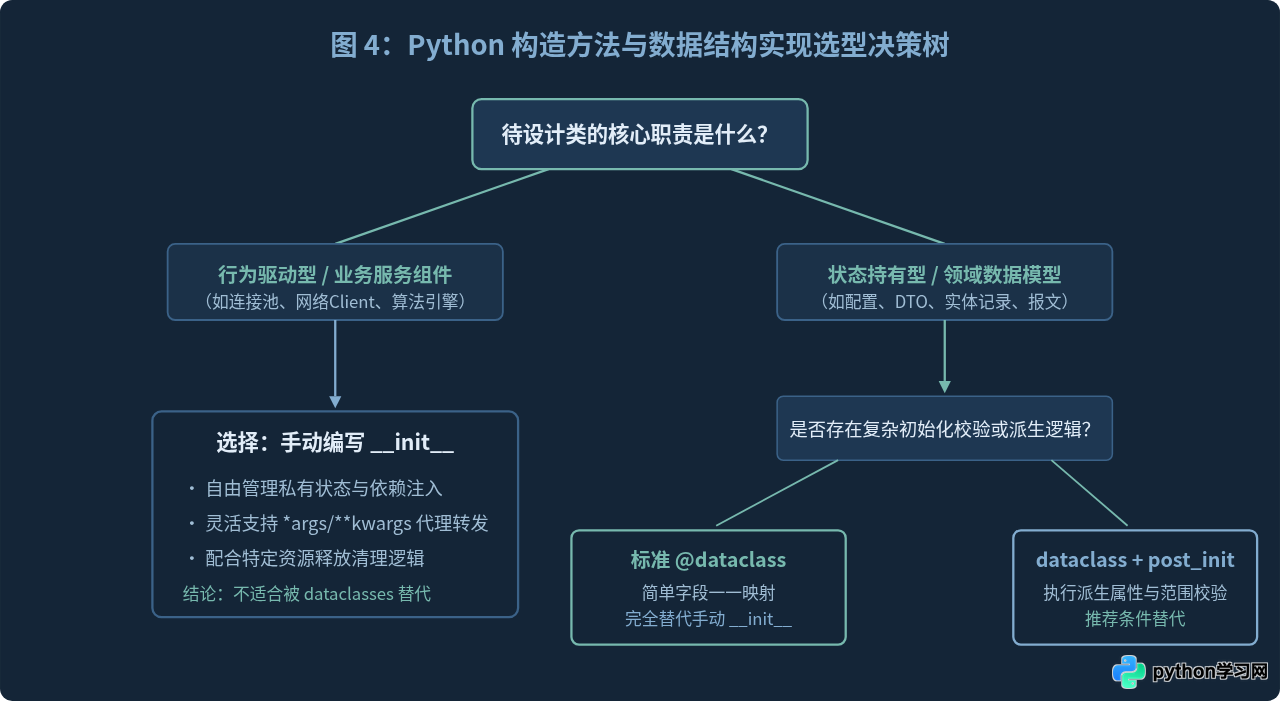
为了在实际项目中快速做出清晰决策,我们可以按照“类的职责特征”进行路径推演:
- 第一层判断:类的本质定位。如果类主要作为“数据状态的持有者”(Data Carrier),即属性与字段基本对齐,进入 dataclass 路线;如果类主要作为“行为执行器”(如带有复杂私有连接池的 Client、ORM 事务会话或抽象事件分发器),通常应保持普通类与手动编写
__init__。 - 第二层判断:初始化逻辑复杂度。在数据类路线中,若无特殊逻辑,直接使用标准
@dataclass;若有属性范围校验或次级计算,引入__post_init__。 - 第三层判断:严格验证与外部数据对接。如果需求涉及将未经验证的外部 JSON/字典强制类型转换为嵌套对象图,原生 dataclass 的轻量校验可能不足,应考虑
pydantic;若是内部受信任的数据流转,dataclass 是最优选择。
五、总结
回到最初的问题:Python dataclasses 能否替代手动编写的构造方法?
答案是“绝大多数数据建模场景下完全能够替代,且应当优先替代;但并不以彻底淘汰手动构造方法为目标”。在现代 Python 规范中:
- 对于存储数据、承载配置、定义不可变消息对象等纯数据载体,应当果断采用
@dataclass,借助编译期的代码合成规避数百行乏味冗余的__init__赋值及样板代码。 - 对于需要内部校验、计算或防御性复制的常规模型,充分利用
__post_init__和field(default_factory=...)完成扩展,避免回退到手写样板。 - 对于依赖注入、动态参数转发或复杂状态控制的服务类,继续使用手写的
__init__保持代码行为的直观与可控。
根据类的职责精准选用合适的构造机制,才是编写整洁、健壮且易于维护的 Python 代码的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















