


Python数据可视化库怎么选:Matplotlib、Seaborn与Plotly对比
深入对比 Python 主流数据可视化库 Matplotlib、Seaborn 与 Plotly 的设计哲学、代码样板、交互能力、性能表现与适用场景,提供系统化的选型决策指南。
一、三个库的设计哲学与技术本质
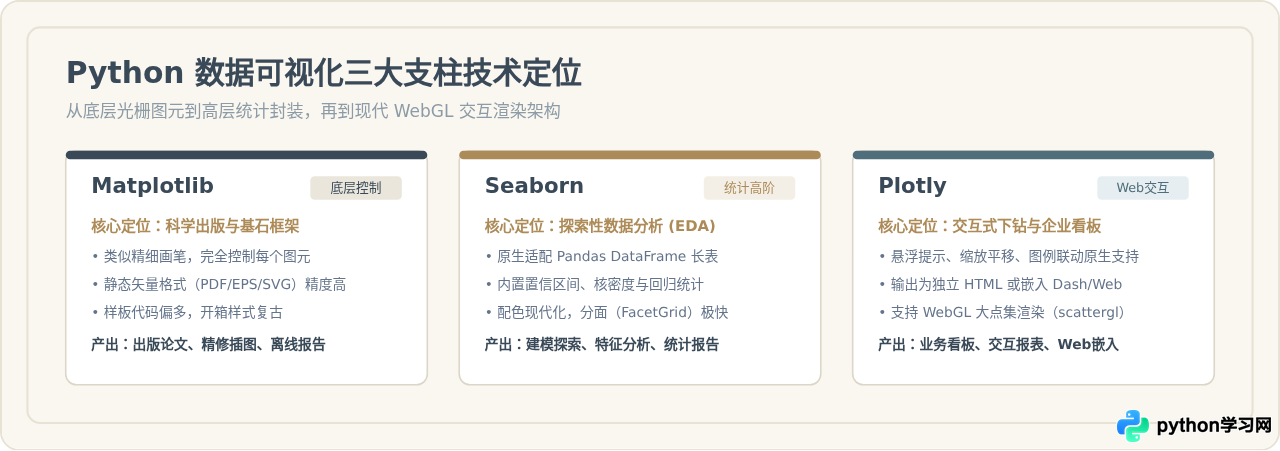
理解这三个库的第一步,是看清它们所处的抽象层级。它们并不是完全平行的竞争对手,而是诞生于不同技术周期、解决不同核心痛点的产物。
1. Matplotlib:底层的“工笔画板”
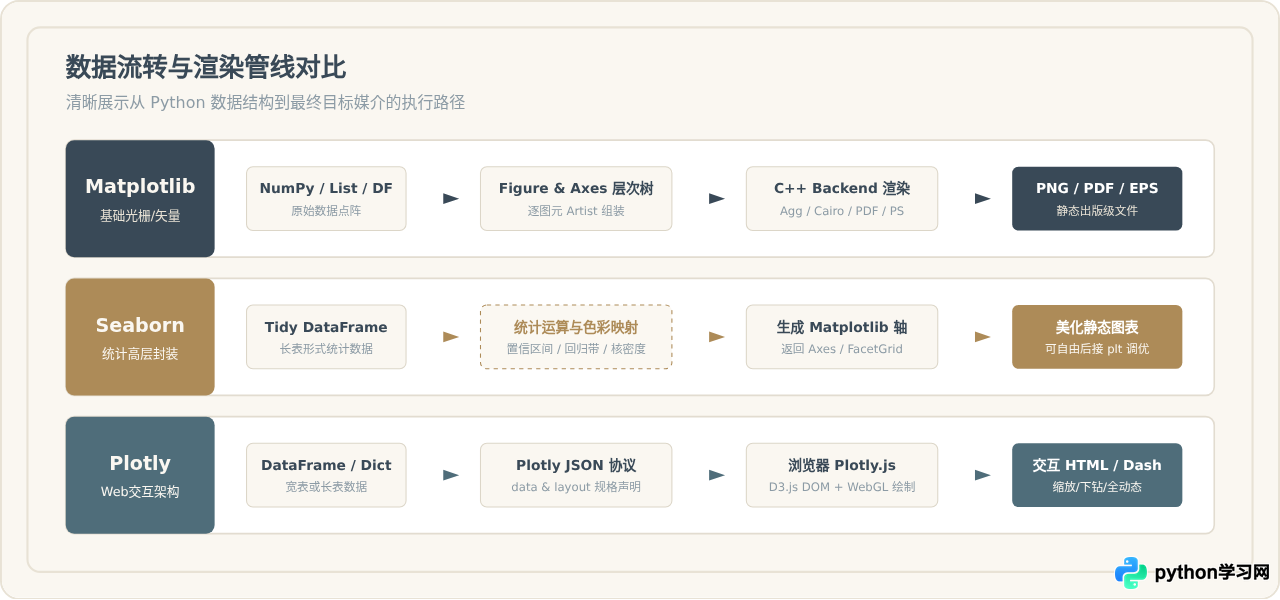
Matplotlib 诞生于 2003 年,初衷是为了在 Python 中重现 MATLAB 风格的绘图命令。它的架构建立在明确的对象模型之上:Figure(整张画布)、Axes(具体的子图坐标系)、Axis(轴线与刻度)以及各种 Artist(点、线、矩形、文字等图元)。
Matplotlib 最大的优势在于无限制的精细控制。如果你需要调整某根刻度线的长度、给特定数据点增加带弯折引线的注释,或者定制复杂的非对称子图布局,Matplotlib 都可以精确做到。但代价是代码冗长,且默认排版样式带有浓重的传统科学计算风格。
2. Seaborn:基于统计语义的高级封装
Seaborn 是直接构建在 Matplotlib 之上的高层库。它的设计哲学是面向统计问题,而非绘图细节。Seaborn 与 Pandas 深度绑定,强调“整洁数据(Tidy Data)”的输入形式。
当你用 Seaborn 绘制散点图时,不需要写循环来为不同类别映射颜色,只需要指定 hue='category';当你画折线图时,它会自动聚合重复观测值并绘制 95% 置信区间阴影带。更重要的是,Seaborn 返回的依然是 Matplotlib 的 Axes 或 FacetGrid 对象,这意味着你可以随时用 Matplotlib 的底层 API 对图表进行后处理。
3. Plotly:基于 Web 标准的交互式引擎
Plotly(尤其是目前主流的 plotly.express 接口)与前两者有本质不同。它的底层渲染并不依赖 Python 的本地图形设备,而是将 Python 对象序列化为符合 Plotly.js 规范的 JSON 结构,交由浏览器端的 D3.js 和 WebGL 完成绘制。
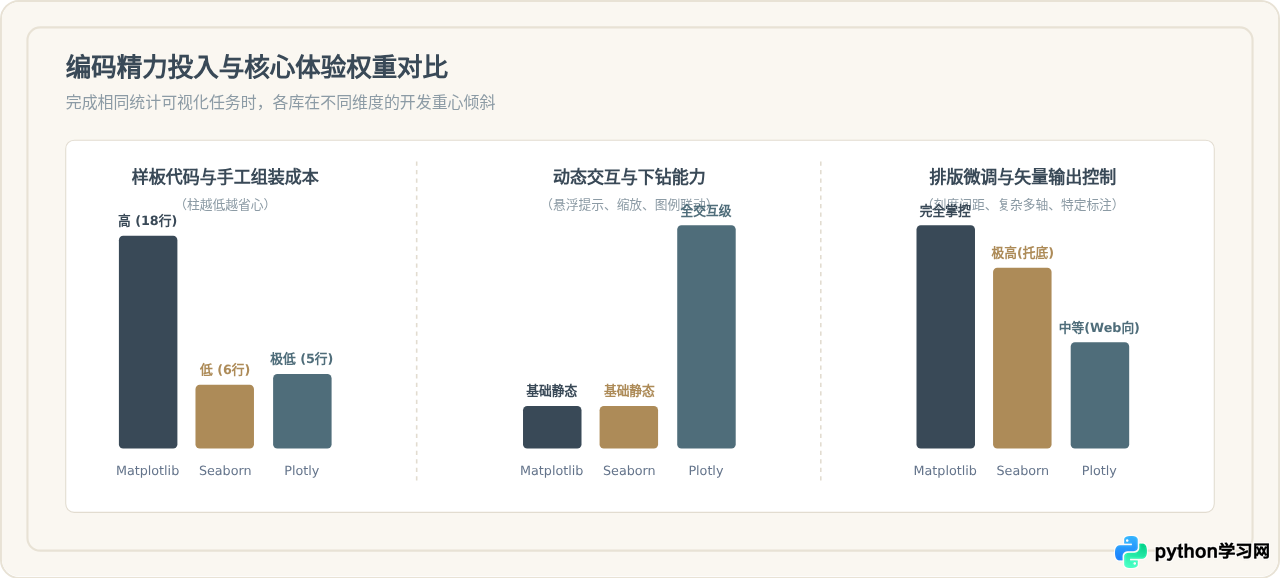
这意味着 Plotly 天然具备现代网页端的一切交互特性:鼠标悬浮查看数值详情(Tooltip)、框选放大、双击还原、点击图例显示/隐藏特定系列、以及三维视角拖拽旋转。对于需要将分析结果分享给非技术人员或嵌入 Web 应用的场景,Plotly 具有不可替代的体验优势。
二、同一业务场景的代码实现对比
为了具体感受三者的开发体验差异,我们以一个典型的实际分析任务为例:绘制一个包含多类别分组的散点图,并为各组添加线性拟合回归线与网格背景。
1. 准备示例数据
import numpy as np
import pandas as pd

# 构造模拟测试数据:包含两个类别的数据集
np.random.seed(42)
n_samples = 80
data = pd.DataFrame({
    'x': np.concatenate([np.random.normal(5, 1.5, n_samples), np.random.normal(8, 2, n_samples)]),
    'y': np.concatenate([np.random.normal(15, 3, n_samples), np.random.normal(25, 4, n_samples)]),
    'category': ['Group A'] * n_samples + ['Group B'] * n_samples
})
2. Matplotlib 实现:手动控制与装配
在纯 Matplotlib 中,不存在直接处理分类列并自动计算拟合线的语法。开发者需要手动拆分数据、写循环调用 ax.scatter()、借助 NumPy 的 polyfit 计算拟合参数、分别添加图例与美化:
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(8, 5), dpi=100)
colors = {'Group A': '#394957', 'Group B': '#AD8B58'}

for cat, group in data.groupby('category'):
    # 绘制散点
    ax.scatter(group['x'], group['y'], label=cat, color=colors[cat], alpha=0.7, edgecolors='none')
    # 手动计算线性拟合
    m, b = np.polyfit(group['x'], group['y'], 1)
    x_seq = np.linspace(group['x'].min(), group['x'].max(), 50)
    ax.plot(x_seq, m * x_seq + b, color=colors[cat], linewidth=2)

ax.set_title("Matplotlib: Multi-group Scatter with Fit Line", fontsize=12)
ax.set_xlabel("Feature X")
ax.set_ylabel("Target Y")
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(title="Category")
plt.tight_layout()
plt.show()评价:代码行数较多,属于机械式的组装操作。但其优势在于每个环节都暴露在开发者掌控之下,如果拟合线不需要全区间覆盖或需要添加特定标注,调整极其自由。
3. Seaborn 实现:语义化一行成图
Seaborn 识别到了上述常见痛点,通过面向统计的参数设计,将上述十余行操作收缩为极简调用:
import seaborn as sns
import matplotlib.pyplot as plt

sns.set_theme(style="whitegrid", palette=["#394957", "#AD8B58"])

g = sns.lmplot(
    data=data, x="x", y="y", hue="category",
    height=5, aspect=1.6, scatter_kws={'alpha': 0.7}
)
g.set_axis_labels("Feature X", "Target Y")
g.fig.suptitle("Seaborn: Multi-group Scatter with CI Band", y=1.02)
plt.show()评价:Seaborn 不仅自动处理了分组上色与线性拟合,还默认利用 Bootstrap 算法计算并绘制了 95% 置信区间阴影带。开发效率极高,极为契合探索性数据分析(EDA)的心智流。
4. Plotly 实现:开箱即用的 Web 交互
使用 Plotly Express(高层接口),同样只需要寥寥几行代码,但成图直接附带了完整的交互工具箱:
import plotly.express as px

fig = px.scatter(
    data, x="x", y="y", color="category",
    trendline="ols",
    title="Plotly: Interactive Scatter with OLS Regression",
    color_discrete_sequence=["#394957", "#AD8B58"],
    template="plotly_white"
)
# 支持导出为单文件离线 HTML
fig.write_html("interactive_chart.html")
fig.show()评价:不仅自动调用 Statsmodels 进行普通最小二乘法(OLS)回归并生成拟合线,鼠标悬停在点或线上时,还能即时看到具体的拟合公式、R² 得分、坐标数值,并且支持框选放大和图例单选。
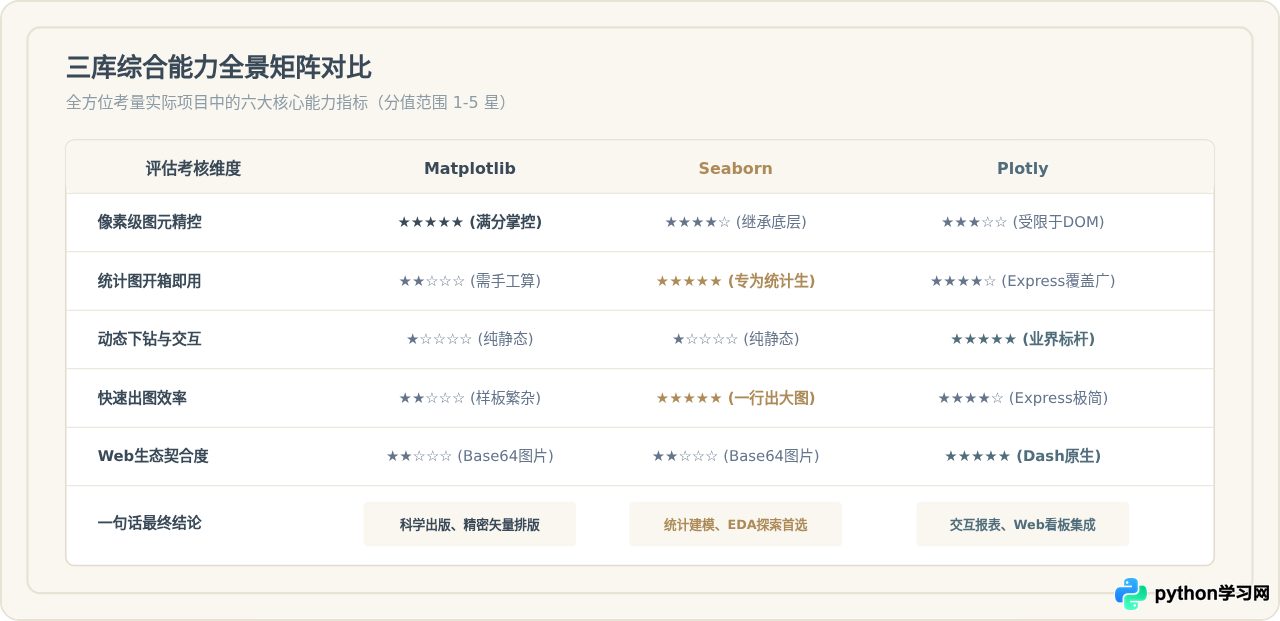
三、核心维度横向深度对比
| 对比维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 抽象层级 | 底层基础设施(Low-level API) | 统计高阶封装(High-level API) | 声明式全功能套件(Express + Graph Objects) |
| 输入数据契约 | NumPy 数组、原生 List、Pandas Series | 强依赖 Pandas 长表(Tidy DataFrame) | Pandas DataFrame、字典列表、GeoJSON |
| 输出格式 | PNG、JPG、SVG、PDF、EPS 静态图像 | 继承 Matplotlib 静态格式 | 独立 HTML 文件、JSON 规格、Dash 组件、静态图(需 kaleido) |
| 交互支持 | 弱(仅支持简陋的本地 GUI 窗口平移缩放) | 弱(纯静态) | 原生强交互(Tooltip、动态缩放、滑块、动画序列) |
| 大数据量性能 | 静态绘制极快,光栅化后只占一张图的内存 | 依赖 Matplotlib,大数据量计算置信区间较慢 | 普通 SVG 模式超过 2 万点会卡顿;切换 scattergl(WebGL)可承载百万点 |
| 学习曲线 | 陡峭(需理解 Figure、Axes、Spines 等复杂对象) | 平缓(记住核心统计图表函数即可) | 平缓(Plotly Express 上手极快,但深入 Layout JSON 略琐碎) |
四、具体选型决策路径
面对具体的数据项目,请按照以下判定流程确定技术栈:
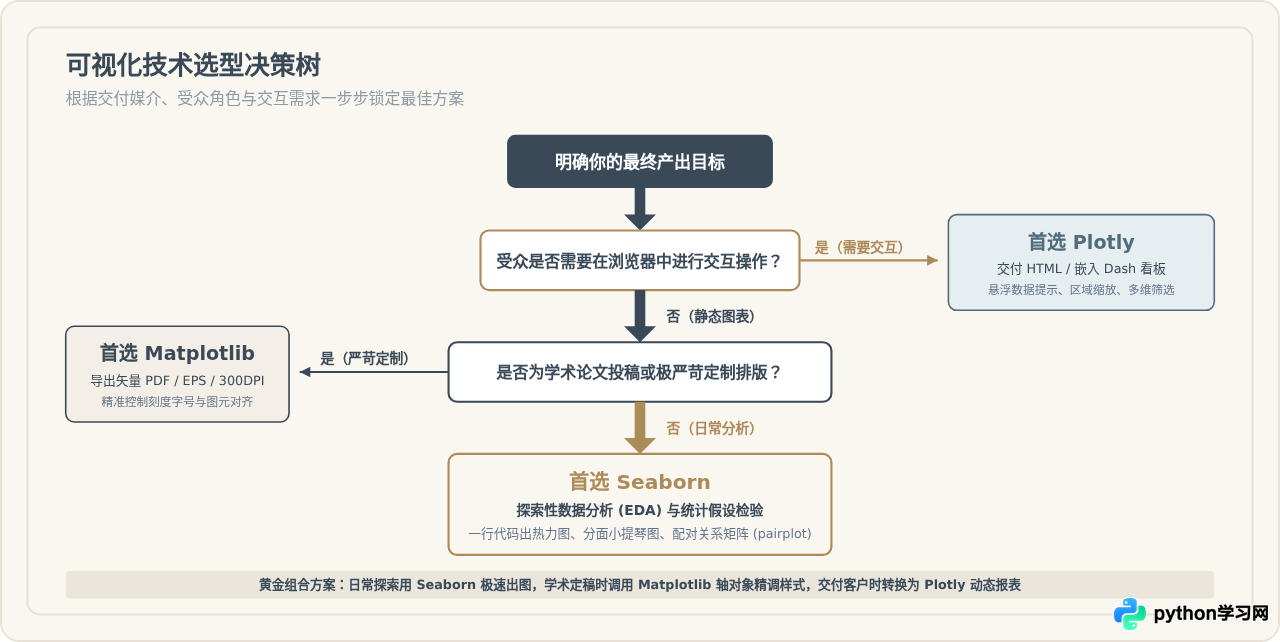
场景 1:学术论文、期刊投稿、技术图书(选 Matplotlib)
学术期刊通常对矢量图形格式(如 EPS、PDF、高分辨率无压缩 TIFF)、字体嵌入以及单双栏排版宽度有硬性规定。
- 优势:Matplotlib 对 LaTeX 公式渲染(
plt.rc('text', usetex=True))支持极佳;能精确把控图表物理尺寸(如指定为 IEEE 标准单栏宽度 3.5 英寸)。 - 操作建议:可以通过
sns.set_context("paper")快速获得适合论文的字阶,然后再使用原生 Matplotlib 的ax.set_xticks()等精修刻度。
场景 2:日常数据探索(EDA)、统计建模报告(选 Seaborn)
当面对一个陌生的数据集,需要快速洞察特征之间的相关性、变量分布偏态或者分组对比时,Seaborn 是最省时省力的利器。
- 代表函数:
sns.heatmap(df.corr(), annot=True)(相关系数热力图)、sns.pairplot(df, hue="label")(多变量特征成对散点矩阵)、sns.boxplot()与sns.violinplot()(数据分布对比)。 - 操作建议:确保 DataFrame 是格式规范的长表(Tidy Data),Seaborn 会自动将列名映射为图例与轴标题。
场景 3:商业智能看板、Web交互报表、非技术客户交付(选 Plotly)
当图表需要交付给产品经理、业务运营或客户查看时,静态图表往往无法满足他们“看具体数值”、“放大异常波动区间”的需求。
- 优势:Plotly 生成的单一 HTML 文件内嵌所有必要数据和 JS 脚本,无需配置后端 Python 环境即可通过邮件或内网直接分发阅读。
- 工程集成:与 Streamlit、Dash 等现代 Python Web 框架无缝协同,可轻松构建带交互控件的企业级数据大屏。
使用 Plotly 导出
fig.write_html() 时,默认会将整张图的数据和 Plotly.js 运行库打包进 HTML,文件通常在 3MB~4MB 左右。如果需要分发多个小图,建议设置 include_plotlyjs='cdn',仅引用外部 CDN 脚本,可使 HTML 体积骤降至几千字节。另外,当数据点超过 50,000 个时,请使用 plotly.graph_objects.Scattergl 启用 WebGL 硬件加速,避免浏览器卡死。
五、全景评估总结与混合架构实践
在实际成熟的数据工程中,专业开发者极少局限在单一工具中,而是构建混合可视化流水线:
- 探索阶段(第 1 小时):在 Jupyter Notebook 中利用
seaborn快速看分布、查异常值、印证假设。 - 决策与报告阶段(第 2 小时):
- 若交付为 PDF 汇报或离线打印稿,调用
matplotlib固化图表样式并导出高保真图像; - 若交付为在线演示或团队协同知识库,用
plotly.express重新渲染核心图表,导出交互 HTML。
- 若交付为 PDF 汇报或离线打印稿,调用
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















