


Python与R语言的数据可视化能力对比:Matplotlib、Seaborn与ggplot2

一、架构设计与底层哲学对比
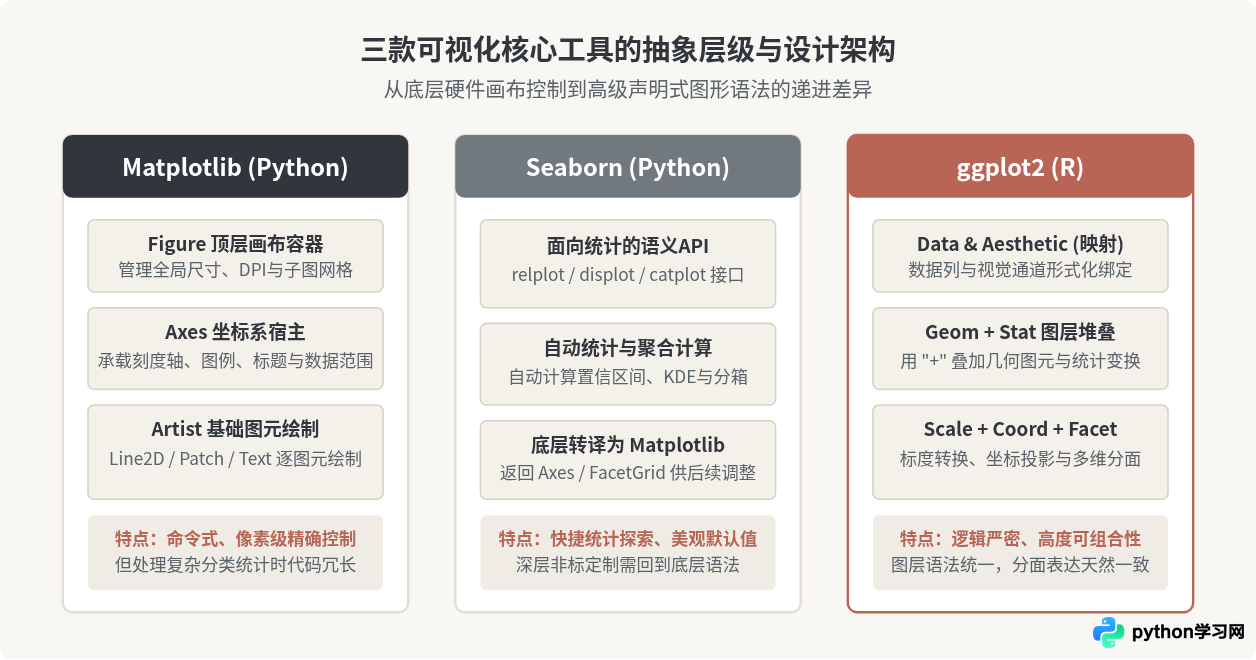
要理解Matplotlib、Seaborn与ggplot2的根本差异,首先必须厘清它们构建图表时的思维模型。不同的设计哲学决定了编写代码时的思维路径与调试成本。
1. Matplotlib:命令式与画布对象模型
Matplotlib诞生于2000年代初,最初设计目标是在Python中复刻MATLAB的绘图体验。它的核心体系建立在面向对象的画布容器模型之上:最外层是Figure(画布),内部包含一个或多个Axes(坐标区),每个坐标区内又由Axis(刻度轴)、Tick(刻度线)、Line2D、Polygon等被称为Artist的基本视觉元素构成。在Matplotlib中,几乎所有视觉特征都是通过逐步调用方法“绘制”上去的。这种命令式模型赋予了开发者极高的控制力,但代价是绘制复杂多变量图形时需要手写大量循环、颜色映射与布局计算代码。
2. Seaborn:基于统计语义的高级封装
Seaborn建立在Matplotlib基础之上,旨在解决Matplotlib在处理现代数据框(Pandas DataFrame)时语法繁琐、默认样式陈旧的问题。Seaborn并不重构底层图元,而是直接接受长表或宽表数据,通过语义化参数(如x、y、hue、style、col)把数据列自动映射到坐标、颜色、标记与分面画布中。在完成统计汇总与布局后,Seaborn返回底层的Matplotlib Axes或FacetGrid对象,允许开发者继续使用Matplotlib的原生命令调整局部细节。
3. ggplot2:正统的图层图形语法体系
R语言中的ggplot2实现了Leland Wilkinson在《The Grammar of Graphics》中提出的理论框架。在ggplot2看来,统计图表绝非简单的点线堆叠,而是由明确的形式化组件组成的系统:数据(Data)、美学映射(Aesthetic Mappings)、几何对象(Geometric Objects)、统计变换(Statistical Transformations)、标度(Scales)、坐标系(Coordinates)与分面(Faceting)。各组件通过操作符+依次层叠组合。这种高度声明式的结构使得逻辑极其一致:无论是散点图、小提琴图还是热力图,语法的组织骨架完全相同。
二、典型场景实测与代码工作流对比
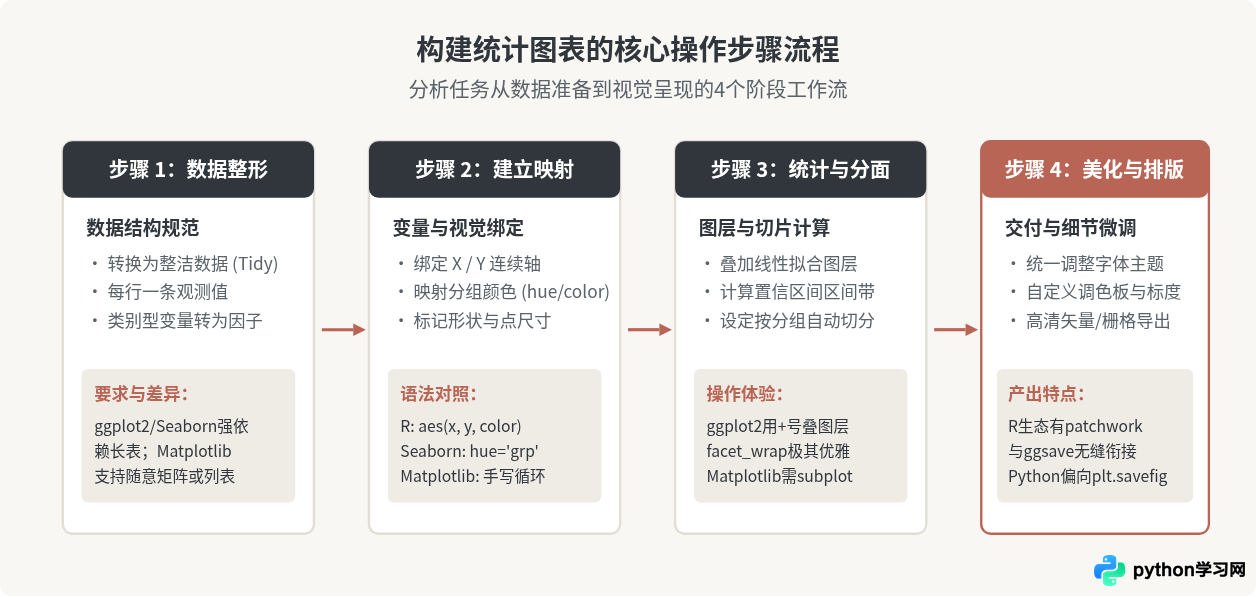
为了直观展现三者在开发体验上的差异,我们通过一个常见的数据科学场景进行对比:加载一份包含连续变量与分类变量的数据集,绘制多组别的散点图,附加线性拟合回归线,并按照分类变量进行子图分面(Faceting)展示。
1. Matplotlib 实现:手动布局与逻辑循环
在Matplotlib中,没有一键根据分组变量切分子图的高级语义。开发者需要自行计算分类水平,生成子图网格,并在每个子图上单独过滤数据、计算拟合线、添加图例与标签:
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

# 示例数据结构
df = pd.DataFrame({
    'x': np.random.rand(100),
    'y': np.random.rand(100) * 2 + 1,
    'group': np.random.choice(['Category A', 'Category B'], size=100)
})

groups = df['group'].unique()
fig, axes = plt.subplots(1, len(groups), figsize=(10, 4), sharey=True)

colors = {'Category A': '#B96555', 'Category B': '#30363C'}

for ax, grp in zip(axes, groups):
    sub = df[df['group'] == grp]
    # 散点图元
    ax.scatter(sub['x'], sub['y'], color=colors[grp], alpha=0.7, label=grp)
    # 计算拟合趋势线
    m, b = np.polyfit(sub['x'], sub['y'], 1)
    ax.plot(sub['x'], m * sub['x'] + b, color='#71787E', linestyle='--')
    ax.set_title(f"Group: {grp}")
    ax.set_xlabel("Feature X")
    ax.grid(True, linestyle=':', alpha=0.6)

axes[0].set_ylabel("Target Y")
plt.tight_layout()
plt.show()
可以看到,虽然最终图表结构清晰,但逻辑中充斥着状态循环、统计拟合公式调用以及子图间坐标轴共享的显式配置。当分类变量变为两维网格时,代码行数与复杂度将成倍增长。
2. Seaborn 实现:面向数据框的列映射
Seaborn大幅精简了这一流程,通过sns.lmplot()直接完成分组切分、线性回归拟合以及分面排列:
import seaborn as sns

# 同样的数据需求,只需声明映射关系
g = sns.lmplot(
    data=df,
    x='x',
    y='y',
    hue='group',
    col='group',
    palette=['#B96555', '#30363C'],
    height=4,
    aspect=1.2
)
g.set_axis_labels("Feature X", "Target Y")
g.set_titles(col_template="Group: {col_name}")
Seaborn自动处理了分组循环、置信区间带的计算以及图例合并。开发者无需干预统计计算过程,直接获得了符合统计分析标准的图形输出。
3. ggplot2 实现:清晰的图层组合
在R语言中,ggplot2的代码展现了完全不同的正交性与解耦特征。每一个+代表向画布追加一层语义:
library(ggplot2)

ggplot(df, aes(x = x, y = y, color = group)) +
  geom_point(alpha = 0.7, size = 2) +
  geom_smooth(method = "lm", se = TRUE, linetype = "dashed", color = "#71787E") +
  facet_wrap(~ group) +
  scale_color_manual(values = c("Category A" = "#B96555", "Category B" = "#30363C")) +
  theme_minimal() +
labs(x = "Feature X", y = "Target Y")在ggplot2中,如果希望移除线性拟合线,只需删去geom_smooth();如果希望将分面改为颜色区分在同一图内展示,只需删去facet_wrap()。各组件之间相互独立,逻辑极其严密。
三、多维度能力深层对比
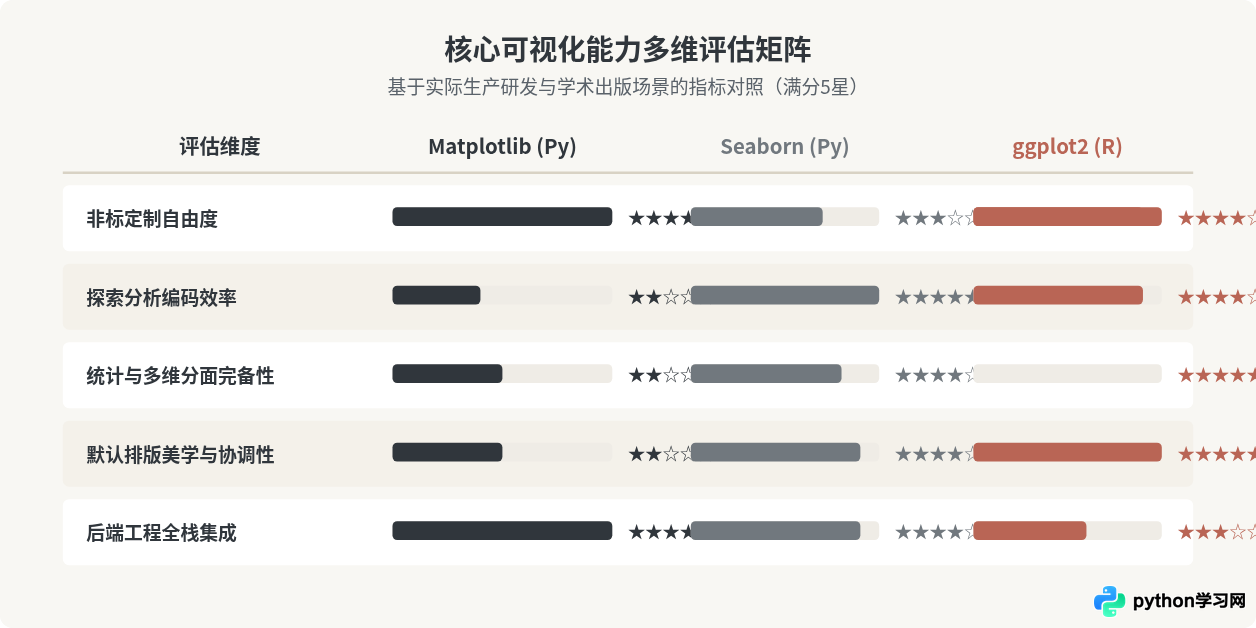
除了代码行数的直观感受,在实际生产和研究工作中,三个工具在统计完备性、深度定制、生态互联等方面存在显著的边界:
| 评估维度 | Matplotlib | Seaborn | ggplot2 |
|---|---|---|---|
| 语法范式 | 命令式(Procedural / Object-Oriented) | 高级统计封装(High-level API) | 声明式图层语法(Grammar of Graphics) |
| 多变量分面能力 | 较弱。需开发者手动计算并遍历Subplots网格 | 强。内置FacetGrid,通过col/row参数快捷切分 | 极强。内置facet_wrap与facet_grid,标度自动自适应 |
| 非标细节定制 | 极高。所有像素、线段、字体和外边框均可操控 | 中等。受限于封装层,深层定制需回退到Matplotlib | 高。通过灵活的theme()函数与扩展包组合 |
| 默认美学与设计 | 偏向传统学术和工程风格,默认排版较素 | 现代美观,内置精致配色与科学网格预设 | 出版级标准,坐标轴比例、图例位置与配色和谐度极佳 |
| 扩展包生态 | 庞大,包含大量特定领域工具(如Cartopy、MNE) | 主要作为Python数据科学生态的一环,自身扩展较少 | 繁荣无比(ggpubr、ggrepel、gganimate、patchwork) |
| 工程集成能力 | 极强。天然与Flask、Django、FastAPI后端集成 | 强。无缝融入Jupyter与Python后端服务 | 适中。主要用于R Markdown、Quarto与Shiny交互 |
四、差异背后的成因与使用注意事项
很多开发者在跨语言迁移时会产生困惑:“为什么Python没有诞生出一个完全取代Matplotlib的ggplot2等价物?”或者“为什么R语言中几乎很少有人直接写底层Grid图元?”这种生态现状是由语言基因与数据科学工作流决定的。
1. 数据管道的连续性差异
R语言内置对向量与数据框(DataFrame)的原生支持,结合tidyverse套件中的管道操作符(%>% 或 |>),形成了“数据清洗 -> 分组汇总 -> ggplot2图层可视化”的一体化连续流。整个流程中数据的长表结构保持不变,不需要显式切换上下文。
而在Python中,Pandas本身是一个外部库,开发者的下游任务往往涉及PyTorch、Scikit-learn或Web API框架。Python更倾向于“面向对象”与“函数调用返回句柄”。这也是为什么Seaborn选择返回Matplotlib对象,以便与整个Python科学计算栈(如Scipy、NumPy、SymPy)保持无缝互操作。
2. 常见痛点与避坑提醒
- Matplotlib的内存泄漏隐患:在批量生成图片或Web服务并发生成图表时,务必在保存后显式调用
plt.close(fig)。否则,全局Figure管理器会常驻内存,导致服务器内存随着请求次数线性耗尽。 - Seaborn的对象层级混淆:Seaborn有两类绘图函数,一类是Axes级函数(如
sns.scatterplot),另一类是Figure级函数(如sns.relplot)。试图对Figure级函数直接传入ax=...会导致报错或产生不可预期的多余画布。 - ggplot2的非标准计算(NSE)调试:ggplot2在
aes()中大量采用非标准计算,直接传入字符串列名往往不会生效。在编写通用函数或批量脚本时,需要改用.data[[col_name]]或注入语法({{ col_name }})进行正确解包。
五、技术选型决策路径与落地建议
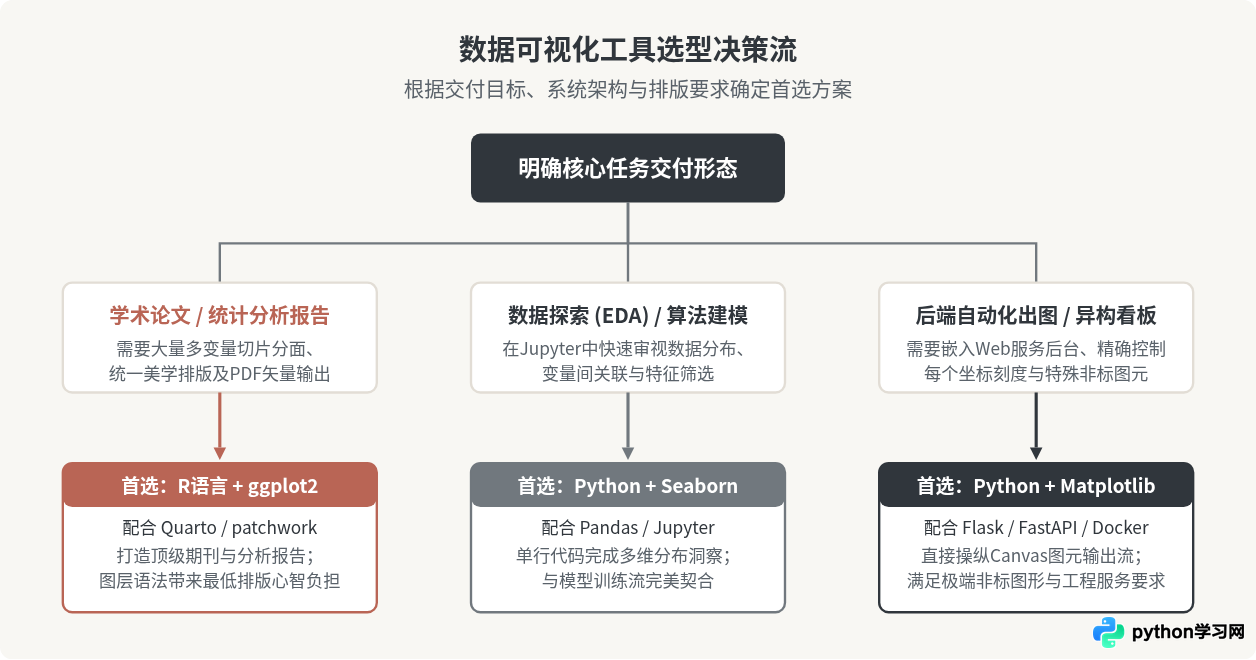
在了解了各自的优势与局限后,实际技术选型不应停留在抽象的喜好争论,而应当依据具体的业务阶段与交付形式做出决断。
跨语言互补方案建议
在现代数据团队中,Python与R语言并非互斥对立。如果团队技术栈以Python为主,但极度渴望拥有类似ggplot2的图层语法体验,可以考虑使用Python生态中的plotnine库。它几乎完整实现了ggplot2在Python端的语法移植,且底层直接接收Pandas DataFrame。
反之,如果在严谨的生物信息学或统计学研究中,核心统计推断与图形交付由R完成,但数据前期清洗或深度学习推理依赖Python,则可以通过reticulate包实现双语无缝互调,让两者在各自最擅长的边界内发挥最大生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















