


新手怎么下载Anaconda搭建Python数据科学环境
面向新手的Anaconda下载、安装与Python数据科学环境搭建完整指南。详细讲解官网与镜像源下载、安装选项配置、Conda命令验证、虚拟环境隔离以及Jupyter Notebook快速上手。
搭建Python数据科学环境最直接、省心的方式,是安装集成了Python解释器、核心科学计算库与环境管理工具的Anaconda发行版。本文将详细讲解如何获取官方或镜像安装包、选择适合新手的安装选项、通过终端验证基础环境,以及如何通过独立虚拟环境和Jupyter Notebook开展第一次数据分析工作。
一、认识Anaconda与数据科学环境
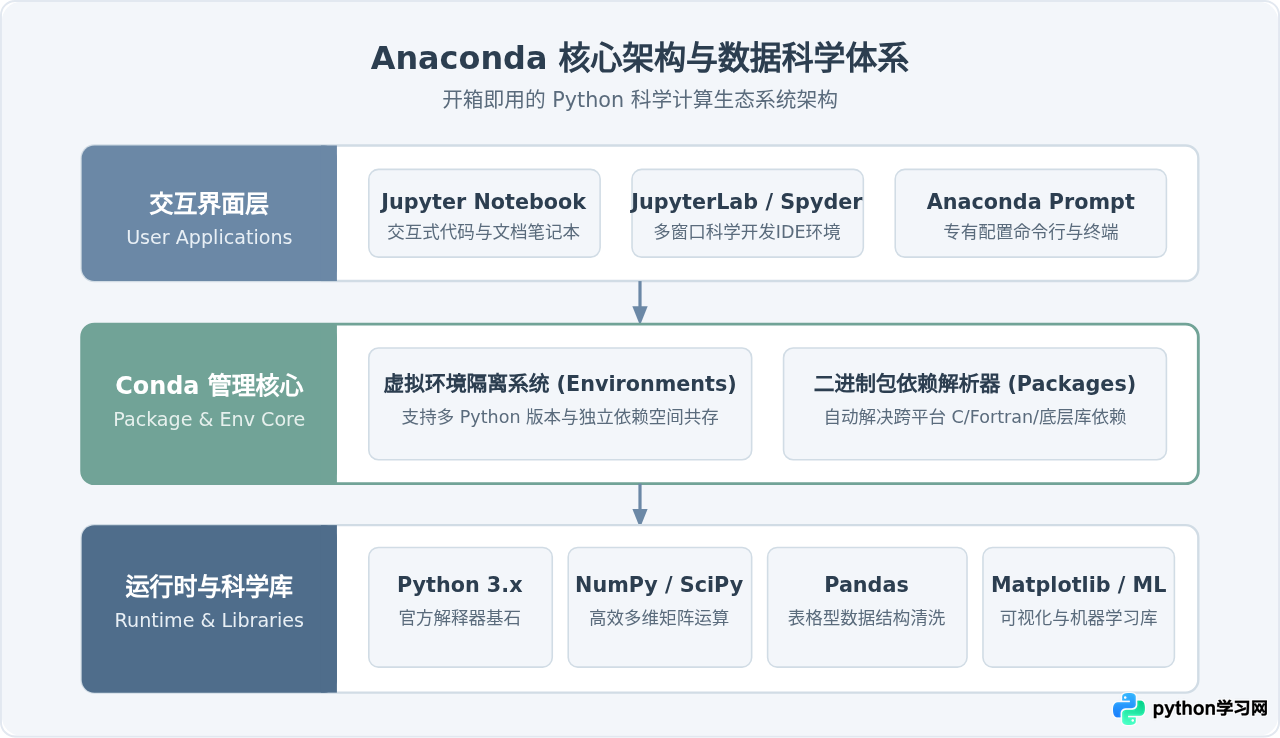
Python本身只提供基础的语言运行时与标准库。在实际进行数据分析、统计建模或机器学习时,通常需要依赖NumPy进行数值计算、Pandas处理结构化表格、Matplotlib与Seaborn绘制图表,以及Scikit-learn进行特征工程与建模。如果是初学者从Python官方网站下载基础安装包,后续需要手动通过命令行逐一编译并安装这些依赖库,往往容易因为C/C++编译底层环境缺失或依赖冲突而受阻。
Anaconda(官方称为Anaconda Distribution)是一个专门为科学计算和数据分析量身定制的开源发行版。它打包了Python语言解释器、预装了超过250个常用的数据科学与机器学习算法包,更核心的是内置了Conda包与虚拟环境管理系统。通过Conda,开发者可以把每个项目的依赖与Python版本隔离开来,从源头上杜绝“项目A需要高版本库、项目B需要低版本库”的冲突问题。
二、下载安装包:官方渠道与国内镜像站
Anaconda官方安装包体积通常在600MB至1GB左右。新手可以根据自身网络连接情况选择下载途径:
- 官方直连渠道:访问 Anaconda 官方网站下载页面(
https://www.anaconda.com/download)。系统通常会自动识别当前的操作系统(Windows、macOS 或 Linux),点击首页显著的“Download”绿色按钮即可下载对应系统的最新版本安装包。 - 高校开源镜像站(推荐国内网络):如果在官网下载出现下载中断或速率只有几十KB/s的情况,可以使用国内由高校维护的开源镜像站。例如清华大学开源软件镜像站(TUNA)的 Anaconda 仓库路径为
https://mirrors.tuna.tsinghua.edu.cn/anaconda/archive/。进入页面后,滑动至列表最下方按时间排序,选择最新日期的对应平台安装包(如 Windows 选择Anaconda3-xxxx.xx-Windows-x86_64.exe,macOS 苹果芯片选Anaconda3-xxxx.xx-MacOSX-arm64.pkg,Intel 芯片选x86_64.pkg)。
三、安装全流程及新手避坑选项
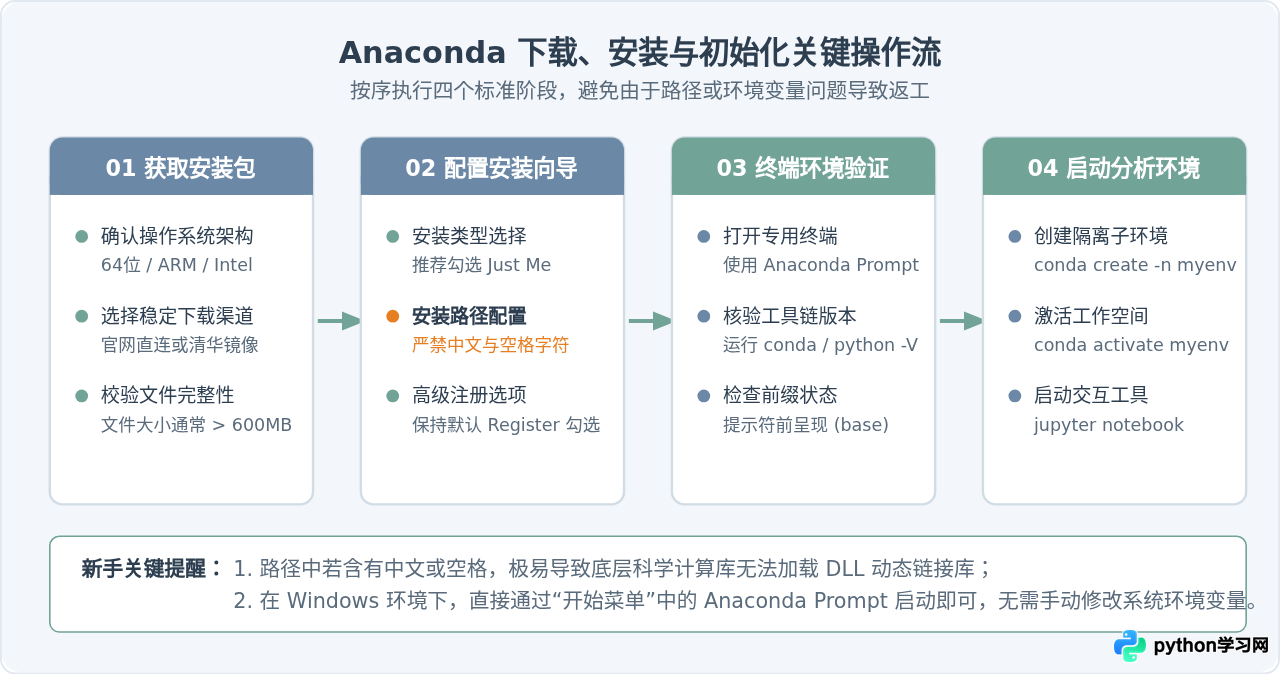
下载好安装文件后,双击运行安装向导。安装过程大多数界面保持默认点击“Next”或“Agree”即可,但在路径设置与高级选项两步,有两个极其重要的细节需要特别注意:
1. 安装路径的选择原则(绝对不要包含中文或空格)
安装向导会提示选择安装目标目录(Destination Folder)。默认路径一般为 C:\Users\你的用户名\anaconda3。如果你的 Windows 操作系统登录用户名是中文(例如“张三”),安装路径就会变成 C:\Users\张三\anaconda3。由于底层许多科学计算组件(如底层 BLAS、LAPACK、Fortran 编译器接口)在解析带中文字符或空格的文件路径时会出现编码截断或找不到动态库的问题,强烈建议新手手动修改路径,例如安装在 C:\anaconda3 或其他磁盘根目录的非中文文件夹下(如 D:\anaconda3)。
2. “Just Me” 与 “All Users” 的选择
在选择安装类型界面,有两个选项:
Just Me (recommended):仅为当前操作系统用户安装。不需要管理员提权,软件安装在用户目录下,后续更新包或创建新虚拟环境时不会因为权限不足报错。初学者一律推荐选此项。All Users (requires admin privileges):为电脑上所有用户安装。该选项需要以管理员权限运行,后续安装部分外部包时可能会因为系统权限保护引发写入失败。
3. 环境变量(Advanced Options)如何勾选
在“Advanced Installation Options”界面,通常有以下两个核心复选框:
Add Anaconda3 to my PATH environment variable:将 Anaconda 注入系统全局 PATH 变量。安装向导通常将此项标记为红色不推荐(Not recommended)。原因在于如果电脑此前或后续安装了独立的 Python 解释器,或者其他软件内置了 Python,全局注入可能会产生指令冲突。建议新手保持未勾选状态。在需要运行 Conda 命令时,直接使用安装后附带的“Anaconda Prompt”即可,它会自动注入专有环境而不会污染全局操作系统。Register Anaconda3 as my default Python 3.x:将 Anaconda 注册为系统默认的 Python 运行时。此项保持默认勾选,能让系统上的开发工具(如 VS Code、PyCharm)自动识别到该解释器。
四、验证安装与环境初始化
安装完成后,点击“Finish”关闭安装程序。我们需要验证安装是否完全成功。
1. 打开终端工具
在 Windows 系统中,点击任务栏“开始”菜单,在搜索框中输入 Anaconda Prompt,在搜索结果中点击打开。打开后会看到一个黑底终端,命令行开头带有 (base) 字样。如果在 macOS 或 Linux 系统下,打开系统自带的 Terminal 终端即可。
2. 执行版本验证命令
在终端中依次输入以下两条命令并按回车运行:
conda --version
python --version
运行后终端会分别输出类似以下格式的版本信息:
# 示例输出:
conda 24.1.2
Python 3.11.7
如果两条命令均能正常打印出版本号,且没有报错,说明 Anaconda 的核心运行时与包管理器已经就绪。
五、为什么不要在 base 环境写代码:搭建隔离虚拟环境
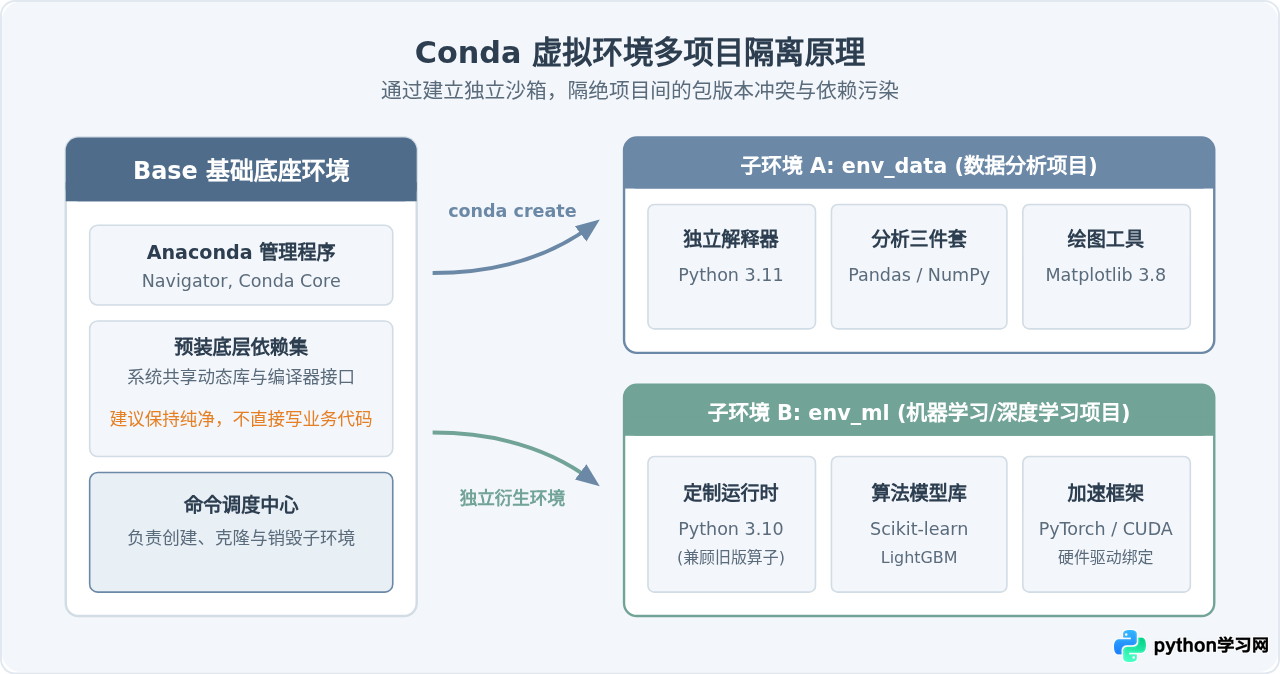
很多新手初次使用 Anaconda 时,会直接在默认的 (base) 环境下使用 pip install 随意安装各种库。随着学习的深入,不同教程或项目所依赖的库版本经常互不兼容(例如某些早期教程要求特定版本的 Pandas 1.x,而新框架需要 Pandas 2.x)。如果所有库都混在 base 环境中,不仅容易导致依赖混乱,一旦系统包损坏,重装整个 Anaconda 会耗费大量时间。
Conda 最强大的能力在于环境隔离机制。我们可以为每一个独立的研究项目、练习作业创建一个干净的沙箱环境。
实战:创建并配置一个数据科学专用虚拟环境
按照以下四个标准步骤,我们可以新建一个名为 datascience、基于 Python 3.11 的专属工作区:
第一步:创建虚拟环境
在 Anaconda Prompt 中输入以下命令,按回车后,系统会计算基础包的依赖关系并询问 Proceed ([y]/n)?,输入 y 并回车确认:
conda create -n datascience python=3.11第二步:激活新创建的环境
conda activate datascience激活成功后,终端行首的括号提示符会从 (base) 自动变为 (datascience),代表当前执行的所有指令和安装的所有依赖都仅对该环境生效。
第三步:在新环境中安装数据科学核心库与 Jupyter
conda install numpy pandas matplotlib seaborn scikit-learn jupyterConda 会自动下载这些库及其适配的底层动态链接库。安装完成后,我们的专属数据科学环境就已配置完毕。
六、验证与运行:使用 Jupyter Notebook 进行第一次数据分析
数据科学领域最普及的交互开发环境是 Jupyter Notebook。它允许将文字说明、可运行的代码单元格(Cell)以及生成的图表可视化集成在同一个页面中展示。
1. 启动 Jupyter Notebook 服务
确保当前终端处于刚激活的虚拟环境 (datascience) 下,输入启动指令:
jupyter notebook终端会输出本地服务的运行日志,并自动唤起默认网页浏览器打开 Notebook 控制台页面(通常地址为 http://localhost:8888/tree)。
2. 创建并运行第一个 Notebook 文件
- 在页面右上角点击“New”按钮,在下拉菜单中选择“Python 3 (ipykernel)”,浏览器将打开一个新的标签页。
- 在第一个代码单元格中,输入以下用于测试环境完整性的数据分析代码:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 构造一组包含随机波动的模拟业务销售数据
np.random.seed(42)
dates = pd.date_range(start="2026-01-01", periods=10, freq="D")
sales = np.random.randint(100, 300, size=10) + np.linspace(10, 50, 10)

# 封装为 Pandas DataFrame
df = pd.DataFrame({"日期": dates, "销量": sales})

# 输出描述性统计信息与表格
print("数据概览:")
print(df.head())
print("\n描述统计:")
print(df.describe())

# 绘制折线趋势图
plt.figure(figsize=(8, 4))
plt.plot(df["日期"], df["销量"], marker="o", color="#6B88A6", linewidth=2)
plt.title("2026年1月模拟销售趋势分析")
plt.xlabel("日期")
plt.ylabel("销量 (单位: 件)")
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
输入完成后,点击工具栏上的“Run”按钮(或直接按下组合快捷键 Shift + Enter)。如果能够在单元格下方清晰看到打印的 DataFrame 结构化表格以及渲染出的折线图表,说明 Python 解释器、Pandas 数据处理库与 Matplotlib 可视化组件均已全部打通,数据科学基础环境搭建圆满完成。
关闭提示:完成分析后,可以在网页中点击“File” -> “Save and Checkpoint”保存文件。回到启动 Jupyter 的终端窗口,连按两次快捷键 Ctrl + C 即可安全停止 Notebook 服务的后台监听。
七、新手常见报错与故障排除指南
1. 报错:'conda' 不是内部或外部命令,也不是可运行的程序
原因:如果在系统的普通“命令提示符(cmd.exe)”或 PowerShell 中直接输入 conda,由于安装时未将 Anaconda 添加至系统 PATH,系统无法检索到该二进制文件。
解决方法:初学者无需手动去修改危险的全局系统环境变量,只需直接在“开始菜单”中点击使用专有的 Anaconda Prompt 即可。如果确实需要在全局 PowerShell 中使用,可以在开始菜单中以管理员身份打开 PowerShell,执行一次 conda init powershell 命令,重启终端后即可原生支持。
2. 下载第三方库或创建环境时网络超时(CondaHTTPError)
原因:默认情况下 Conda 连接的是位于海外的 Anaconda 官方通道服务器,网络连接不稳定时容易出现传输中断。
解决方法:可以将下载源切换为国内高速镜像(如清华镜像站)。在终端中依次执行以下三行命令,将镜像地址写入当前用户的 .condarc 配置文件:
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main/
conda config --set show_channel_urls yes
3. 安装路径中误输入中文或空格导致 DLL 加载失败
现象:导入 numpy 或 scipy 时抛出 ImportError: DLL load failed: 找不到指定的模块。
解决方法:这是由于底层 C 扩展无法处理非 ASCII 路径所致。不要尝试通过各种复杂的改注册表修补方案,最干净彻底的方案是进入系统“控制面板” -> “卸载程序”,将 Anaconda 彻底卸载,重新安装时手动指定形如 C:\anaconda3 的全英文无空格目录。
八、日常环境管理高频命令速查
下表与图示总结了在数据科学日常学习和开发中,最常使用的 Conda 环境管理与运维命令体系:
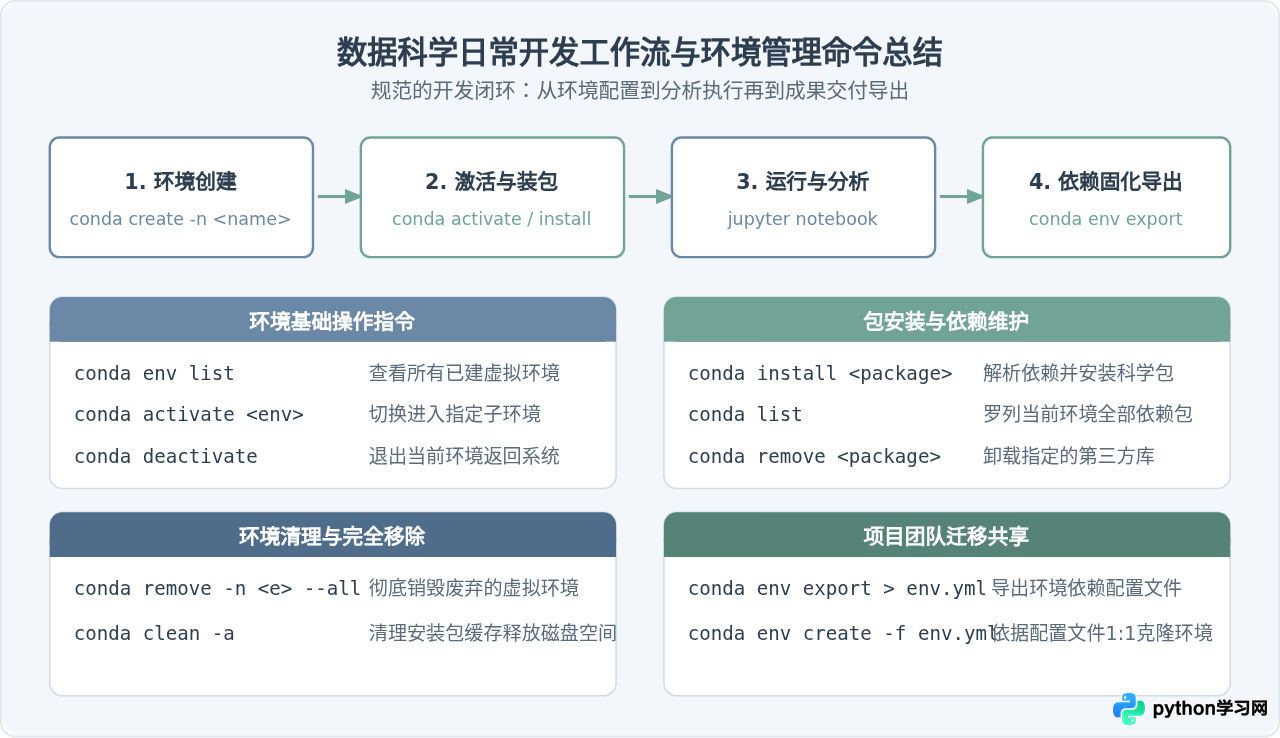
| 分类 | 常用命令 | 作用说明 |
|---|---|---|
| 环境管理 | conda create -n <env_name> python=3.11 |
创建一个指定 Python 版本的新虚拟环境 |
| 环境切换 | conda activate <env_name> |
激活并切换到指定的虚拟环境 |
| 退出环境 | conda deactivate |
退出当前激活的虚拟环境,回到 base 环境 |
| 依赖查询 | conda list |
查看当前虚拟环境中已经安装的所有软件和第三方库 |
| 安装依赖 | conda install <package_name> |
通过 Conda 依赖解析器下载并安装指定第三方库 |
| 跨平台复现 | conda env export > environment.yml |
将当前环境全部包配置导出为清单,方便与他人共享或在新电脑快速复现 |
只要按照上述流程规范操作,避免路径中文、合理利用独立的 Conda 虚拟环境,并使用 Jupyter Notebook 开展日常实验,就能为后续的数据探索、机器学习建模与科研计算建立一个稳固、规范且易于维护的高效工作空间。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















