


Python PaddleOCR中文识别准确率优化与实战指南
针对Python PaddleOCR在中文文字识别中的漏检、误检、断字和形近字混淆问题,本文系统拆解检测、方向分类与识别三阶段流水线,提供图像预处理实战、关键参数调优、Mobile与Server模型选型对比以及自定义字典纠错方案。
PaddleOCR 在开箱即用的状态下对排版规范、对比度高的印刷体中文具备优异的识别能力,但在实际业务落地中,面对低分辨率抓拍、光照不均、小字号密集排版、弯曲倾斜或生僻专有名词时,识别准确率往往会出现不同程度的波动。提升识别准确率的核心并不是盲目更换超大模型,而是沿着“输入图像预处理 → 文字区域检测(DBNet)调参 → 文本方向分类校准 → 字符识别(SVTR/CRNN)模型选型与词典约束”这一完整工程链条,逐层定位误差并做针对性调优。本文将围绕这套标准链路,详细拆解核心参数、前置图像优化、模型选型对比以及业务层后处理修正策略。
一、PaddleOCR 核心流水线与误差来源剖析
在动手调整任何代码前,需要理解 PaddleOCR 处理一幅图像的标准流程。系统内部并不是一次性完成文字识别,而是由三个串联的深度学习子模块协作完成:首先是文本检测模型(Text Detection),负责圈定所有潜在文字行的四边形包围框;其次是方向分类器(Direction Classifier),检测被截取出来的文本切片是否颠倒或侧翻并将其旋转正向;最后是文本识别模型(Text Recognition),逐像素分析切片特征并输出字符序列及置信度得分。
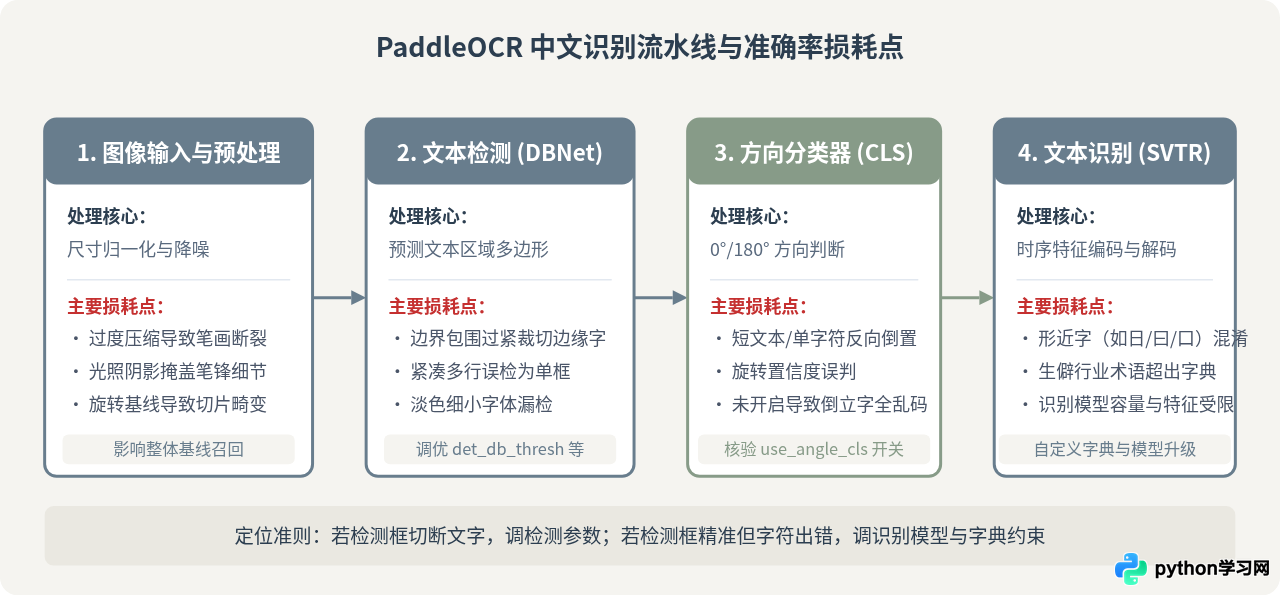
从上图可知,最终呈现给用户的文本错误,其源头可能分散在任一环节。如果文本检测阶段给出的框过紧,切掉了汉字的偏旁部首,后面的识别模型哪怕能力再强也只能输出错别字;如果图片本身拍摄有明显倾斜而方向分类器未起作用,识别模型就会在倾斜序列上产生大量不可预知的乱码。因此,排查准确率问题时,必须分离验证检测结果与识别结果。
二、基础环境搭建与基线识别脚本
进行准确率调优前,先建立一套受控的基准测试代码。使用清华镜像源安装 CPU 或 GPU 版本的 PaddlePaddle 与 PaddleOCR 依赖包:
# CPU 版本安装
pip install paddlepaddle -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install paddleocr -i https://pypi.tuna.tsinghua.edu.cn/simple

# 若具备 NVIDIA GPU(CUDA 11.8 环境示例)
# pip install paddlepaddle-gpu==2.6.1 -i https://pypi.tuna.tsinghua.edu.cn/simple
编写基准推理脚本,显式打印出检测框位置、识别字符及其置信度分数:
from paddleocr import PaddleOCR

# 初始化基线模型
# use_angle_cls=True 开启方向分类器,保证倾斜翻转文本能够自动回正
ocr = PaddleOCR(
    use_angle_cls=True,
    lang='ch',
    ocr_version='PP-OCRv4',
    show_log=False
)

image_path = 'sample_invoice.jpg'
results = ocr.ocr(image_path, cls=True)

# 结构化遍历输出
for idx, page in enumerate(results):
    for line in page:
        box, (text, score) = line
        print(f"坐标: {box} | 识别文本: {text} | 置信度: {score:.4f}")
输出中 score 介于 0.0 到 1.0 之间。在标准质量图像下,有效文本的置信度通常在 0.90 以上。当出现识别错误时,观察其置信度值:若置信度低于 0.75,通常意味着图像质量差或模型特征提取困难;若置信度很高(例如 0.96)但字依然错,通常属于“形近字混淆”或“词典语义先验偏差”。
三、图像输入预处理实战优化
在不重新训练深度学习模型的前提下,最直接、最具成本效益的准确率提升手段是对输入图像进行前置处理。OCR 识别引擎本质上是卷积神经网络与注意力机制的结合,对于对比度低、光照渐变和高频杂斑非常敏感。
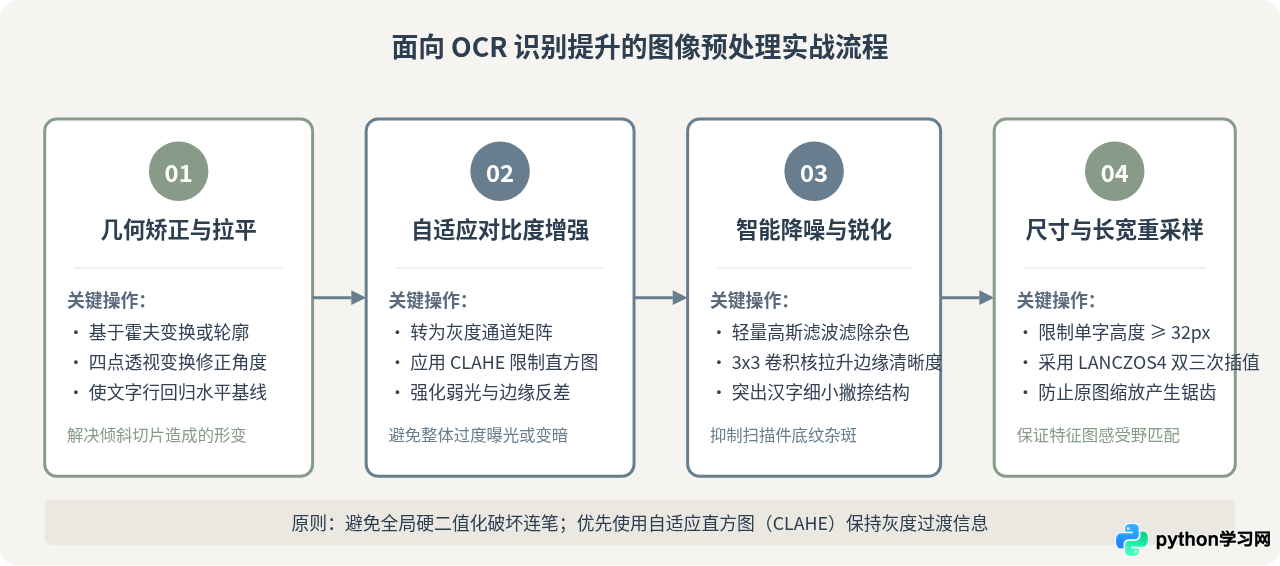
1. CLAHE 局部自适应直方图均衡化
传统的全局直方图均衡化容易使背景较亮的地方产生过曝,导致浅灰色细笔画直接丢失。通过 CLAHE(Contrast Limited Adaptive Histogram Equalization)可以局部按块计算直方图,既拉开了文字与纸张背景的对比度,又限制了噪声放大的上限:
import cv2
import numpy as np

def enhance_text_contrast(image_path):
    img = cv2.imread(image_path)
    # 转为 LAB 色彩空间,仅对亮度通道 L 进行均衡化
    lab = cv2.cvtColor(img, cv2.COLOR_BGR2LAB)
    l, a, b = cv2.split(lab)

    # clipLimit 控制对比度增益,tileGridSize 为局部网格大小
    clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
    cl = clahe.apply(l)

    merged = cv2.merge((cl, a, b))
    enhanced = cv2.cvtColor(merged, cv2.COLOR_LAB2BGR)
    return enhanced
2. 图像尺寸与抗锯齿重采样
PP-OCRv4 文本识别模型训练时输入图片的高固定为 48 像素。若原图中文字的高度不足 15 像素,送入模型后会被强行放大,导致严重的模糊与插值伪影。在预处理阶段,若图片中文字过小,建议先按比例等比缩放整个图像,使得字符行高度稳定在 32 到 48 像素区间内:
def scale_image_properly(img, min_height=1000):
    h, w = img.shape[:2]
    if h < min_height:
        scale = min_height / float(h)
        # 放大时推荐使用 cv2.INTER_CUBIC 或 INTER_LANCZOS4 保持笔画边缘锐利
        img_scaled = cv2.resize(img, (int(w * scale), min_height), interpolation=cv2.INTER_LANCZOS4)
        return img_scaled
    return img
四、文本检测阶段(DBNet)关键参数精调
DBNet(Real-time Scene Text Detection with Differentiable Binarization)是 PaddleOCR 检测模块的核心算法。检测模块如果切错或者漏切,识别模块就彻底没有输入。在初始化 PaddleOCR() 时,有四个极为关键的检测参数直接决定文本召回率:
| 参数名 | 默认值 | 推荐调整范围 | 调优逻辑与影响 |
|---|---|---|---|
det_db_thresh |
0.3 | 0.15 ~ 0.40 | 二值化概率图的分割阈值。若出现浅色字、水印下文字被漏检,降至 0.20;若背景杂乱误报多,提至 0.35。 |
det_db_box_thresh |
0.6 | 0.50 ~ 0.70 | 多边形框内所有像素的平均置信度门限。调低(如 0.5)可强制召回极不清晰的弱文本,但容易检出纹理伪文字。 |
det_db_unclip_ratio |
1.5 | 1.6 ~ 2.2 | Vatti 裁剪算法的外扩膨胀系数。若识别出来的文本总是丢失首尾字符或偏旁被切断,务必将其调大至 1.8 ~ 2.0。 |
det_limit_side_len |
960 | 1280 ~ 2560 | 检测前图像最长边的上限。默认 960px 遇到高分辨率扫描发票会将文字缩成微粒导致漏检,高分扫描件应设为 1920 或更高。 |
det_db_unclip_ratio 从 1.5 调至 1.8 或 2.0,可以让检测框向外扩张 20%~30%,完整包覆笔画。
五、选型对比:PP-OCRv4 Mobile 与 Server 模型深度权衡
很多开发者在项目中习惯直接使用默认的轻量版模型(Mobile),但在追求高准确率的业务场景中,模型本身的容量与架构选择起着决定性作用。下面我们在相同的硬件与测试场景下,对比 PP-OCRv4 Mobile 与 PP-OCRv4 Server 两套方案的核心差异。
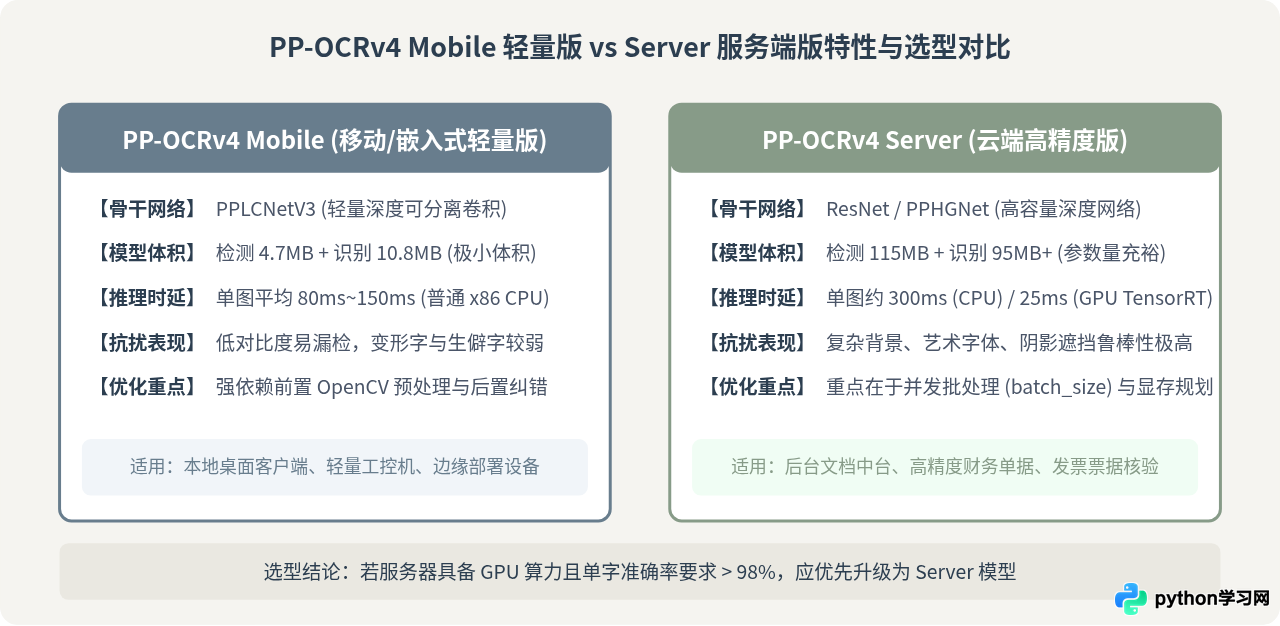
两者的关键差异为什么重要?
差异的核心在于特征表达容量(Model Capacity)。Mobile 模型为了保证能在手机 CPU 上以毫秒级运行,使用了极致压缩的轻量骨干(如 PPLCNetV3),其卷积通道数较少,对汉字复杂笔画的高阶拓扑结构建模能力有限。当面对清晰度尚可但排版密集的汉字时,Mobile 模型容易发生笔画粘连性错认;而 Server 版本的特征图通道数扩充了数倍,在复杂纹理背景下仍能精准解耦前景文字与背景噪声。
在 Python 中调用 Server 模型非常简单,只需通过参数显式指定官方预训练权重路径,或者传入 det_model_dir 和 rec_model_dir 本地权重目录:
from paddleocr import PaddleOCR

# 切换为 Server 高精度模型进行推理
ocr_server = PaddleOCR(
    use_angle_cls=True,
    lang='ch',
    # 指定官方下载解压后的 Server 模型推理目录
    det_model_dir='./models/ch_PP-OCRv4_det_server_infer/',
    rec_model_dir='./models/ch_PP-OCRv4_rec_server_infer/',
    cls_model_dir='./models/ch_ppocr_mobile_v2.0_cls_infer/',
    use_gpu=True,
    show_log=False
)
六、识别阶段深度调优:自定义字符字典与后处理纠错
文本识别模块采用的是基于 CTC 或 Attention 的字符分类解码。PaddleOCR 中文字典默认包含 6623 个汉字和符号。在许多 vertical 垂直行业(例如医疗、金融、制造业质检)中,经常出现不常用的生僻汉字、特殊单位符号或定制字符,这些字符一旦不在字典内,模型无论如何都无法输出正确字符。
1. 挂载自定义字符集字典
你可以从官方仓库复制 ppocr_keys_v1.txt,将业务中缺失的生僻字、特殊标点逐行追加到文件末尾,随后在初始化时通过 rec_char_dict_path 指定自定义字典路径:
ocr = PaddleOCR(
    lang='ch',
    ocr_version='PP-OCRv4',
    rec_char_dict_path='./custom_dict/my_ch_keys.txt',
    show_log=False
)2. 基于业务规则与编辑距离(Levenshtein)的后处理修正
很多汉字在视觉上高度相似,例如“日”与“曰”、“未”与“末”、“己”与“已”。单纯从视觉特征区分非常困难,但在特定业务字段中,其词义具备强确定性。利用词表约束与编辑距离算法做后置校正,是业界通用的兜底手段:
import re

def correct_business_terms(raw_text):
    # 建立确定性业务白名单映射表
    correction_map = {
        "开户行政": "开户行政",
        "合司名称": "公司名称",
        "纳税人识别号": "纳税人识别号",
        "发祟代码": "发票代码"
    }

    corrected = raw_text
    for error_pattern, target in correction_map.items():
        corrected = corrected.replace(error_pattern, target)

    # 针对固定格式字段(如手机号、统一社会信用代码)进行正则清洗
    # 去除因误检夹杂在数字中间的空格或类似字符
    if "信用代码" in corrected:
        corrected = re.sub(r'[^A-Z0-9\u4e00-\u9fa5]', '', corrected)

    return corrected
七、实战优化汇总与故障排查清单
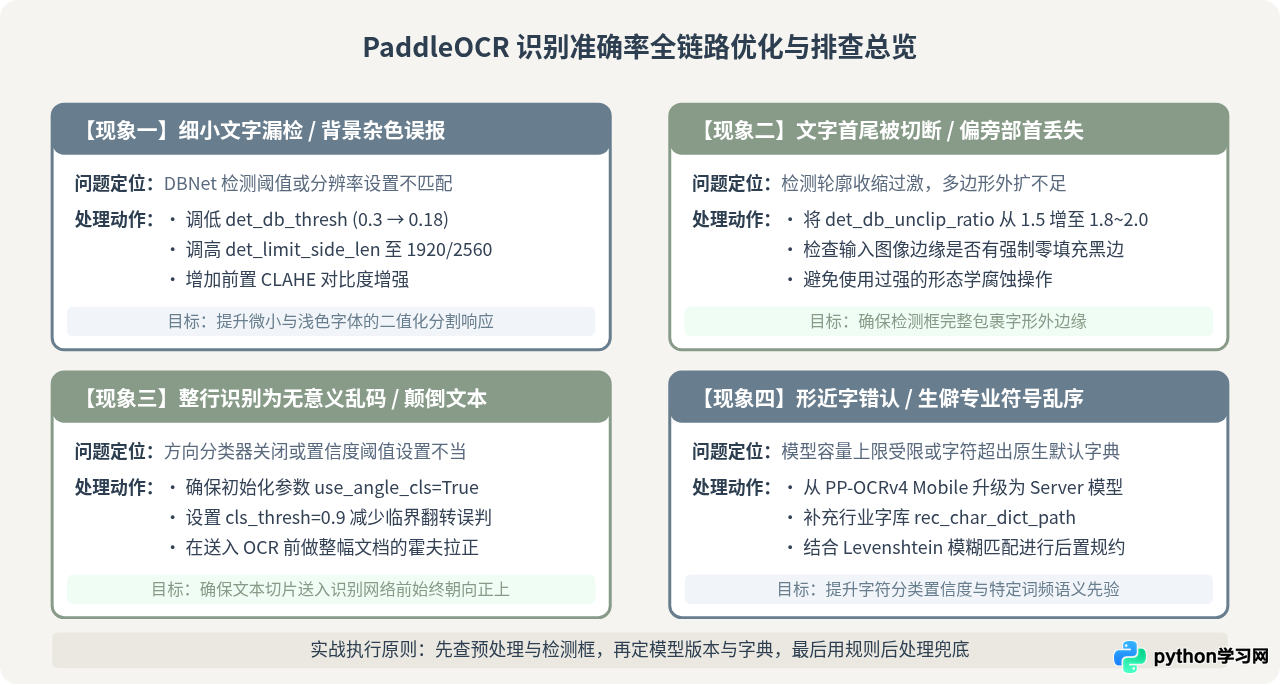
为了让排查过程系统化,我们将常见识别缺陷归纳为四大典型表现,并对应到底层模块和具体的参数调整动作:
八、综合优化实战代码示例
以下代码整合了上述所有优化手段:包含 OpenCV 预处理流水线、经过调校的 DBNet 检测参数、方向校正开关以及后处理业务词纠正:
import cv2
import numpy as np
from paddleocr import PaddleOCR

class OptimizedPaddleOCR:
    def __init__(self, use_server=False):
        # 调优后的检测与识别核心参数配置
        ocr_config = {
            "use_angle_cls": True,
            "lang": "ch",
            "ocr_version": "PP-OCRv4",
            "det_db_thresh": 0.20,         # 降低二值化阈值,提升弱文字召回
            "det_db_box_thresh": 0.55,     # 略微降低文本框门限
            "det_db_unclip_ratio": 1.85,    # 扩大边界膨胀,防止截断偏旁
            "det_limit_side_len": 1920,    # 扩大最长边限制,保护高分扫描件小字
            "show_log": False
        }

        if use_server:
            # 挂载高精度 Server 模型目录示例
            ocr_config.update({
                "det_model_dir": "./models/ch_PP-OCRv4_det_server_infer/",
                "rec_model_dir": "./models/ch_PP-OCRv4_rec_server_infer/"
            })

        self.engine = PaddleOCR(**ocr_config)

    def preprocess(self, img_path):
        """输入图像增强流水线"""
        img = cv2.imread(img_path)
        if img is None:
            raise FileNotFoundError(f"无法读取输入图片: {img_path}")

        # 1. 尺度规范化(保证单字足够大)
        h, w = img.shape[:2]
        if max(h, w) < 1200:
            scale = 1200.0 / max(h, w)
            img = cv2.resize(img, (int(w * scale), int(h * scale)), interpolation=cv2.INTER_LANCZOS4)

        # 2. 自适应局部直方图均衡化(CLAHE)
        lab = cv2.cvtColor(img, cv2.COLOR_BGR2LAB)
        l, a, b = cv2.split(lab)
        clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
        l_enhanced = clahe.apply(l)
        enhanced_bgr = cv2.cvtColor(cv2.merge((l_enhanced, a, b)), cv2.COLOR_LAB2BGR)

        # 3. 轻微拉普拉斯边缘锐化
        kernel = np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]], dtype=np.float32)
        sharpened = cv2.filter2D(enhanced_bgr, -1, kernel)
        return sharpened

    def postprocess_text(self, text):
        """业务层规则校正"""
        # 常见 OCR 视觉歧义词替换表
        fixes = {
            "口期": "日期",
            "金颜": "金额",
            "合司": "公司",
            "帐号": "账号"
        }
        for wrong, right in fixes.items():
            text = text.replace(wrong, right)
        return text

    def run(self, image_path):
        processed_img = self.preprocess(image_path)
        # 直接传入经过内存处理的 NumPy 图像数组
        raw_result = self.engine.ocr(processed_img, cls=True)

        clean_results = []
        if raw_result and raw_result[0]:
            for line in raw_result[0]:
                box, (raw_text, confidence) = line
                fixed_text = self.postprocess_text(raw_text)
                clean_results.append({
                    "box": box,
                    "text": fixed_text,
                    "confidence": round(confidence, 4)
                })
        return clean_results

# 调用执行示例
if __name__ == "__main__":
    runner = OptimizedPaddleOCR(use_server=False)
    output = runner.run("sample_test.png")
    for item in output:
        print(f"[{item['confidence']}] {item['text']}")
通过这套工程方案,在不需要从头收集数万张数据集重训深度模型的条件下,仅凭合理的 OpenCV 前置画质重构、DBNet 检测参数调优(特别是 det_db_unclip_ratio 与 det_db_thresh)、按需升级 Server 模型并在出口施加规则纠偏,通常即可解决 90% 以上实际业务中的中文识别准确率问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















