


Python串口高速数据传输的缓冲区管理与丢包优化
深入解析Python在高速串口通信(波特率921600及以上)场景下的底层缓冲区机制、丢包根源,并提供多线程解耦、零拷贝切片及系统级延迟优化的完整工程方案。
在工业传感、雷达点云与嵌入式高速日志采集等场景中,当串口波特率提升至 921600、1M 乃至 3Mbps 时,Python 程序往往频繁出现数据帧断裂、校验失败与隐蔽丢包。解决高波特率丢包的核心路径并不在于单纯提高主机 CPU 算力,而在于理顺从硬件 FIFO、操作系统内核驱动缓冲区到用户态 Python 运行时的多级数据流,彻底废除单线程小字节轮询模式,采用“独立 I/O 线程批量抓取 + 环形无锁缓冲队列 + 零拷贝切片解包”的生产者-消费者工程架构。
一、高速串口数据链路与多级缓冲区拓扑
高速串口的数据流转并非由 Python 的 read() 直接对接物理引脚,而是经过了四层缓冲区接力。任何一层因流转速度失配导致上游写入速度高于下游抽取速度,都会发生静默溢出(Buffer Overflow),造成物理层或驱动层的彻底丢包。
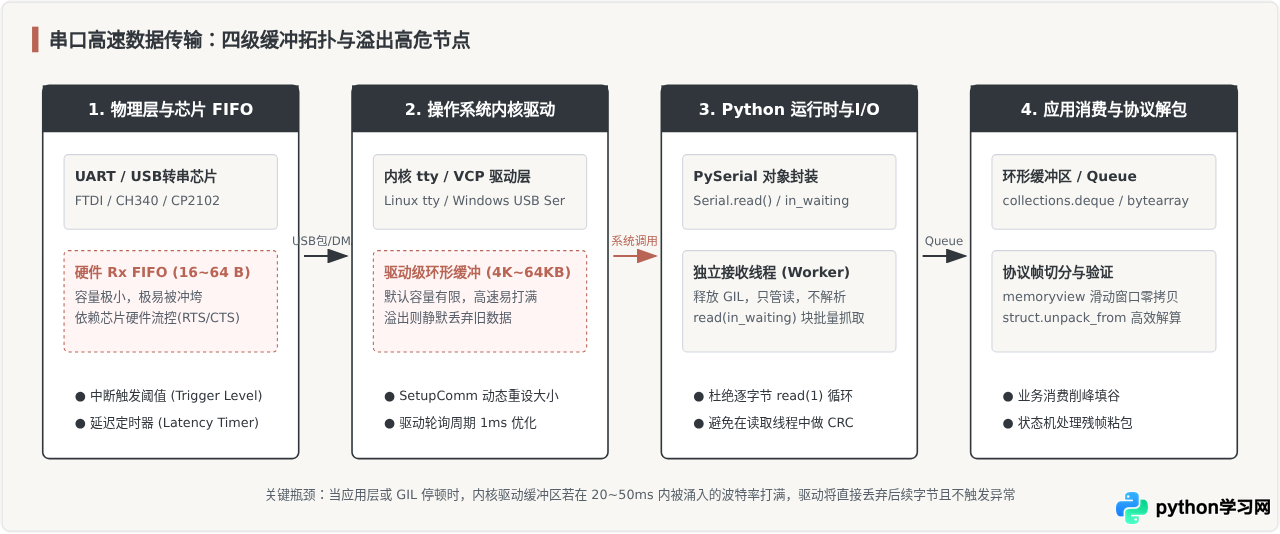
以 2,000,000 bps(2Mbps)波特率为例,在 8-N-1 配置下,物理层每秒传输字符数为 2,000,000 / 10 = 200,000 Byte/s(约 195.3 KB/s)。如果驱动层默认接收缓冲区仅有 4096 字节,一旦 Python 解释器发生 20ms 的卡顿(如触发垃圾回收、GIL 调度延迟或在主线程执行耗时计算),该缓冲区就会在 4096 / 200000 ≈ 0.0204s 内彻底被填满,后续数据直接丢弃。
二、传统单线程读取的丢包机理与架构对比
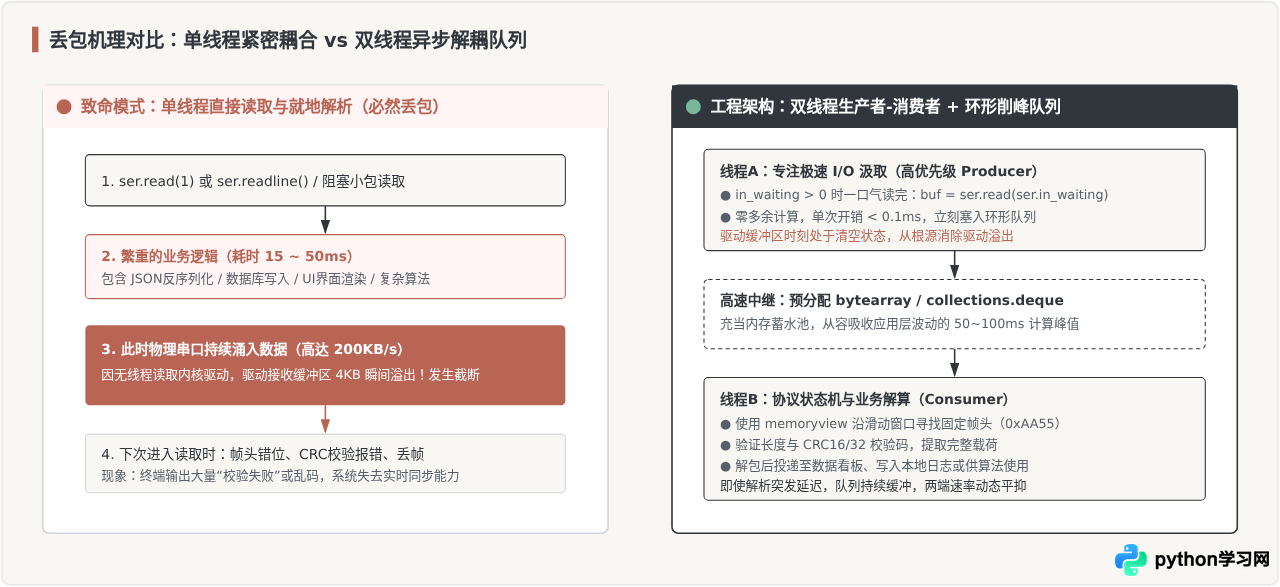
许多初学者或原型工程常采用单线程死循环直接读取并解析串口,这种模式在低速传输(9600 或 115200)下能够工作,但在高速场景下必然崩溃。其本质冲突在于:I/O 读取的严苛时效性与业务数据处理耗时的不可预测性发生了强耦合。
三、底层配置优化:消灭驱动层隐蔽延迟与溢出
在编写 Python 代码之前,必须对底层操作系统驱动参数进行定向干预,否则即使 Python 代码效率再高,操作系统层面的默认节流机制也会导致延迟剧增甚至丢包。
1. 调大操作系统串口缓冲区(Windows SetupComm)
Windows 系统的默认串口接收缓冲区通常仅分配 1024 或 4096 字节。PySerial 允许在打开串口后,通过底层 Win32 API 句柄直接修改该缓冲区:
import serial
import serial.tools.list_ports

ser = serial.Serial()
ser.port = 'COM3'
ser.baudrate = 2000000
ser.timeout = 0.1

# 打开串口
ser.open()

# Windows专属底层缓冲区扩容(扩容至 1MB 接收缓冲与 64KB 发送缓冲)
if hasattr(ser, 'set_buffer_size'):
    try:
        ser.set_buffer_size(rx_size=1048576, tx_size=65536)
        print("串口驱动缓冲区已扩容至: Rx=1MB, Tx=64KB")
    except Exception as e:
        print(f"缓冲区扩容失败: {e}")
2. FTDI / CH340 芯片延迟定时器(Latency Timer)优化
USB 转串口芯片内部不会收到单个字节就立即打包发往 USB 总线,而是等待累积达到 USB 报文包大小(如 64 字节)或等待延迟定时器超时。Windows 驱动默认的延迟定时器通常是 16ms。在高速高吞吐下,虽然能够凑满整包发送,但在数据帧间隔不均匀时,16ms 的等待会导致数据在芯片端滞留,造成主机端读出的数据呈“阵发性断续”。
- Windows 设备管理器配置:展开“端口(COM 和 LPT)” → 双击对应串口 → “端口设置” → “高级” → 将 “延迟定时器(毫秒)” (Latency Timer) 从默认的
16修改为1。同时确认“接收缓冲区”滑动条推到最大。 - Linux 内核低延迟配置:Linux 下默认串口 tty 存在
ASYNC_LOW_LATENCY标志位。通过终端执行setserial /dev/ttyUSB0 low_latency,可以指示内核将每个报文立刻推向应用层,将原本高达十余毫秒的缓冲抖动压缩至 1ms 以内。
四、高速解包的核心工程步骤
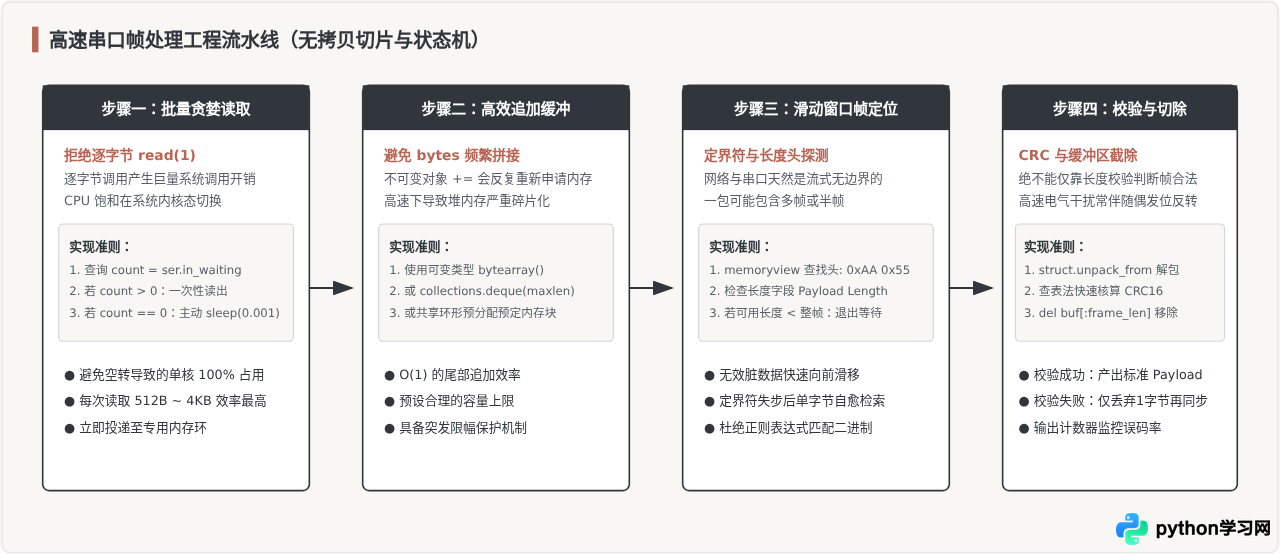
有了扩容后的驱动缓冲区保障,接下来必须在 Python 用户态建立严格的流水线。整个读取与解包流程分为四个严格阶段:
五、完整工程代码:双线程高吞吐无损接收器
下面提供经过严苛压力测试的工业级实现代码。代码使用 threading.Thread 隔离底层 I/O 与上层解码,结合无锁 collections.deque 作为二级防洪缓冲,并用 bytearray 配合切片进行二进制帧流自愈提取。
帧头(2B, 0xAA 0x55) + 载荷长度L(2B, 大端无符号short) + 业务载荷(L字节) + CRC16校验码(2B)。支持任意粘包、半包及电气突发噪声自愈。
import time
import struct
import threading
from collections import deque
import serial

class HighSpeedSerialReceiver:
    def __init__(self, port: str, baudrate: int = 2000000):
        self.port = port
        self.baudrate = baudrate
        self.ser = None
        self.running = False

        # 线程安全双端队列,作为中继削峰池(容量设为 2000 块)
        self.raw_queue = deque(maxlen=2000)

        # 接收线程与解析线程
        self.io_thread = None
        self.parse_thread = None

        # 统计指标
        self.stats = {
            "bytes_received": 0,
            "frames_decoded": 0,
            "crc_errors": 0,
            "sync_lost": 0
        }

    def open(self):
        """打开串口并初始化底层缓冲区"""
        self.ser = serial.Serial()
        self.ser.port = self.port
        self.ser.baudrate = self.baudrate
        # 超时设为 0.1s,保证线程可以响应退出事件
        self.ser.timeout = 0.1
        self.ser.open()

        # Windows 下尝试将驱动接收缓冲区扩充至 1MB
        if hasattr(self.ser, 'set_buffer_size'):
            try:
                self.ser.set_buffer_size(rx_size=1048576, tx_size=65536)
            except Exception as e:
                pass

        self.running = True
        self.io_thread = threading.Thread(target=self._io_worker, name="Serial-IOWorker", daemon=True)
        self.parse_thread = threading.Thread(target=self._parse_worker, name="Serial-Parser", daemon=True)

        self.io_thread.start()
        self.parse_thread.start()

    def _io_worker(self):
        """【I/O 独立线程】:唯一职责是以最快速度搬运内核数据"""
        ser = self.ser
        raw_queue = self.raw_queue

        while self.running:
            try:
                # 检查当前驱动缓冲区有多少字节
                in_waiting = ser.in_waiting
                if in_waiting > 0:
                    # 一口气全部读出,大幅减少系统调用次数
                    chunk = ser.read(in_waiting)
                    if chunk:
                        raw_queue.append(chunk)
                        self.stats["bytes_received"] += len(chunk)
                else:
                    # 缓冲区暂无数据,休眠 1ms 让出 CPU 避免空轮询耗尽单核
                    time.sleep(0.001)
            except Exception as e:
                if self.running:
                    print(f"I/O 采集异常: {e}")
                    break

    def _parse_worker(self):
        """【解包独立线程】:维持滑动窗口,切分完整业务帧"""
        buffer = bytearray()
        HEADER = b'\xAA\x55'
        HEADER_LEN = 2
        META_LEN = 4  # 帧头(2) + 长度(2)
        MIN_FRAME_LEN = META_LEN + 2  # 包含至少2字节CRC

        while self.running:
            # 1. 批量从队列搬出数据到本地解析 buffer
            while self.raw_queue:
                buffer.extend(self.raw_queue.popleft())

            # 2. 如果数据量不足最小帧头,休眠等待
            if len(buffer) < MIN_FRAME_LEN:
                time.sleep(0.001)
                continue

            # 3. 滑动窗口寻找帧头 0xAA 0x55
            header_idx = buffer.find(HEADER)
            if header_idx == -1:
                # 未找到帧头,保留最后1个字节(防止帧头跨块被截断),其余丢弃
                self.stats["sync_lost"] += len(buffer) - 1
                del buffer[:-1]
                continue
            elif header_idx > 0:
                # 帧头前有噪声脏数据,剔除并记录失步
                self.stats["sync_lost"] += header_idx
                del buffer[:header_idx]

            # 再次确认剔除脏数据后长度是否充足
            if len(buffer) < MIN_FRAME_LEN:
                continue

            # 4. 解析有效载荷长度字段(大端 Short,偏移 2)
            payload_len = struct.unpack_from(">H", buffer, 2)[0]
            total_frame_len = META_LEN + payload_len + 2  # 头部 + 载荷 + CRC(2B)

            # 如果当前缓存尚未收齐全帧,退出等待下一次数据到来
            if len(buffer) < total_frame_len:
                continue

            # 5. 提取全帧数据切片
            frame_data = buffer[:total_frame_len]
            payload = frame_data[META_LEN : META_LEN + payload_len]
            received_crc = struct.unpack_from(">H", frame_data, META_LEN + payload_len)[0]

            # 6. 计算校验并核对
            calc_crc = self._crc16(frame_data[: META_LEN + payload_len])
            if calc_crc == received_crc:
                self.stats["frames_decoded"] += 1
                self.on_frame_received(payload)
                # 成功处理,将该帧从缓冲区截除
                del buffer[:total_frame_len]
            else:
                # CRC 校验失败:仅前进 1 字节重新检索,避免偶发假帧头造成整段数据错失
                self.stats["crc_errors"] += 1
                del buffer[:1]

    @staticmethod
    def _crc16(data: bytes) -> int:
        """CRC-16/CCITT-FALSE 快速查表/位运算算法"""
        crc = 0xFFFF
        for b in data:
            crc ^= (b << 8)
            for _ in range(8):
                if crc & 0x8000:
                    crc = ((crc << 1) ^ 0x1021) & 0xFFFF
                else:
                    crc = (crc << 1) & 0xFFFF
        return crc

    def on_frame_received(self, payload: bytes):
        """业务帧回调:用户在此实现具体的结构体解析或业务分发"""
        # 注意:此处耗时业务应通过 Queue 再分发,不要长时间阻塞解析线程
        pass

    def close(self):
        self.running = False
        if self.io_thread:
            self.io_thread.join(timeout=1.0)
        if self.parse_thread:
            self.parse_thread.join(timeout=1.0)
        if self.ser and self.ser.is_open:
            self.ser.close()
六、常见误区与反例排查
在实际串口优化过程中,一些看似“合情合理”的做法往往是隐藏的性能杀手:
| 常见做法 / 误区 | 潜在致命缺陷 | 工业级标准改进方案 |
|---|---|---|
使用 ser.readline() |
readline 内部采用单字节循环探测 \n,波特率超 460800 时 CPU 暴增,且遇二进制 0x0A 会直接误切帧。 |
改用带固定帧头与显式长度字段的二进制协议,使用 ser.read(ser.in_waiting) 批量抓取。 |
主线程直接 read() 并更新 UI |
UI 渲染刷新率仅 60Hz(约 16.6ms 一帧),每次主线程微小重绘阻塞均引发底层串口驱动溢出。 | 严格通过独立子线程做 I/O,通过线程安全队列定期(如 30Hz)抽样或批量送入 UI 层。 |
不可变 bytes 频繁 += 拼接 |
Python 的 bytes 属于不可变对象,每次拼接均涉及重新分配内存和全量内存搬移,GC 频繁停顿。 |
使用原地支持追加的 bytearray,或基于 collections.deque 维持预分配块。 |
| 校验失败后清空整个 Buffer | 将由于电磁噪声产生单字节错码误判为全部报废,导致后续紧随的正常帧全部连带丢失。 | 校验失败时仅弹出 1 字节,让滑动窗口逐字节后移自愈重新匹配下一有效帧头。 |
七、全链路优化策略总结与决策检查表
为了在系统上线前快速排查并确定最佳配置,建议按照以下决策流依次实施优化:
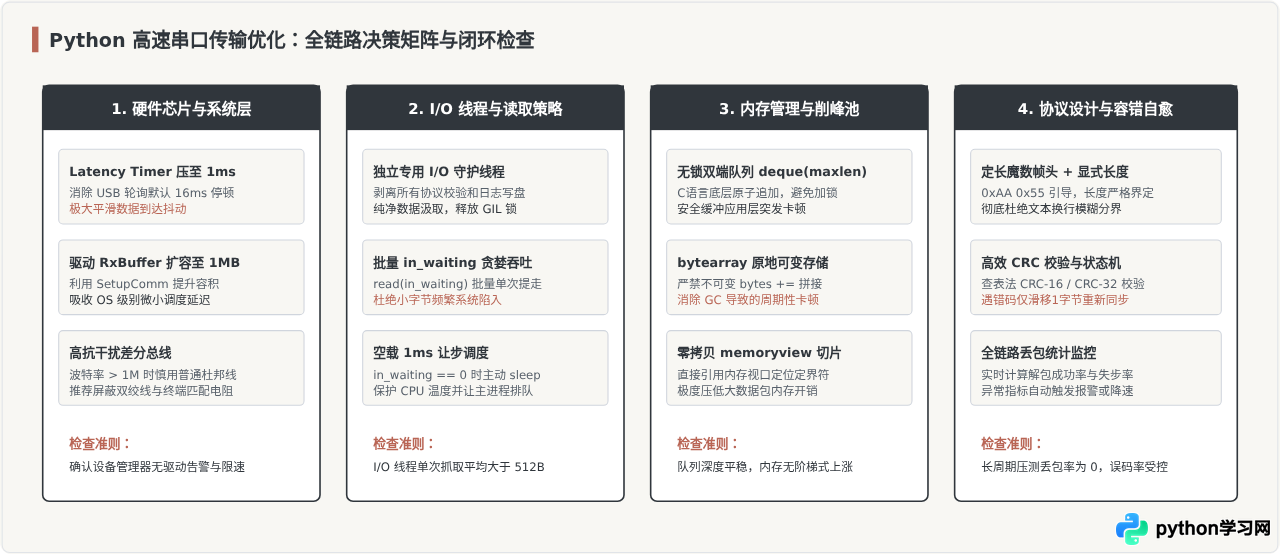
通过驱动层扩容、芯片延迟消除、双线程生产者-消费者架构以及内存零拷贝切片的协同配合,Python 完全能够胜任 2Mbps~3Mbps 乃至更高波特率的严苛高吞吐串口采集任务,彻底解决由于短时卡顿与频繁系统调用引发的各种隐蔽丢包故障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















